
7.095 Fotos: Die Zahl, die über die ByteDance-Bildklage entscheidet | Fanch AI
Siebentausendfünfundneunzig. Nicht „Millionen von Bildern“, nicht „gewaltige Mengen aus dem Internet“ – exakt 7.095 Fotografien. Eine Zahl, die so spezifisch ist, dass sie wie das Ergebnis einer Inventur klingt. Weil sie genau das ist.
Die auf Automobilfotografie spezialisierte Agentur EVOX Productions hat ByteDance vor dem Central District Court von Kalifornien verklagt. Der Vorwurf: Die TikTok-Muttergesellschaft habe diese 7.095 Bilder ohne Erlaubnis kopiert und als KI-Trainingsdaten (AI training data) für ihren Bildgenerator Seedream genutzt. Der Fall EVOX Productions LLC v. Bytedance Inc. et al, Aktenzeichen 5:26-cv-06428, wurde diese Woche von Music Business Worldwide und Digital Music News publik gemacht.
Der reine Vorwurf der unrechtmäßigen Nutzung von KI-Trainingsdaten ist dabei nicht das Bemerkenswerte. Fast jede Urheberrechtsklage gegen KI-Modelle in den vergangenen zwei Jahren stützt sich auf eine Variante dieses Arguments. Was diese Klage potenziell richtungsweisend macht, ist die juristische Mathematik, die sich aus der Art der Formulierung ergibt.
Was die Klageschrift konkret vorwirft
Zunächst zur juristischen Einordnung: Es handelt sich um Behauptungen in einer neu eingereichten Zivilklage, die noch nicht gerichtlich geprüft wurde. ByteDance wurde bislang für keinerlei Vergehen haftbar gemacht.
Der zentrale Vorwurf: Die Automobilfotografien von EVOX wurden aus dem Netz gekratzt (Scraping) und als KI-Trainingsdaten für Seedream, das Bildgenerierungsmodell von ByteDance, verwendet.
Der behauptete Umfang: 7.095 Bilder. Eine im Maßstab von Internet-Datenmengen mikroskopisch kleine Zahl. Und das ist eine bewusste juristische Entscheidung: Es geht hier um ein zählbares, katalogisiertes Set statt um eine amorphe, unbestimmte Masse.
Der Gerichtsstand: Ein kalifornisches Bundesgericht. Der Kläger ist eine LLC aus Delaware, der Beklagte ein Unternehmen aus Delaware, und als Verhandlungsort wurde jener Bezirk gewählt, in dem sich Urteile dieser KI-Rechtskategorie derzeit häufen.
Die Präzedenzlage: Bislang existiert in den USA kein rechtskräftiges Urteil zu KI-Trainingsdaten in dieser spezifischen Form. Der Ausgang wird vom Beweisaufnahmeverfahren (Discovery), der rechtlichen Einstufung der Werke durch das Gericht und von den noch ausstehenden Verteidigungsargumenten seitens ByteDance abhängen.
Warum eine Autofotografie-Agentur der gefährlichste Kläger ist
Dieser Aspekt ist entscheidend, um zu verstehen, warum EVOX für ein KI-Labor ein weitaus gefährlicherer Gegner ist als eine große Tageszeitung oder eine generische Stockbild-Plattform.
Automobilfotografie ist von Natur aus ein strukturierter Katalog. Und strukturierte Kataloge sind das Gold, aus dem hochwertige KI-Trainingsdaten geschürft werden. Standardisierte Kamerawinkel, Modelljahre, Lackfarben, Interieur-Details, Felgendesigns – die Arbeit ist streng systematisch und vollständig aufzählbar. Ein Unternehmen wie EVOX weiß auf den Pixel genau, welche Assets es besitzt, und kann die Urheberschaft jeder einzelnen Datei exakt nachweisen.
Jedes Bild ist einzeln identifizierbar. Physische Wasserzeichen, eingebettete Metadaten (EXIF) und ein absolut konsistenter Beleuchtungsstil machen die Herkunft (Provenance) überprüfbar. Genau dieser Herkunftsnachweis ist der schwächste Punkt in den meisten Klagen um KI-Trainingsdaten. Die größte juristische Hürde besteht meist darin, zweifelsfrei zu beweisen, welche konkreten Werke vom Modell verschluckt wurden. Eine katalogisierte Bibliothek mit sichtbaren Markierungen lässt dieses technische Hindernis in sich zusammenfallen.
Standardisierung skaliert den Schadensersatz. Tausende technisch ähnliche Bilder, von denen jedes einzeln urheberrechtlich registriert ist, ermöglichen eine Klage, die gleichzeitig massiv und leicht detailliert aufzuschlüsseln ist – das genaue Gegenteil eines Nachrichtenverlags, der über ein nicht quantifizierbares Textarchiv streitet.
Das Kerngeschäft ist die Lizenzvergabe. Ein Unternehmen, das sein Geld damit verdient, Bildlizenzen stückweise an Autohändler und Fahrzeugbörsen zu verkaufen, verfügt über das stärkste Argument für einen „Marktschaden“ (Market harm): Das gesamte Erlösmodell des Unternehmens ist exakt das, was ihm angeblich entwendet wurde.
Diese Kombination – zählbar, identifizierbar, lizenzierbar – erklärt, warum der wirkungsvollste Kläger im Streit um KI-Trainingsdaten weniger wie ein Medienkonzern, sondern vielmehr wie eine klassische Bildbibliothek aussieht.
Die Zahl, die den Prozess entscheidet
Hier liegt der juristische Mechanismus, den die meisten allgemeinen Medienberichte übersehen, der aber über den Ausgang der Schlacht entscheidet.
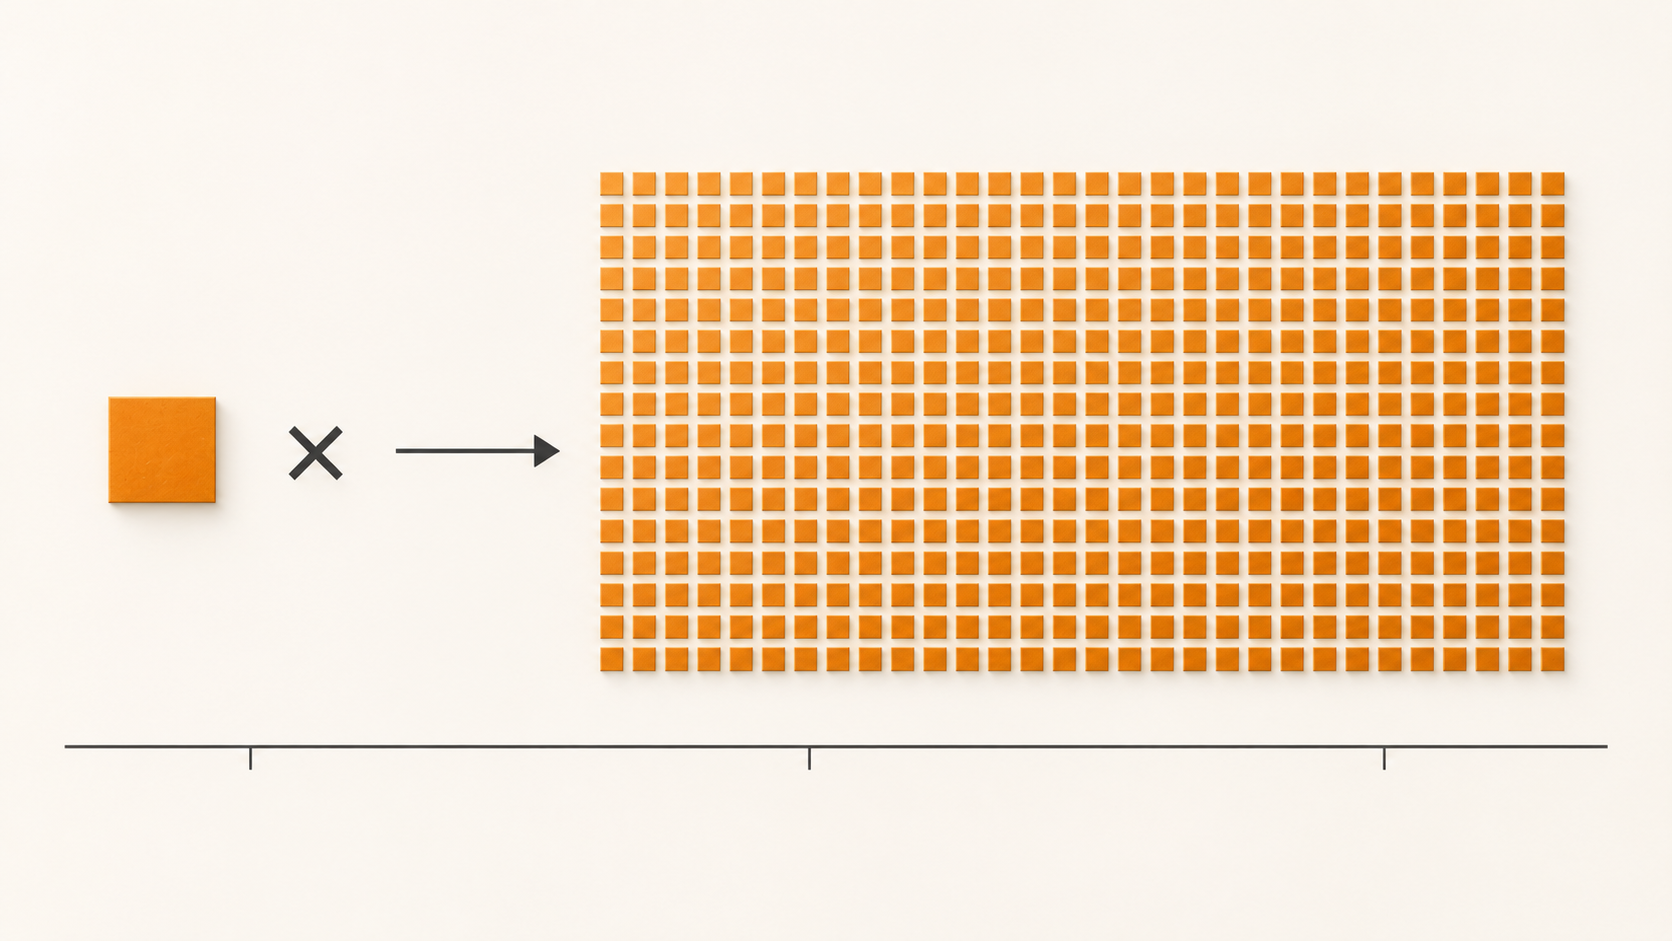
In US-Urheberrechtsstreitigkeiten ist es extrem schwer, den „tatsächlichen wirtschaftlichen Schaden“ (Actual damages), den ein KI-Modell verursacht hat, konkret zu beziffern. Daher greifen Kläger-Anwälte auf den sogenannten gesetzlichen Schadensersatz (Statutory damages) zurück. Der Clou an diesen gesetzlichen Schadensersatzsummen ist, dass sie pro verletztem Werk und nicht als Pauschalsumme für den gesamten Fall verhängt werden. Das finanzielle Risiko für den Beklagten lautet also nicht „Wie viel Schaden wurde angerichtet?“, sondern „Wie viele Werke multipliziert mit dem gesetzlichen Strafrahmen?“. In einem Fall über KI-Trainingsdaten ist dieser Multiplikator das alles entscheidende Argument.
Das bedeutet: Die zentrale Rechtsfrage in diesem Streit um KI-Trainingsdaten lautet nicht, ob die Kopie technisch stattgefunden hat. Die Frage lautet: Zählt jedes einzelne Foto juristisch als separates Werk?
Die Schriftsätze, die EVOX in parallelen Verfahren eingereicht hat, machen diese Strategie überdeutlich: Sie argumentieren, dass jedes einzelne Bild ein eigenständiges Werk darstellt, das Anspruch auf eine eigene gesetzliche Entschädigung hat. In einem dieser Parallelverfahren geht es um Hunderttausende von Bildern. Wendet man diese Logik auf diesen Fall von KI-Trainingsdaten an – wenn auch in kleinerem Maßstab von 7.095 Bildern –, verwandelt die Multiplikation selbst bescheidener Einzelstrafen die Gesamtsumme in einen Betrag mit drastischer Abschreckungswirkung.
Es ist davon auszugehen, dass die Verteidigung von ByteDance das genaue Gegenteil argumentieren wird: Ein kommerzieller Katalog sei faktisch eine einzige „Zusammenstellung“ (Compilation) oder müsse rechtlich als ein einzelnes „Sammelwerk“ (Collective work) behandelt werden, was die Entschädigung drastisch auf eine einzige Zahlung begrenzen würde. Dieser Streit um die Arithmetik – und nicht die Debatte über das Daten-Scraping an sich – bestimmt letztlich die Höhe der Schadensersatzzahlung.
Für jedes Unternehmen, dessen Geschäftsmodell auf der Sammlung von KI-Trainingsdaten basiert, ist genau diese Gerichtsentscheidung der wichtigste Indikator der Branche. Ein Urteil, das besagt, dass jedes Bild in einem massiven Dataset ein eigenständiges Werk ist, das separat entschädigt werden muss, würde das finanzielle Risiko des Scrapings von KI-Trainingsdaten für die gesamte Tech-Industrie über Nacht neu bewerten.
EVOX ist kein Einzelfall
Ein entscheidendes Detail: EVOX geht in einem parallelen Verfahren zu KI-Trainingsdaten mit denselben Argumenten auch gegen Midjourney vor. Diese Tatsache ändert die Art und Weise, wie diese Klage zu lesen ist, grundlegend.
Ein verärgerter Fotograf, der einmal klagt, äußert eine persönliche Beschwerde. Ein Kläger, der identische Klagen gegen mehrere Giganten der Bildgenerierung einreicht, verfolgt eine Unternehmensstrategie: Es geht darum, eine juristische Theorie zu etablieren, Präzedenzfälle zu schaffen und milliardenschwere Vergleiche (Settlements) zu erzwingen oder die Industrie in die Knie zu zwingen. Die Rechtsstreitigkeiten um KI-Trainingsdaten konsolidieren sich derzeit genau nach diesem Muster, wobei eine kleine Gruppe von „Wiederholungsklägern“ die juristische Offensive anführt.
Die praktische Konsequenz ist, dass der Fall ByteDance nicht isoliert im luftleeren Raum entschieden wird. Die Schriftsätze und Urteile aus den Parallelverfahren werden direkten Einfluss nehmen, und jedes Gerichtsurteil, das die These der Entschädigung „pro Einzelwerk“ (per work) stützt, wird rasch auf andere Gerichtsstände überspringen.
Was diese Klage für Bildgeneratoren verändert
Sollte sich die Theorie des Klägers vor Gericht durchsetzen, wird dies drei tektonische Verschiebungen in der Industrie auslösen:
KI-Trainingsdaten werden zu einer quantifizierbaren finanziellen Verbindlichkeit. Sobald der Multiplikator „pro Werk“ gerichtlich bestätigt ist, ist das Datenvolumen eines Modells kein kostenloser Wettbewerbsvorteil mehr, sondern ein messbares finanzielles Risiko, das in Bilanzen ausgewiesen werden muss. Das wird die Art und Weise, wie KI-Labore die Beschaffung von KI-Trainingsdaten angehen, deutlich schneller verändern als jede ethische Debatte.
Der Markt für die Lizenzierung von KI-Trainingsdaten wird real. Wenn ungefragt gescrapte Kataloge ein unkalkulierbares finanzielles Risiko bergen, gewinnen legal lizenzierte Kataloge enorm an Wert. Der Transaktionsmarkt für KI-Trainingsdaten, der seit drei Jahren reine Theorie war, erhält endlich ein klares Preissignal.
Die Herkunft von KI-Trainingsdaten wird vom Marketing-Extra zum Überlebensschild. Die Fähigkeit, lückenlos beweisen zu können, aus welcher legalen Quelle jedes einzelne Trainingsbild stammt, markiert den Unterschied zwischen überschaubaren Betriebskosten und dem Risiko eines grenzenlosen Bankrotts.
Was die Klage NICHT ändert
Es ist wichtig, die Grenzen dieses Rechtsstreits klar zu benennen, da die Berichterstattung gerne zu Übertreibungen neigt.
Dieser Fall rund um KI-Trainingsdaten macht die Nutzung von Bildgeneratoren für Sie als Anwender weder illegal noch unsicher. Es handelt sich um einen kommerziellen Rechtsstreit zwischen dem Entwickler, der das Modell trainiert, und dem Urheberrechtsinhaber über die Beschaffung von KI-Trainingsdaten. Nichts in dieser Klage berührt die Legalität der Nutzung eines von Dritten trainierten Modells, und sie hat auch keinerlei rechtliche Auswirkungen auf das Schreiben von Prompts.
Ebenso wenig löst der Fall die komplexe Debatte über „Fair Use“ (angemessene Verwendung). Die juristische Auseinandersetzung darüber, ob die algorithmische Analyse von KI-Trainingsdaten unter die Fair-Use-Doktrin fällt, wird seit Jahren ergebnislos geführt – eine einzelne Klage vor einem Bezirksgericht wird diese Grundsatzfrage nicht allein abschließend klären.
Lesen Sie Klagenachrichten mit kritischer Distanz
Vier wichtige Einschränkungen, bevor Sie voreilige Schlüsse ziehen:
Eine Behauptung ist kein rechtskräftiges Urteil. Es wurde noch keine rechtliche Haftung festgestellt, und die Zahl 7.095 ist eine einseitige Berechnung des Klägers.
Die Zählung der KI-Trainingsdaten basiert auf einer eigenen Methodik. Die Zahl „7.095“ spiegelt die technische Methode wider, mit der EVOX seine Bilder in den KI-Ausgaben identifiziert und abgeglichen hat. Ob ein Richter diese Zählmethode als technisch und rechtlich stichhaltig anerkennt, ist eine völlig andere Frage.
Die Theorie der Entschädigung „pro Einzelwerk“ ist stark umstritten. Es ist das juristische Maximalargument des Klägers, um die Schadensersatzsumme aufzublähen, kein etabliertes Gesetz.
Klagen in der Frühphase ändern sich ständig. Im Technologiebereich ist es üblich, dass Klageschriften nachträglich geändert werden, bestimmte Anklagepunkte fallen gelassen werden oder die Parteien sich weit vor einem Prozess auf vertrauliche, außergerichtliche Vergleiche (Settlements) einigen.
Was das für Sie als visueller Creator bedeutet
Wenn Sie Modelle trainieren (Trainers): Die Nachverfolgbarkeit der Bildquellen (Provenance) ist ab sofort Ihre wichtigste Lebensversicherung im Risikomanagement. Die KI-Trainingsdaten, die Sie in Ihr System einspeisen, sind ein Posten in der Finanzbilanz, keine reine technische Variable mehr.
Wenn Sie Bilddatenbanken besitzen (Licensors): Der Wert Ihres Archivs ist soeben gestiegen. Strukturierte, zählbare und eindeutig identifizierbare Bildbibliotheken sind genau der juristische Rettungsanker, den der Markt für KI-Trainingsdaten jetzt dringend kaufen muss, um seine Technologie abzusichern.
Wenn Sie lediglich Bilder generieren (Generators): Dieser Krieg betrifft Sie nicht direkt. Nutzen Sie die Modelle weiter, verfeinern Sie Ihre Prompts und beobachten Sie das Urteil zur „Pro-Werk-Bezahlung“ aus der Ferne – denn diese Rechnung wird Sie letztlich in Form von Preiserhöhungen bei Ihrem KI-Abonnement erreichen.
Ein Prompt, um den Kontext zu visualisieren
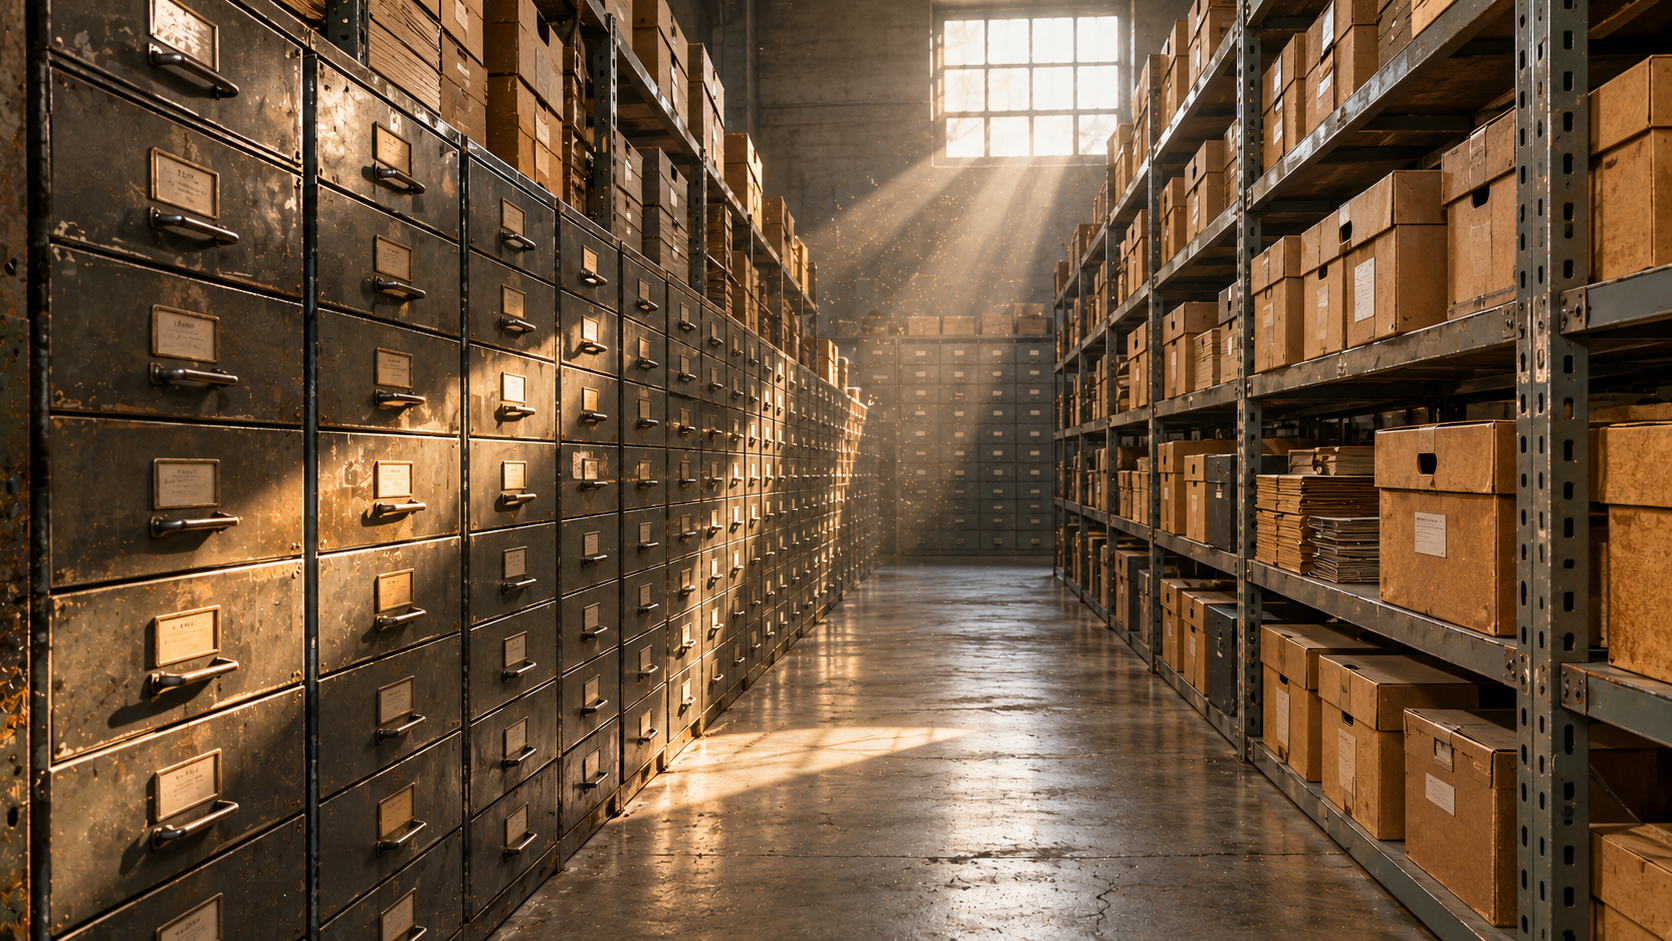
Wenn Sie Bilder erstellen möchten, die den Geist dieser Nachricht einfangen, ist das Archiv das ehrlichste Motiv – die immense physische Bibliothek, die den geschäftlichen Sinn hinter Bildkatalogen und letztlich hinter diesem Konflikt verdeutlicht.
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
A wide documentary photograph down the aisle of a vast photographic archive: long rows of steel filing drawers receding into dim depth on both sides, cardboard slide boxes stacked on open metal shelves, a single shaft of daylight falling from a high window and catching dust in the air. Fine detail in the brushed steel drawer fronts, worn paper labels and the fibre of the cardboard boxes, cool grey and warm sepia palette, deep perspective, slight vignetting at the frame edges, 16:9 framing, 8K detail, no people, no legible text.
In der heutigen KI-Industrie ist ein „Fotoarchiv“ das einzige Bild, dessen Millionenwert exakt davon abhängt, dass man mathematisch präzise beweisen kann, was darin gespeichert ist.
Warum Fanch AI Sie in diesem Umfeld schützt
Die rechtliche Schlacht um KI-Trainingsdaten dreht sich darum, wie große KI-Unternehmen fremde Bildbibliotheken extrahieren und speichern – nicht darum, ob Menschen kreative Werkzeuge nutzen dürfen. Diese Unterscheidung ist essenziell: Das rechtliche Risiko liegt bei dem Ingenieur, der das Web ausliest (Scraping), um das Netzwerk zu trainieren, und nicht bei dem Creator, der an seinem Schreibtisch einen Textprompt tippt.
Fanch AI stellt Ihnen ein dediziertes Bildgenerierungsmodell zur Verfügung, das Sie mit hochpräzisen Prompts steuern. Dies ermöglicht es Ihnen, das benötigte visuelle Material direkt aus Ihrer kreativen Beschreibung heraus zu generieren, ohne in den Beständen dritter Stock-Kataloge stöbern zu müssen. Das garantiert, dass Ihr Werk, Ihre Ideen und Ihre Nutzungsrechte sauber getrennt und eindeutig in Ihrem Besitz bleiben.
👉 Jetzt starten: Erstellen Sie Bilder mit GPT Image 2 auf Fanch AI.