
Higgsfield skaliert KI-Videos von 1 Minute auf über 10 Minuten | Fanch AI
Kurze Sequenzen waren bisher die prägende Hürde für KI-Video (AI video). Die meisten Generatoren stoppen nach wenigen Sekunden; selbst ambitionierte Werkzeuge enden meist bei rund einer Minute. Higgsfield gibt nun an, diese Grenze überwunden zu haben – von etwa einer Minute auf über 10 Minuten ununterbrochene Ausgabe. Sollte sich dies im Praxiseinsatz bestätigen, wäre es der größte Schritt für KI-Video seit einem Jahr.
Diese Entwicklung basiert auf einem Kundenbericht, den OpenAI diese Woche veröffentlichte, und liefert wichtige Einblicke in die Zukunft längerer KI-Videos. Gleichzeitig ist die Ankündigung mit realistischer Distanz zu bewerten – Herstellerangaben zu KI-Video eilen unabhängigen Prüfungen erfahrungsgemäß voraus.
Was Higgsfield tatsächlich verändert hat
Laut Darstellung von OpenAI hat Higgsfield einen auf GPT-6 Astra basierenden Workflow aufgesetzt, der Lehrvideos von über 10 Minuten Dauer für den eigenen YouTube-Kanal erzeugt. Higgsfield-CEO und Mitgründer Alex Mashrabov erklärte, dass der bisherige Prozess bei maximal rund einer Minute pro Durchlauf endete.
Die entscheidende praktische Verschiebung liegt im Produktionsablauf: Längere Ausgaben bedeuten, dass bei Inhalten mittlerer Länge kein manueller Schnitt mehr nötig ist. Statt dutzende Einzelclips in einer Schnittsoftware aneinanderzureihen, kann ein Team ein durchgehendes KI-Video erstellen – so die Aussagen der beteiligten Unternehmen.
Mashrabov beschreibt die Funktion so, dass ein einzelner Creator eine komplette, hochwertige Produktion eigenständig abwickeln kann, statt auf ein Team angewiesen zu sein, das Einzelteile zusammenfügt. Das ist das Kernversprechen langer KI-Videos: weniger Übergaben, weniger sichtbare Brüche.
Die zugrunde liegende Modellarchitektur
Der Workflow von Higgsfield verknüpft die Generierung mit intelligenter Orchestrierung. Laut OpenAI kommen zwei Systeme zusammen, die verdeutlichen, wie moderne Pipelines für KI-Video strukturiert werden:
- GPT-6 Astra — steuert die Generierung des KI-Videos und betreibt die kreativen Agenten, die wiederkehrende Aufgaben wie das Erstellen von Schnittvarianten automatisieren.
- Tool Calling (Funktionsaufrufe) — GPT-6 Astra erlaubt diesen Agenten, externe Spezialwerkzeuge für anspruchsvolle Aufgaben wie 3D-Modellierung anzusteuern.
Der Rückgriff auf 3D-Modellierung ist hierbei der entscheidende Punkt. Mashrabov verbindet den Werkzeugeinsatz direkt mit visueller Konsistenz: Wenn auf eine feste Szenengeometrie wiederholt zugegriffen werden kann, behält das Modell einen stabilen räumlichen Bezugspunkt, statt die Szene bei jedem Kameraschnitt neu zu berechnen. Das ist das technische Fundament, das längere KI-Videos zwingend erfordern.
Ein zweites Modell, GPT-Image-2.5, soll für die präzise visuelle Bildsteuerung sorgen – jene Ebene, die verhindert, dass Gesichter oder Ausstattungsdetails über die Laufzeit des KI-Videos hinweg abdriften. Zusammen bilden sie einen Systemverbund statt eines reinen Einzelgenerators, was diesen Ansatz von einfachen Clip-Tools abhebt.
Warum Bildkonsistenz das eigentliche Problem war
Die schiere Dauer war nie die größte Herausforderung; es war die zeitliche Kontinuität. Ein 10-sekündiges KI-Video kann Abweichungen kaschieren; ein 10-minütiges Video verzeiht keinen Fehler.
Gesichter verändern sich, Kleidung wechselt die Struktur, Räume bauen sich unbemerkt um und Lichtverhältnisse springen zwischen Schnitten. Bei kurzen Social-Clips wird das toleriert, bei einem Lehrvideo führt es zum sofortigen Abbruch. Deshalb lagen längere KI-Videos stets hinter kurzen Clips zurück, selbst als die Qualität von Einzelszenen rasant stieg. Jeder professionelle Entwicklungsplan für KI-Video stößt an diese Grenze.
Der Ansatz von Higgsfield – Agenten, externe Werkzeuge und eine dedizierte Steuerungsebene – zielt darauf ab, die Bildwelt über viele Berechnungsdurchläufe stabil zu halten. Funktioniert das, erweitert sich nicht bloß die Videolänge, sondern das gesamte nutzbare Format.
Warum diese Angaben vorsichtig zu bewerten sind
Einen Aspekt klammern viele Berichte aus: Sämtliche Leistungswerte stammen von OpenAI und Higgsfield selbst. Wie Analysten von Data Phoenix festhalten, enthält der Bericht keine unabhängigen Benchmarks bezüglich Ausgabequalität, Renderzeiten, Produktionskosten oder des Umfangs nötiger manueller Eingriffe.
Ebenso bleibt offen, ob das fertige 10-minütige KI-Video aus einem einzigen Generierungsdurchlauf stammt oder das Ergebnis einer automatisierten Zusammenfügung kürzerer Segmente durch Software-Agenten ist. Dies sind technisch grundverschiedene Ansätze, die für jeden relevant sind, der Workflows auf Basis von KI-Video plant.
Die Zahl von 10 Minuten sollte vorerst als Herstellerangabe gewertet werden, bis unabhängige Praxistests vorliegen. Das schmälert die Leistung nicht, gebietet jedoch Umsicht, bevor man eigene Produktionsabläufe darauf umstellt. Skepsis gegenüber Ankündigungen im Bereich KI-Video kostet nichts; eine verfrühte Workflow-Umstellung auf unsicherer Basis ist teuer. Bestätigen sich die Werte, verschiebt sich der Standard für mittellange Videoformate grundlegend.
Was das für Creator bedeutet
Vier Erkenntnisse sind für die Arbeit mit KI-Video entscheidend:
- Kontinuität ist der Maßstab — der Wettbewerb entscheidet sich künftig nicht an der Cliplänge, sondern an der Stabilität über Schnitte hinweg.
- Orchestrierung schlägt Einzelmodelle — Agenten, Werkzeuge und Referenzebenen sind der Schlüssel zu langen KI-Videos.
- Herstellerwerte verlangen eigene Tests — prüfen Sie neue Versprechen stets an eigenem Bildmaterial.
- Mittellange Formate werden realistisch — Erklärvideos, Tutorials und Trainingsinhalte sind die Hauptprofiteure dieser Entwicklung.
Die unmittelbaren Folgen zeigen sich bei Bildungs- und Anleitungsvideos mit KI-Video, nicht im Kinobereich. Dies ist ein riesiger Markt, in dem sich KI-Video über wirtschaftliche Vorteile etablieren wird, bevor rein künstlerische Maßstäbe greifen.
Ein Prompt zum Ausprobieren
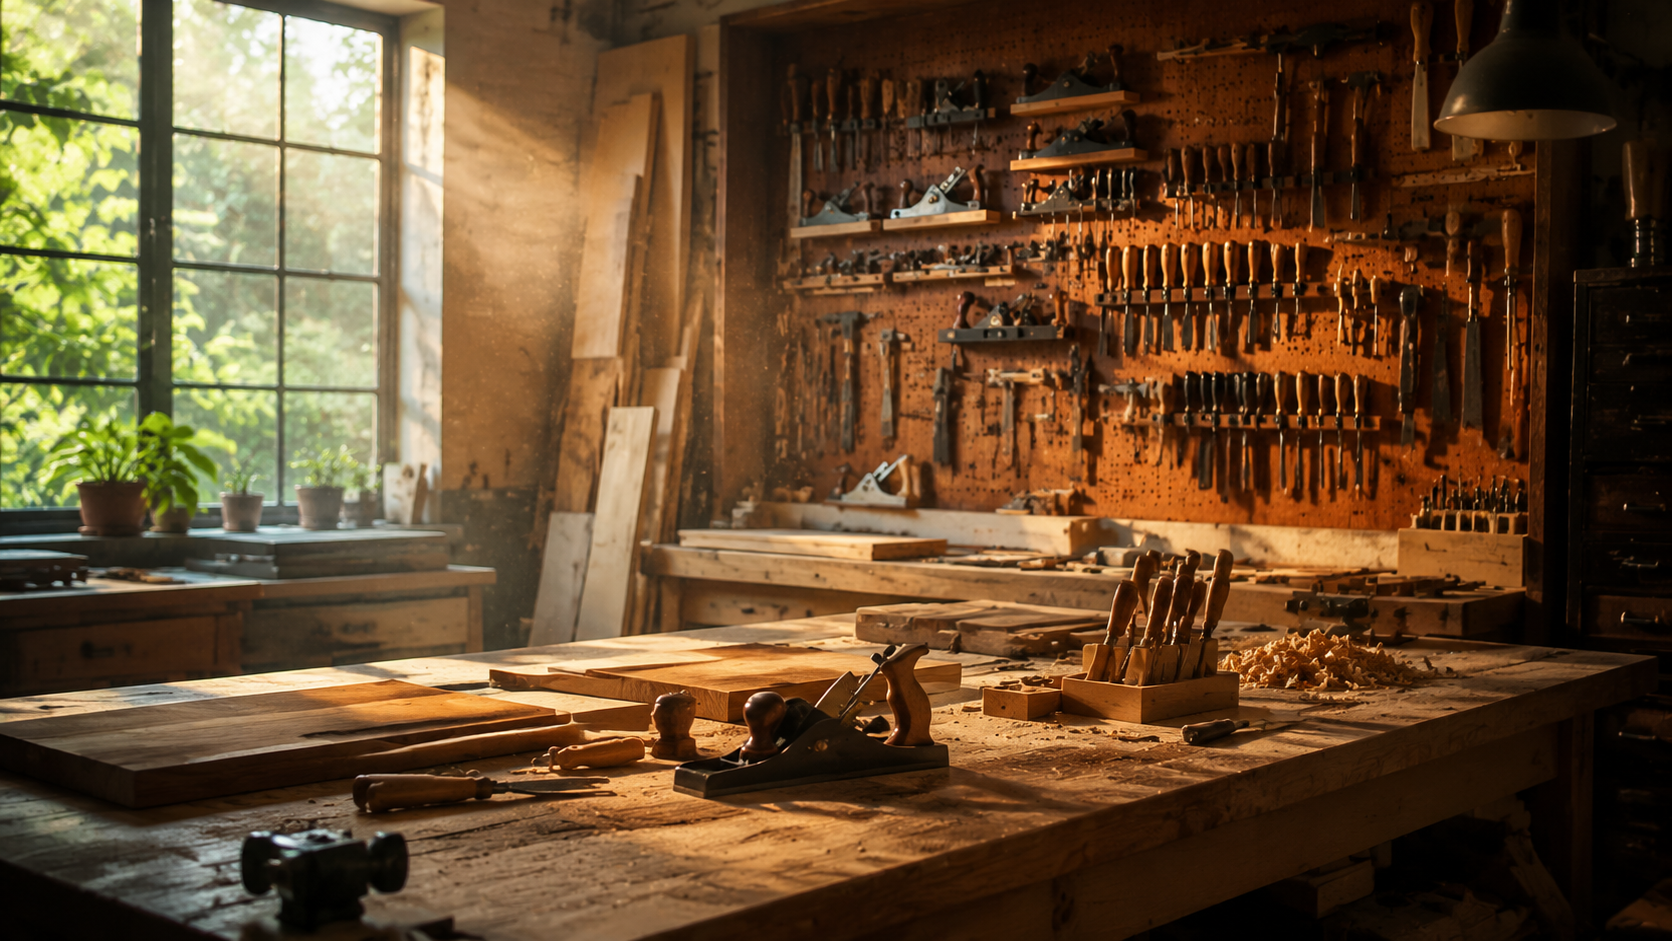
Visuelle Konsistenz beginnt mit einer eindeutigen, wiederholbaren Szenenbeschreibung – der handwerklichen Basis, von der jedes längere KI-Video abhängt. Testen Sie dies auf Fanch AI:
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
Warum Fanch AI in diesen Workflow passt
Gleichgültig, ob Sie ein langes KI-Video planen oder eine einzelne Schlüsselszene anlegen: Das visuelle Referenzbild steht immer am Anfang. Fanch AI bietet Ihnen ein spezialisiertes Bildmodell, das Sie mit präzisen Prompts steuern – so legen Sie Charaktermerkmale, Garderobe und Lichtführung fest, bevor die erste Sekunde KI-Video gerendert wird. Verlässliche Bildkontinuität basiert auf sauberen Standbildern, und ein präzise kontrolliertes Referenzbild ist die beste Absicherung für jedes Projekt mit KI-Video.