
Neuer KI-Video-Benchmark der HKU: Bildqualität und Sicherheitsfilter spalten das Testfeld | Fanch AI
Ein neuer KI-Video-Benchmark (AI video benchmark) der Universität Hongkong liefert ein Ergebnis, das für die gesamte Branche gleichermaßen bemerkenswert wie herausfordernd ist. Die von der Wirtschaftsfakultät der University of Hong Kong (HKU) veröffentlichte Untersuchung stellt fest, dass chinesische Videomodelle inzwischen bei der visuellen Renderqualität die Führung übernommen haben – angeführt von Seedance 2.0 Pro, das vor Veo 3.1 und Sora 2 Pro an der Spitze liegt –, während dieselben Systeme bei Sicherheitsvorkehrungen und Schutzfiltern spürbar zurückfallen.
Diese Konstellation verleiht dem KI-Video-Benchmark echtes Gewicht jenseits reiner Schlagzeilen. Es handelt sich um eine der ersten breit rezipierten Studien, die Ausgabequalität und Abwehrmechanismen innerhalb desselben Bewertungsrahmens gegenüberstellt – und beide Teilergebnisse weisen in entgegengesetzte Richtungen.
Die Kernbefunde des HKU-Reports
Drei zentrale Erkenntnisse prägen diesen KI-Video-Benchmark:
Die Führung bei der Bildqualität hat gewechselt. In diesem KI-Video-Benchmark erzielte das führende chinesische Modell bei der visuellen Generierung höhere Werte als die führenden US-Systeme. Damit bricht eine zentrale Annahme weg, die zu Beginn des Jahres 2026 noch als Konsens galt – dass Veo und Sora das unumstößliche Qualitätsmaximum darstellten.
Die Schutzfilter zogen nicht im gleichen Maße mit. Dieselbe Untersuchung wies nach, dass die chinesischen Modelle bei Sicherheitsregeln und Abwehrmaßnahmen schwächer abschneiden. Der Bericht selbst spricht von einer klaren Tendenz, visuelle Exzellenz zu priorisieren, während Schutzmechanismen pragmatisch schlank gehalten werden.
Die Diskrepanz ist eine bewusste Produktentscheidung. Zusammengenommen zeigen die Messwerte Modelle, die konsequent auf maximale Bildausbeute getrimmt wurden und weniger streng auf potenzielle Regelverstöße reagieren. Das ist ein strategischer Produktentscheid – und ein KI-Video-Benchmark, der beide Dimensionen misst, macht diesen Umstand erstmals transparent greifbar.
Warum eine Business School diese Untersuchung durchführte
Die institutionelle Herkunft einer Untersuchung bestimmt, wie ihre Ergebnisse gewichtet werden sollten. Es handelt sich hierbei nicht um ein Informatiklabor, das mathematische PSNR-Werte auf synthetischen Testdatensätzen vergleicht. Die Studie stammt von der Wirtschaftsfakultät der HKU, was Fragestellungen und Bewertungsmaßstäbe prägt: betriebliche Praxistauglichkeit, Verhalten auf Produktebene und die Risikohaltung, die für gewerbliche Unternehmenskunden relevant ist.
Das macht diesen KI-Video-Benchmark für Einkäufer und Kreativdirektoren wertvoller als für reine Grundlagenforscher. Er beantwortet die Frage „Welches Modell liefert ab und welche Anfragen verweigert es?“ statt „Welche Netzwerkarchitektur weist den geringeren rechnerischen Trainingsverlust auf?“.
Daraus erwachsen jedoch auch methodische Grenzen. Die Bewertung einer einzelnen Institution mit eigenem Kriterienkatalog ist ein starker Datenpunkt, aber kein in Stein gemeißeltes Gesamtranking. Hinter der Untersuchung steht bislang kein Peer-Review-Verfahren; das Prompt-Set, die Gewichtung der Achsen und die ausgewählten Modellversionen beruhen auf individuellen Setzungen der Autoren.
Was „Schutzvorkehrungen“ bei einem Videomodell bedeuten
Sicherheit bei Textmodellen ist eine vergleichsweise überschaubare Frage: Verweigert das Modell die Ausgabe unzulässiger Inhalte? Bei Videomodellen ist die Sachlage ungleich komplexer.
Auf der defensiven Seite eines KI-Video-Benchmarks fließen verschiedene Parameter zusammen: Werden eindeutig unzulässige Prompts abgewiesen? Bleibt das Modell standhaft, wenn eine heikle Anfrage in eine scheinbar harmlose Formulierung verpackt wird? Werden Grenzfälle sauber abgefangen, statt unbrauchbare Artefaktbilder zu erzeugen? Und werden bekannte Risikofelder (Persönlichkeitsrechte, Gewaltdarstellungen, nicht jugendfreie Szenen) konsistent moderiert oder unterliegen sie statistischen Zufällen?
Ein Modell, das bei optischer Detailtreue herausragend abschneidet, bei diesen Schutzmechanismen jedoch nachlässig agiert, stellt ein sehr spezifisches Produktprofil dar: hochgradig attraktiv für professionelle Kreative, die rein geschäftliche Szenen rendern, aber mit spürbaren Risiken behaftet für Plattformbetreiber mit offenem Publikumszugang. Ein KI-Video-Benchmark, der beide Werte parallel ausweist, ermöglicht eine fundierte Abwägung.
Vorbehalte bei der Interpretation von KI-Video-Benchmarks
Vier methodische Einschränkungen sollten bei der Einordnung bedacht werden:
Eine Einzelstudie bleibt eine Momentaufnahme. Der KI-Video-Benchmark eines einzelnen Hauses liefert beachtliche Indizien, aber keinen endgültigen Beweis. Die Methodik muss sich zunächst in unabhängigen Replikationen bewähren.
Ranglisten altern rasant. Kein KI-Video-Benchmark behält über mehr als ein Quartal hinweg seine volle Gültigkeit. Veo 3.1, Sora 2 Pro und Seedance 2.0 Pro sind Momentaufnahmen, deren Nachfolger bereits trainiert werden.
„Visuelle Qualität“ ist kein objektives Naturgesetz. Das Ergebnis hängt davon ab, was der Prüfkatalog belohnt: Bewegungsstabilität, Detailtexturen, physikalische Lichtführung, Prompt-Treue oder schlicht das subjektive Gefallen menschlicher Tester. Zwei seriös aufgesetzte Benchmarks können dieselben Modelle in unterschiedlicher Reihenfolge listen.
Die geografische Herkunft ist nicht der operative Hebel. Der produktive Erkenntnisgewinn liegt nicht in der Gegenüberstellung von Modellen aus China und den USA. Er liegt im Vergleich von Systemen, die auf kompromisslose Ausgabeleistung getrimmt sind, gegenüber solchen, bei denen strikte Inhaltsabwehr im Vordergrund steht.
Was das für die Praxis von Videoschaffenden bedeutet
Für professionelle Creator leiten sich aus diesem KI-Video-Benchmark drei konkrete Handlungsempfehlungen ab:
Verabschieden Sie sich von der Annahme, US-Modelle seien das Qualitätsmaximum. Der Abstand bei der rein visuellen Generierung ist geschlossen. Wer Seedance bisher aus Qualitätsbedenken gemieden hat, sollte eigene Tests ansetzen.
Klären Sie das Verweigerungsverhalten vor der Workflow-Festlegung. Ein Modell mit geringeren Schutzfiltern bedeutet in der Praxis weniger Reibungsverluste bei unkonventionellen Bildideen, verlagert die Verantwortung für die inhaltliche Prüfung jedoch vollständig auf Ihre Seite.
Entscheiden Sie nach Anwendungsfall, nicht nach Markentreue. Das Modell, das einen Benchmark anführt, kann bei Ihrem konkreten Storyboard dennoch Schwächen zeigen. Nutzen Sie Benchmarks als Anlass für rationale Vergleiche, nicht für blinde Markenpräferenzen.
Wie Sie Ihren eigenen Mini-Benchmark aufsetzen
Die verlässlichste Reaktion auf externe Studien ist ein eigener, pragmatischer Testaufbau. Er beansprucht etwa zwanzig Minuten:
1. Definieren Sie fünf feste Prompts. Decken Sie Ihre typischen Anforderungen ab: eine gehende Person, eine Kamerafahrt, ein Textur-Makro, eine Szene mit Beschriftungen und ein abstraktes Motiv.
2. Halten Sie die Einstellungen konstant. Gleiches Bildformat, identische Dauer und derselbe Seed, sofern das Modell dies unterstützt. Andernfalls vergleichen Sie Konfigurationen statt Modellleistungen.
3. Bewerten Sie nur drei Achsen. Prompt-Treue, zeitliche Bewegungskonsistenz und Bildfehler (Artefakte). Vermeiden Sie ausufernde Kriterienkataloge.
4. Prüfen Sie immer bei normaler Abspielgeschwindigkeit. Schnelles Scrubben auf der Zeitleiste kaschiert Bewegungsfehler, an denen KI-Video in der Praxis scheitert.
5. Wiederholen Sie den Test vierteljährlich. Jeder veröffentlichte Benchmark veraltet – Ihre eigene Testreihe bildet da keine Ausnahme.
Ein Prompt für den Praxistest
Wenn Sie die zeitliche Bewegungskonsistenz eines Modells prüfen wollen, wählen Sie eine Szene mit einer klaren Objektbewegung und einer sauberen Kamerafahrt:
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
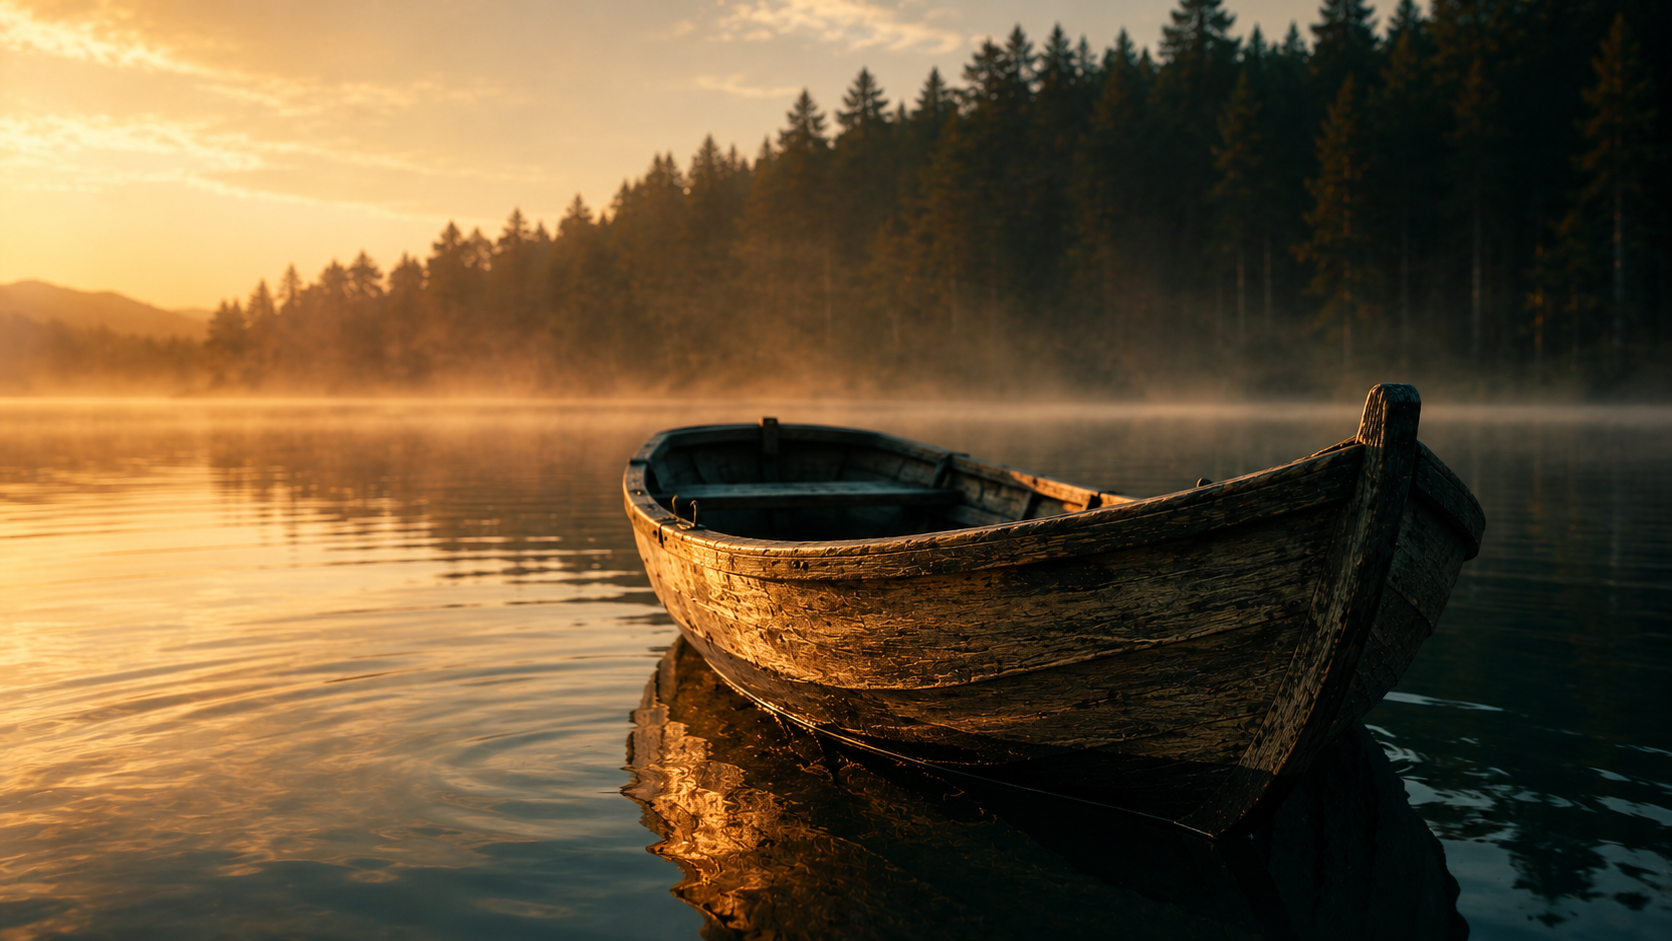
A cinematic still of a lone wooden rowboat drifting on a calm lake at golden hour, seen from a low angle just above the waterline: warm rim light along the hull, gentle ripples spreading outward, distant mist-covered pine treeline, soft haze in the air. Fine detail in the wet wood grain and water surface, shallow depth of field, warm amber and cool teal palette, 16:9 framing, 8K detail, no text overlay.
Erzeugen Sie dieses Standbild, nutzen Sie es als Ausgangsbasis für das jeweilige Videomodell und analysieren Sie, wie stabil sich Wasseroberfläche und Holzstruktur in der Bewegung verhalten.
Warum Fanch AI Ihren Workflow unterstützt
Die wichtigste Lehre moderner KI-Video-Benchmarks lautet: Weil die Systemunterschiede schrumpfen, entscheidet die Qualität des Prompts und des Ausgangsbildes über den Erfolg. Fanch AI bietet Ihnen ein spezialisiertes Bildmodell, mit dem Sie Bildaufbau und Lichtstimmung auf einem kostengünstigen Standbild perfektionieren können, bevor Sie Renderzeit in Videomodelle investieren – und ermöglicht Ihnen so den fairen Modellvergleich auf Basis eines kontrollierten Referenzbildes.
👉 Jetzt starten: Erstellen Sie Videos mit Sora 2 auf Fanch AI.