
Lokale KI-Bildgenerierung: Was eine GPU, die Sie bereits besitzen, wirklich kostet | Fanch AI
Das Versprechen der lokalen KI-Bildgenerierung (local AI image generation) klingt bestechend: Da die Grafikkarte ohnehin im Rechner steckt, tendieren die Grenzkosten pro generiertem Bild gegen null. Ein viel beachteter Erfahrungsbericht auf XDA argumentiert genau so – Recherche, Programmierung und Bildgenerierung laufen parallel auf einer vorhandenen Consumer-GPU, ohne dass dafür monatliche Abogebühren anfallen.
Diese Darstellung ist gleichermaßen zutreffend wie unvollständig. Die lokale KI-Bildgenerierung zeichnet sich tatsächlich durch extrem geringe variable Kosten pro Bild aus. Sie zieht jedoch eine Rechnung nach sich, die in drei Währungen beglichen wird, die in keinem Aufmacher auftauchen: Stromkosten, manueller Wartungsaufwand und sichtbare Einbußen bei der Renderqualität.
Hier erfahren Sie, wie ein solches Self-Hosted-Setup im Detail aufgebaut ist, was es im Alltag wirklich kostet und in welchen Szenarien die lokale KI-Bildgenerierung ihren Cloud-Alternativen überlegen ist.
Was hinter einem lokalen Stack wirklich steckt
Das im erwähnten Bericht beschriebene System ist keine unübersichtliche Ansammlung loser Skripte. Es handelt sich um eine integrierte Anwendung auf Basis von Pixeltable, in der spezialisierte Modelle für klar umrissene Aufgabenbereiche kombiniert werden: Ein quelloffenes Bildmodell generiert Visuals, ein Codemodell schreibt Skripte und ein Mixture-of-Experts-Modell (MoE) übernimmt redaktionelle Recherchen.
Als Standardkonfiguration für die lokale KI-Bildgenerierung gilt derzeit eine RTX 4070 Ti Super mit 16 GB VRAM, auf der FLUX für Bilder und Qwen für Programmcode betrieben werden. Wir sprechen hier von einer handelsüblichen Gaming-Karte der gehobenen Mittelklasse, nicht von teurer Server-Hardware. Die Eintrittshürde für die lokale KI-Bildgenerierung ist damit auf das Vorhandensein einer einzigen Standard-Grafikkarte gesunken.
Der eigentliche Reiz liegt in der Bündelung. Die meisten Anwender, die Bildgenerierung lokal betreiben, jonglieren mit drei separaten Programmen ohne gemeinsamen Datenaustausch. Die Zusammenführung von Bildgenerierung, Code-Erstellung und Recherche in einem einzigen Workflow ist ein organisatorischer Effizienzgewinn, keine reine Hardwareleistung.
Warum das Argument der „bereits vorhandenen GPU“ trügerisch ist
Die Wirtschaftlichkeit der lokalen KI-Bildgenerierung fußt auf einer ökonomischen Gesetzmäßigkeit: Versunkene Kosten (Sunk Costs) sind bereits bezahlt. Wenn die GPU für Gaming oder Videobearbeitung ohnehin angeschafft wurde, beschränken sich die Mehrkosten für die Bildgenerierung rein auf den zusätzlichen Stromverbrauch.
Rechnen Sie selbst nach: Eine typische Grafikkarte dieser Klasse zieht unter Volllast rund 300 Watt. Ein einstündiger Dauerbetrieb entspricht 0,3 kWh. Bei einem Strompreis von ca. 0,35 € pro Kilowattstunde belaufen sich die reinen Betriebskosten auf rund 10 Cent pro Stunde. Je nach Modell und Sampling-Schritten erzeugt man in dieser Stunde mehr Bildmaterial, als Gelegenheitsnutzer in einem ganzen Monat über kostenpflichtige APIs abrufen.
Das ist auf dem Papier ein hervorragendes Geschäft und erklärt die anhaltende Faszination für die lokale KI-Bildgenerierung. Es spiegelt jedoch nur die halbe Wahrheit wider.
Drei Kostenfaktoren, über die niemand spricht
Ihre Arbeitszeit. Der Betrieb einer lokalen KI-Bildgenerierung erfordert kontinuierliche Systempflege. Modellgewichte ändern sich, benutzerdefinierte Nodes in ComfyUI verweigern nach Updates den Dienst, GPU-Treiber zeigen Inkompatibilitäten und Python-Abhängigkeiten kollidieren ohne Vorwarnung. Wer Freude an technischer Fehlersuche hat, findet darin ein lohnendes Hobby; wer Bildmaterial termingerecht an Kunden liefern muss, leistet unbezahlte Überstunden als Systemadministrator.
Der Qualitätsunterschied. Das ist der entscheidende Punkt bei der lokalen KI-Bildgenerierung. Führende Cloud-Modelle liefern bei mikroskopischen Texturen, feiner Schriftsetzung und komplexer menschlicher Anatomie nach wie vor sichtbar überlegene Ergebnisse. Ein lokaler Betrieb auf einer 16-GB-Karte erzwingt den Einsatz quantisierter Modelle (Quantization), und die Quantisierung spart Rechenaufwand genau auf Kosten dieser feinen Bilddetails ein.
Fehlende Verfügbarkeitsgarantien (SLA). Fällt ein gehosteter Dienst aus, kümmert sich der Anbieter um die Entstörung. Eine lokale Installation steht still, sobald die eigene Hardware thermisch drosselt, das Netzteil streikt oder ein Software-Update das System lahmlegt.
Eingeschränkte Teamfähigkeit. Sobald ein zweiter Mitarbeiter auf das Modell zugreifen soll, wird aus dem Desktop-Rechner ein improvisierter Server – mit allen klassischen Administrationsproblemen, für deren Lösung Sie selbst zuständig sind.
Vier Szenarien, in denen die lokale Generierung klar gewinnt
In folgenden Fällen lohnt sich der Aufbau eines eigenen Setups zweifellos:
Sehr hohe Bildmengen. Sobald die Hardware vorhanden ist, skaliert die lokale KI-Bildgenerierung mit Ihrer Geduld statt mit dem Guthaben Ihrer Kreditkarte. Sie können über Nacht Hunderte von Bildvarianten generieren, ohne laufende Kosten zu verursachen.
Strikte Datensicherheit. Bilddaten und Prompts verlassen zu keinem Zeitpunkt das lokale System. Bei sensiblen Kundenprojekten unter strikter Geheimhaltungsvereinbarung (NDA) räumt die lokale KI-Bildgenerierung rechtliche Bedenken von vornherein aus.
Einbrennen eines unverwechselbaren Stils. Durch das Feintuning (LoRA / Fine-Tuning) eines offenen Modells mit eigenen Bildbeständen lässt sich eine visuelle Konsistenz erreichen, die kein noch so präzises Prompting auf Cloud-Plattformen nachbilden kann. Dies ist das stärkste Argument für den lokalen Betrieb.
Arbeiten ohne Inhaltsfilter. Wenn berechtigte kreative Prompts wiederholt an den restriktiven Sicherheitsfiltern kommerzieller Cloud-Anbieter scheitern, bietet die eigene Instanz die notwendige Freiheit. Die lokale KI-Bildgenerierung unterliegt keinen vorgeschalteten Unternehmensrichtlinien – was maximale gestalterische Freiheit bedeutet, aber auch die volle rechtliche Eigenverantwortung verlangt.
Wo die lokale Generierung an Grenzen stößt
Ebenso deutlich muss die Kehrseite benannt werden:
Wenn Ihr Standard fotorealistische Hautstrukturen, millimetergenaue Typografie im Bild oder fehlerfreie Hände ohne Nachbearbeitung erfordert, bleiben führende Cloud-Modelle im Vorteil. Wenn Sie eine Plattform benötigen, auf die ein Team standortunabhängig über den Webbrowser zugreifen kann, ohne dass jemand Hardware warten muss, beschreiben Sie eine SaaS-Lösung. Und wenn Sie nur punktuell Bilder generieren, wiegen die eingesparten Cent-Beträge beim Strom den zeitlichen Einrichtungsaufwand niemals auf.
Die Faustregel lautet: Die lokale KI-Bildgenerierung eignet sich für hohes Volumen, strenge Vertraulichkeit und maximale Konfigurierbarkeit; Cloud-Modelle bieten Bequemlichkeit, höchste Spitzenqualität und null Wartungsaufwand.
Die praktische Grenze von 16 GB VRAM
Sechzehn Gigabyte Grafikspeicher sind ein hartes technisches Limit, das den Spielraum Ihres lokalen Setups klar definiert.
Für ein sinnvoll quantisiertes Bildmodell reicht dieser Speicher vollkommen aus. Ein großes Mixture-of-Experts-Sprachmodell lässt sich darin jedoch nicht unkomprimiert laden: Sie müssen auf stark reduzierte Varianten ausweichen, deren Qualitätseinbußen spürbar sind. Und lokale Videogenerierung auf 16 GB bleibt vorerst ein zähes Experimentierfeld, kein flüssiger Produktions-Workflow.
Eine 16-GB-Karte ist somit eine exzellente Maschine für die lokale KI-Bildgenerierung, verlangt bei anderen rechenintensiven KI-Aufgaben jedoch spürbare Kompromisse. Wenn Bildgenerierung 80 % Ihrer Arbeit ausmacht, ist die Anschaffung absolut sinnvoll. Liegt der Anteil bei 20 %, zahlen Sie einen hohen Preis in Form von Leistungseinschränkungen bei den übrigen 80 %.
Der pragmatische Einstieg
1. Beschränken Sie sich anfangs rein auf Bilder. Versuchen Sie nicht gleich am ersten Tag, komplexe Gesamtsysteme aufzusetzen. Ein Bildmodell, ein stabiler Loader, ein dedizierter Ausgabeordner.
2. Wählen Sie die Quantisierung bewusst. Rendern Sie denselben Prompt mit zwei unterschiedlichen Quantisierungsstufen. Der optische Unterschied zeigt Ihnen exakt, was Ihre Hardware im professionellen Einsatz leisten kann.
3. Messen Sie den zeitlichen Einrichtungsaufwand. Erfassen Sie nicht die Rechenzeit der GPU, sondern die Stunden, die Sie für Installation und Fehlerbehebung aufwenden. Diese Zeit ist Ihre wahre Investition.
4. Halten Sie ein Cloud-Backup bereit. Nutzen Sie Ihr lokales System für Entwürfe und Massenvariationen, und schalten Sie auf ein gehostetes Spitzenmodell um, sobald eine makellose Reinzeichnung für einen Kunden gefordert ist. Dieses hybride Modell hat sich in der Praxis bewährt.
5. Überprüfen Sie Ihr Setup alle sechs Monate. Open-Source-Modelle entwickeln sich rasant weiter. Die wirtschaftliche Rechnung, die Sie heute aufstellen, wird in einem halben Jahr bereits überholt sein.
Ein Prompt für den direkten Vergleichstest
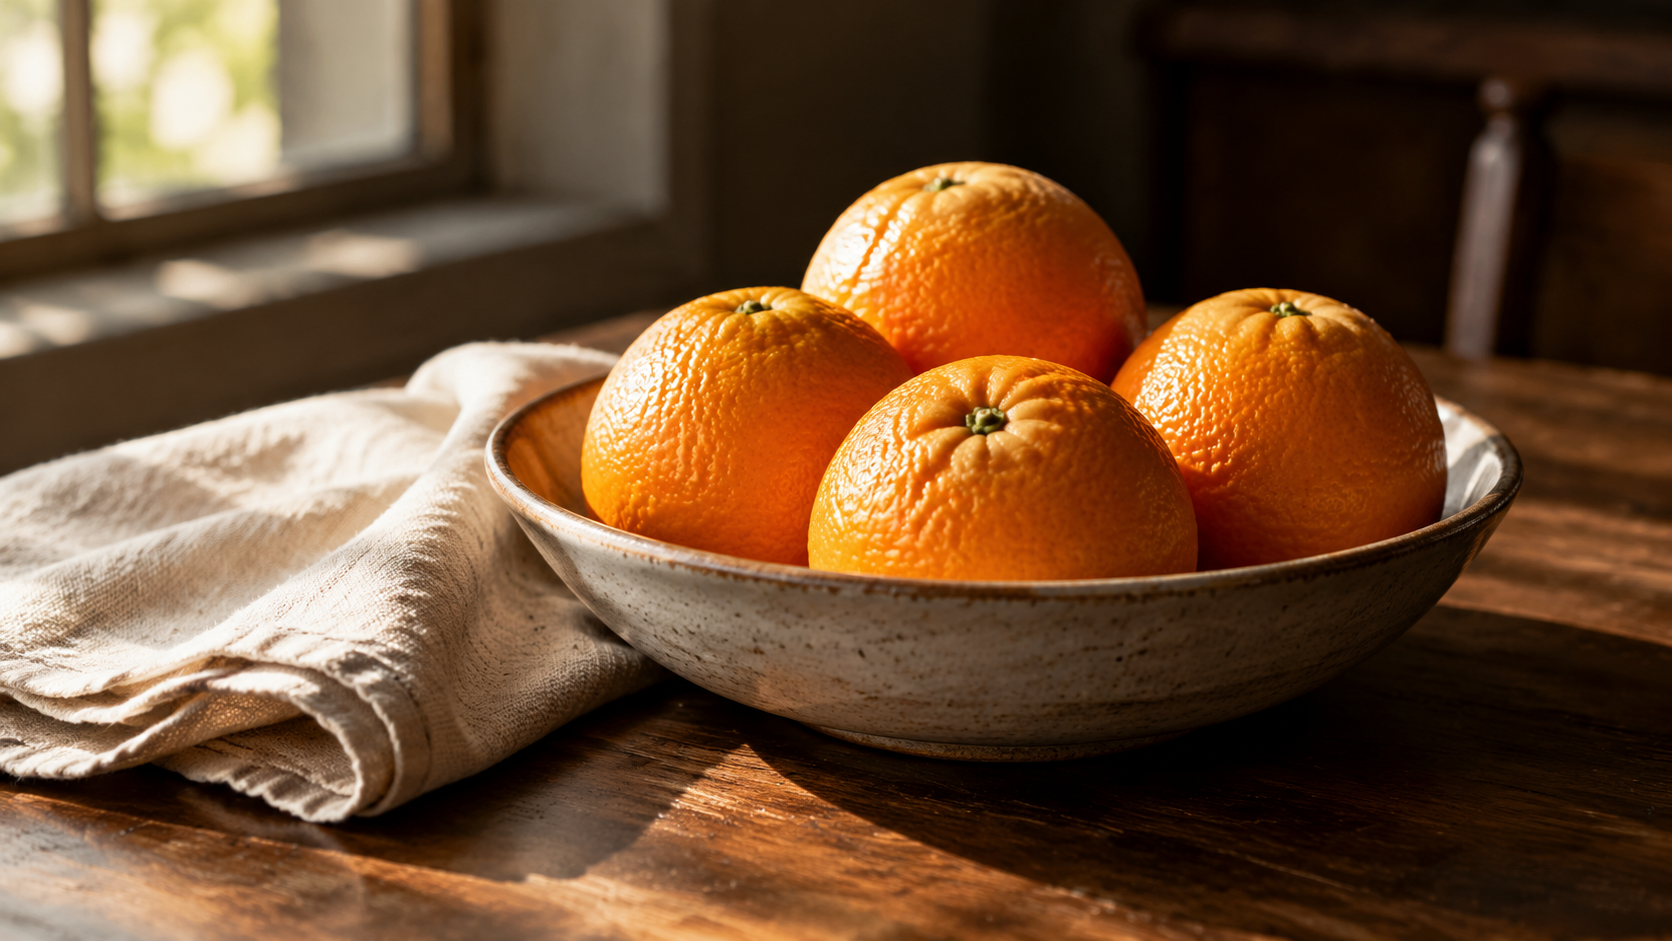
Bevor Sie ein ganzes Wochenende in die Treiberkonfiguration investieren, prüfen Sie, ob das anvisierte Modell die Motive beherrscht, die Sie tatsächlich benötigen. Stillleben machen die physikalische Lichtführung und Materialstrukturen sofort transparent:
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
A moody editorial still life on a dark walnut table: a shallow ceramic bowl holding four ripe oranges, a folded linen napkin beside it, soft window light from the left falling across the fruit, deep shadows in the background. Visible texture in the orange peel and the ceramic glaze, muted warm palette, shallow depth of field, fine film grain, 16:9 framing, 8K detail, no text overlay.
Lassen Sie denselben Prompt lokal durchrechnen. Der direkte Bildvergleich ist der einzige Prüfstein, der für Ihre Anforderungen wirklich Relevanz besitzt.
Warum Fanch AI diesen Arbeitsablauf optimal ergänzt
Die lokale KI-Bildgenerierung ist unschlagbar bei Massenproduktion, Datenschutz und individuellem Feintuning – stößt jedoch an Grenzen, wenn Sie ohne Vorbereitung sofortige Höchstqualität benötigen. Viele Profis nutzen beide Welten parallel. Der wirtschaftlichste Weg besteht darin, Bildaufbau und Farbkomposition vorab in einer leicht zugänglichen Umgebung festzulegen.
Fanch AI stellt Ihnen ein hochpräzises, dediziertes Bildmodell bereit, mit dem Sie Bildausschnitt, Lichtführung und Farbgebung exakt definieren können, um die besten Entwürfe anschließend gezielt und in beliebiger Menge auf der eigenen Hardware zu skalieren.
👉 Jetzt starten: Erstellen Sie Bilder mit GPT Image 2 auf Fanch AI.