
7 095 photos : le chiffre qui décidera du sort du procès de ByteDance sur les images IA | Fanch AI
Sept mille quatre-vingt-quinze. Pas « des millions d'images », pas « de vastes pans d'Internet » — 7 095 photographies. Un nombre suffisamment précis pour ressembler à un inventaire comptable, car c'est exactement ce dont il s'agit.
L'agence de photographie automobile EVOX Productions a assigné ByteDance devant le tribunal du district central de Californie. Elle allègue que la maison mère de TikTok a copié ces 7 095 images sans autorisation pour s'en servir comme données d'entraînement IA (AI training data) pour Seedream, son modèle de génération d'images. L'affaire (EVOX Productions LLC v. Bytedance Inc. et al, dossier 5:26-cv-06428) a été révélée cette semaine par les médias spécialisés Music Business Worldwide et Digital Music News.
L'accusation d'utilisation illicite de données d'entraînement IA n'a plus rien de surprenant ; presque toutes les actions en justice intentées contre les IA génératives depuis deux ans reposent sur ce fondement. Ce qui rend cette plainte particulièrement lourde de conséquences pour l'industrie, c'est la mécanique mathématique implacable qui découle de cette accusation.
Que stipule précisément la plainte ?
Posons d'emblée le cadre légal : il s'agit d'allégations formulées dans une plainte nouvellement déposée et non encore jugée. ByteDance n'a pour l'heure été reconnue coupable d'aucune infraction.
L'allégation centrale : Les photographies automobiles appartenant à EVOX auraient été aspirées (scrapées) sur le web et utilisées comme données d'entraînement IA pour Seedream, le modèle visuel de ByteDance.
L'échelle du préjudice revendiqué : 7 095 images. Un volume dérisoire à l'échelle d'Internet, et c'est un choix juridique très calculé : il s'agit d'un ensemble de fichiers comptables, dûment catalogués, plutôt que d'une masse de données abstraite et indéterminée.
La juridiction : Un tribunal fédéral de Californie. Le plaignant est une société enregistrée au Delaware (LLC), le défendeur également, et le tribunal choisi se situe dans le district où s'accumule la jurisprudence relative à ce type d'affaires liées à l'IA.
L'état de la jurisprudence : La justice américaine n'a encore rendu aucune décision définitive sur l'usage de données d'entraînement IA sous cette configuration spécifique. L'issue du procès dépendra de la phase de communication des pièces (discovery), de la qualification juridique que le tribunal accordera aux œuvres, et des arguments de défense que ByteDance déploiera.
Pourquoi une agence de photographie automobile est le pire des plaignants
C'est l'élément crucial pour comprendre les enjeux. Il explique pourquoi EVOX représente une menace juridique bien plus redoutable pour un laboratoire d'IA qu'un grand quotidien d'information ou qu'une banque d'images généraliste.
La photographie automobile est, par nature, un catalogue structuré. Et les catalogues méthodiquement organisés constituent la matière première idéale sur laquelle reposent les données d'entraînement IA. Angles de prise de vue standardisés, années de modèle, teintes de carrosserie, détails intérieurs, jantes — ce travail est hautement systématique et, surtout, dénombrable. Une entreprise comme EVOX connaît l'étendue exacte de son patrimoine et peut pointer du doigt chaque fichier individuel.
Chaque image est identifiable séparément. Les filigranes physiques, les métadonnées intégrées (EXIF) et la constance absolue des éclairages de studio rendent la vérification de la provenance (provenance) triviale. Or, prouver cette provenance est traditionnellement le maillon faible de la plupart des plaintes concernant les données d'entraînement IA. L'écueil majeur dans ces litiges est de réussir à prouver formellement quelles œuvres spécifiques ont été ingérées par le modèle. Une bibliothèque cataloguée avec des marqueurs visuels répétitifs pulvérise cet obstacle technique.
La standardisation permet de changer l'échelle de l'indemnisation. Des milliers d'images techniquement similaires, faisant chacune l'objet d'un dépôt de droits d'auteur distinct, permettent de formuler une demande de dommages-intérêts massive tout en restant extrêmement facile à détailler ligne par ligne — à l'exact opposé d'un éditeur de presse tentant d'évaluer le préjudice subi sur des archives textuelles inquantifiables.
Le cœur de métier d'EVOX est la concession de licences. Une société dont le modèle économique consiste précisément à vendre des licences d'utilisation à l'image près (aux concessionnaires et plateformes auto) dispose de l'argumentaire le plus limpide qui soit concernant le « préjudice commercial » (market harm) : on lui aurait subtilisé ce qui constitue son unique source de revenus.
C'est cette combinaison — dénombrable, identifiable, sous licence — qui explique pourquoi le plaignant le plus dangereux dans une affaire de données d'entraînement IA ressemble moins à un groupe de médias qu'à un catalogue de données visuelles structurées.
Le chiffre qui décidera de l'issue du procès
Voici le mécanisme juridique que la plupart des médias généralistes survoleront, et qui constitue pourtant le véritable champ de bataille.
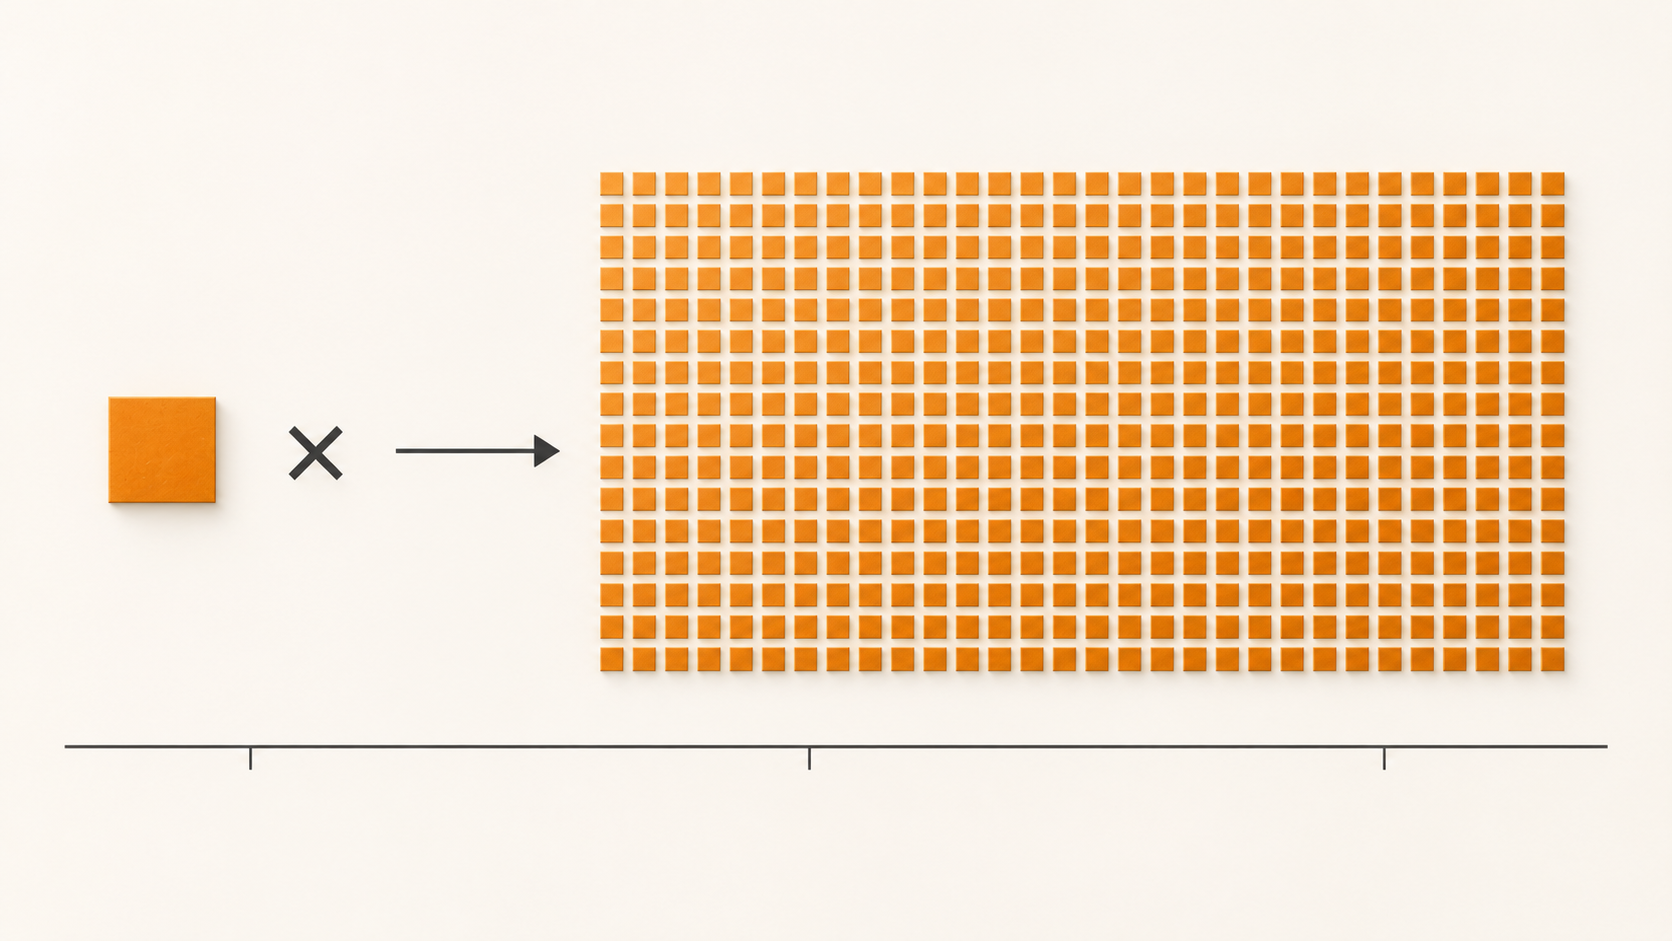
Dans les litiges relatifs aux droits d'auteur aux États-Unis, il est extrêmement complexe de prouver le montant des « dommages réels » (actual damages) qu'un modèle d'IA a causé. C'est pourquoi les avocats des plaignants s'appuient sur les dommages-intérêts légaux (statutory damages). La subtilité des dommages légaux est qu'ils sont accordés pour chaque œuvre enfreinte individuellement, et non sous forme d'un montant global forfaitaire. Par conséquent, l'exposition financière pour l'accusé ne se résume pas à « quel est le montant du préjudice ? », mais à « combien d'œuvres multipliées par le barème légal ? ». Dans une affaire de données d'entraînement IA, ce multiplicateur est le seul enjeu qui compte.
Cela signifie que la question juridique pivot de ce procès sur les données d'entraînement IA n'est pas de savoir si une copie a eu lieu. La question est : chaque photographie compte-t-elle légalement comme une œuvre distincte et indépendante ?
Les dossiers déposés par EVOX dans ses autres litiges parallèles rendent cette stratégie explicite : ils soutiennent que chaque image individuelle constitue une œuvre distincte éligible à sa propre indemnité légale. Dans l'une de ces procédures parallèles, le nombre d'images en litige se chiffre en centaines de milliers. Appliquée ici à une échelle plus modeste (7 095 images), la logique concernant les données d'entraînement IA reste strictement identique : 7 095 images, revendiquées chacune comme une œuvre autonome, transforment une indemnité unitaire modeste en un montant global à forte valeur dissuasive, voire punitive.
Attendez-vous à ce que la défense de ByteDance soutienne la thèse diamétralement opposée : un catalogue commercial constitue en réalité une seule « œuvre de compilation », ou l'ensemble des 7 095 images doit être traité comme une unique « œuvre collective » (collective work), ce qui plafonnerait drastiquement les indemnités à un seul versement. C'est cette bataille mathématique, et non le débat éthique sur l'aspiration des données (scraping), qui déterminera le montant du chèque final.
Pour tous les acteurs de l'industrie développant des modèles à partir de données d'entraînement IA, c'est ce multiplicateur qu'il faut surveiller de près. Un jugement établissant que chaque image aspirée est une œuvre distincte justifiant sa propre indemnisation réévaluerait le risque financier du scraping de données d'entraînement IA pour toute la Silicon Valley du jour au lendemain.
EVOX n'en est pas à son coup d'essai
Un détail fondamental : EVOX poursuit également Midjourney pour l'utilisation de ses images, dans le cadre d'un dossier parallèle sur les données d'entraînement IA. Ce précédent modifie radicalement la lecture que l'on doit faire de cette nouvelle plainte.
Un photographe s'estimant lésé qui intente un procès isolé exprime une doléance personnelle. Un même plaignant qui multiplie les procès contre plusieurs géants de la génération d'images déploie une stratégie corporative : il s'agit d'établir une théorie juridique, de constituer une jurisprudence, et de forcer des accords amiables lucratifs (settlements) ou d'épuiser les défendeurs devant les tribunaux. Les litiges liés aux données d'entraînement IA se consolident exactement sur ce modèle, une poignée de plaignants récurrents concentrant l'essentiel de l'offensive juridique.
La conséquence pratique est que le cas ByteDance ne sera pas jugé en vase clos. Les arguments et décisions rendus dans les affaires parallèles l'influenceront directement, et toute jurisprudence validant l'indemnisation « par œuvre individuelle » (per work) s'exportera instantanément devant d'autres juridictions.
Ce que cela va changer pour les modèles d'images
Si la théorie de l'indemnisation par image aboutit devant un tribunal, trois bouleversements majeurs frapperont l'industrie :
Les données d'entraînement IA deviendront un passif financier chiffrable. Dès lors qu'un multiplicateur « par œuvre » sera juridiquement validé, la taille colossale d'un dataset cessera d'être un avantage concurrentiel gratuit pour devenir un risque comptable majeur. Cela modifiera l'approche des laboratoires d'IA en matière de collecte de données d'entraînement IA de manière bien plus radicale que n'importe quelle charte éthique.
Le marché des licences de données d'entraînement IA deviendra une réalité tangible. Si les catalogues aspirés sans consentement comportent un risque de ruine financière, les catalogues sous licence acquerront une valeur marchande immense. Le marché transactionnel des données d'entraînement IA, purement théorique depuis trois ans, recevra enfin un signal de prix concret.
La traçabilité des données d'entraînement IA passera d'atout marketing à bouclier défensif vital. Être capable de prouver d'où provient chaque image ingérée par le modèle fera la différence entre assumer un coût opérationnel calculable et s'exposer à un risque de faillite illimité.
Ce que cela ne change pas
Il convient d'être clair sur les limites de cette plainte, car la couverture médiatique aura tendance à dramatiser ses conséquences pour les utilisateurs.
Ce procès sur les données d'entraînement IA ne rend pas l'utilisation des générateurs d'images illégale ou risquée pour vous. Il s'agit d'un conflit commercial entre un développeur qui entraîne un modèle et un ayant droit concernant la méthode d'acquisition des données d'entraînement IA. Rien dans cette procédure ne remet en cause la légalité de l'utilisation d'un modèle entraîné par un tiers, et rien n'affecte juridiquement la rédaction de vos requêtes (prompting).
Par ailleurs, cette affaire ne tranche pas l'épineux débat du « fair use » (usage équitable). Le débat juridique visant à déterminer si l'analyse algorithmique de données d'entraînement IA constitue une exception au droit d'auteur fait rage depuis des années sans réponse définitive, et le simple dépôt d'une plainte devant un tribunal de district ne suffira pas à le clore.
Lire l'actualité juridique avec discernement
Quatre nuances indispensables avant de tirer des conclusions hâtives :
Une allégation n'est pas une condamnation. Aucune responsabilité légale n'a été établie, et le chiffre de 7 095 relève du propre décompte à charge du plaignant.
Le comptage des données d'entraînement IA repose sur une méthodologie informatique. Le nombre « 7 095 » reflète la méthode technique employée par EVOX pour identifier ses images dans les sorties du modèle. Que le tribunal accepte la validité de cette méthode d'identification est un autre combat juridique.
La théorie de l'indemnisation « par œuvre » est fortement contestée. C'est l'argument maximaliste du plaignant pour gonfler la facture, ce n'est pas la loi établie.
Les procès en phase initiale évoluent constamment. Dans ce domaine naissant, il est fréquent que les plaintes soient amendées, que certains chefs d'accusation soient rejetés, ou que les parties signent des accords de confidentialité (settlements) avant le procès.
Ce que cela signifie pour vous, créateurs d'images
Si vous entraînez des modèles (Trainers) : la traçabilité de la provenance (provenance) est désormais le cœur de votre gestion des risques. Les données d'entraînement IA que vous utilisez sont devenues un élément du bilan financier de l'entreprise, pas seulement une variable technique.
Si vous possédez des banques d'images (Licensors) : la valeur de votre catalogue vient d'exploser. Les bibliothèques structurées, dénombrables et identifiables sont précisément la bouée de sauvetage légale dont le marché des données d'entraînement IA a désespérément besoin pour prouver sa bonne foi.
Si vous vous contentez de générer des images (Generators) : cette guerre n'est pas la vôtre. Continuez d'utiliser les modèles, d'affiner vos prompts, et observez de loin l'issue du débat sur le paiement « par œuvre individuelle » — car c'est cette facture qui se répercutera in fine sur le prix de votre abonnement mensuel à votre outil d'IA favori.
Un prompt pour illustrer le contexte
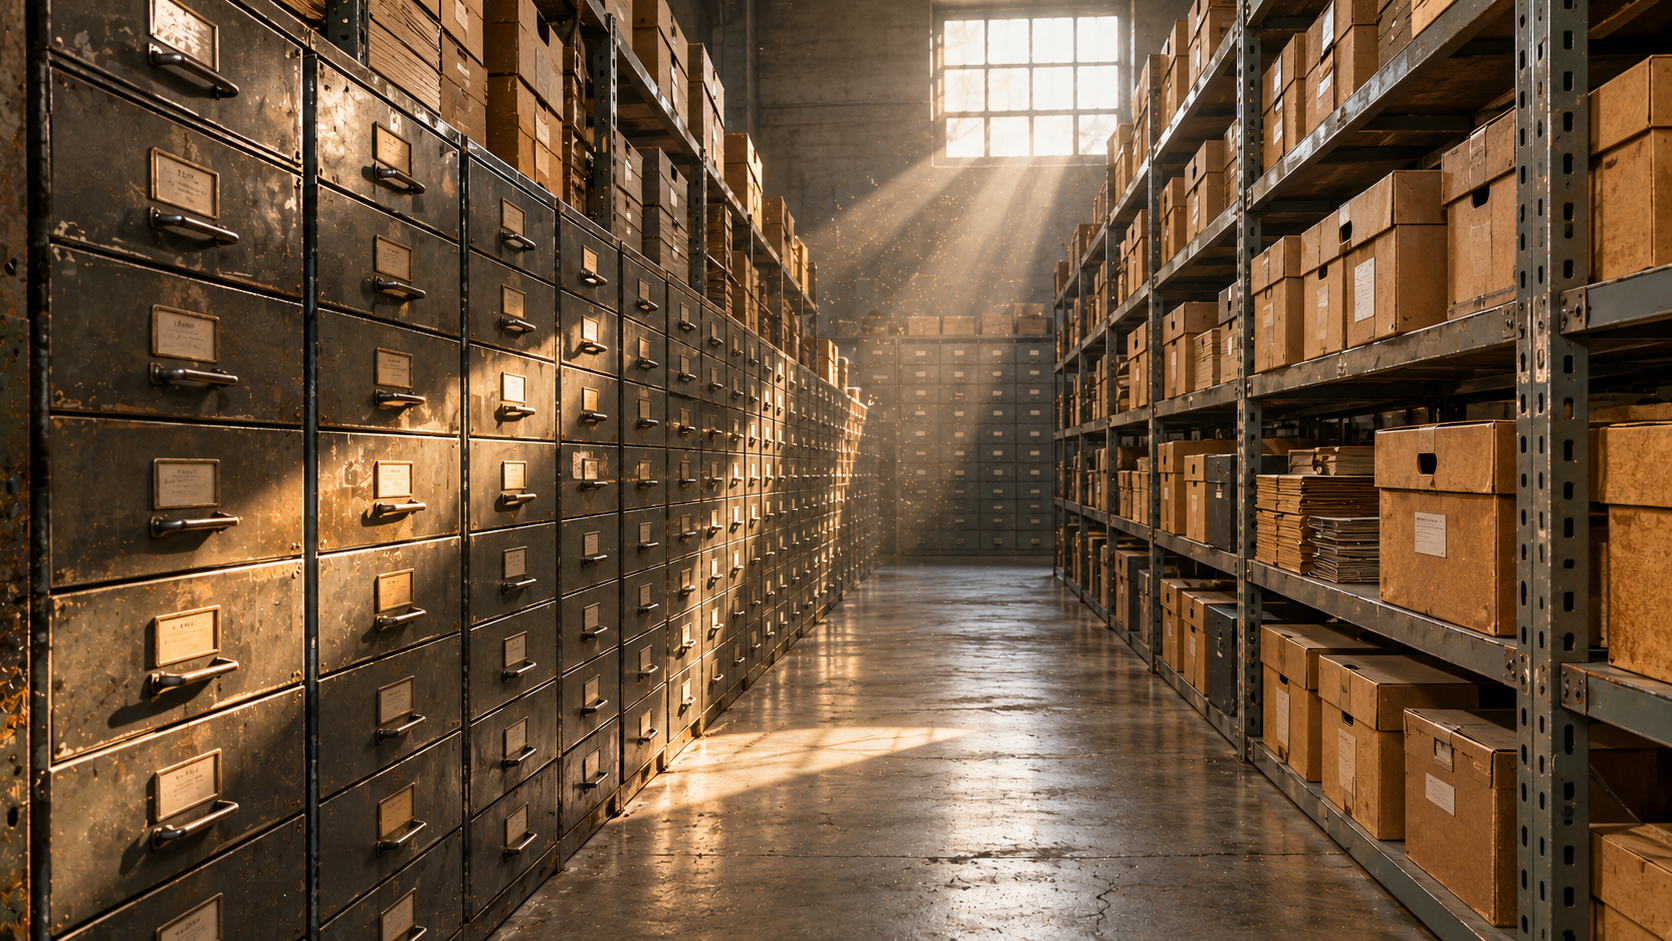
Si vous souhaitez créer une imagerie reflétant l'esprit de cette affaire, le véritable sujet n'est ni un robot ni un marteau de juge, mais l'archive elle-même — la bibliothèque physique qui donne son sens et sa valeur à une entreprise de catalogues d'images.
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
A wide documentary photograph down the aisle of a vast photographic archive: long rows of steel filing drawers receding into dim depth on both sides, cardboard slide boxes stacked on open metal shelves, a single shaft of daylight falling from a high window and catching dust in the air. Fine detail in the brushed steel drawer fronts, worn paper labels and the fibre of the cardboard boxes, cool grey and warm sepia palette, deep perspective, slight vignetting at the frame edges, 16:9 framing, 8K detail, no people, no legible text.
Dans l'industrie actuelle de l'IA, les « archives photographiques » représentent la seule image dont la valorisation en millions de dollars dépend exclusivement de la capacité à prouver, avec une exactitude mathématique, ce qui y est stocké.
Pourquoi Fanch AI est votre meilleur allié dans ce contexte
La bataille juridique entourant les données d'entraînement IA porte sur la manière dont les grandes entreprises de la tech aspirent et stockent les bibliothèques d'images d'autrui, et non sur la légitimité pour les créatifs d'utiliser des outils de génération. Cette nuance est fondamentale : le risque légal pèse sur l'ingénieur qui scrape le web pour entraîner le réseau, pas sur le créateur qui tape un prompt derrière son écran.
Fanch AI met à votre disposition un modèle de génération d'images dédié que vous pilotez avec des prompts de haute précision. Cela vous permet de générer l'imagerie dont vous avez besoin directement à partir de votre description créative, sans dépendre du catalogue d'images d'un tiers — garantissant ainsi que vos œuvres, vos idées et vos droits d'exploitation restent propres et incontestablement vôtres.