
Higgsfield fait passer la vidéo IA de 1 minute à plus de 10 minutes | Fanch AI
La brièveté des plans a longtemps constitué la limite structurelle de la vidéo IA (AI video). La plupart des générateurs s'arrêtent au bout de quelques secondes ; même les outils les plus poussés plafonnent généralement autour d'une minute. Higgsfield affirme avoir franchi ce plafond, passant d'environ une minute à plus de 10 minutes de rendu ininterrompu. Si ce résultat se confirme, il s'agit de la plus importante évolution dans la vidéo IA depuis un an.
Cette avancée est issue d'une étude de cas client publiée cette semaine par OpenAI, offrant un éclairage précieux sur l'avenir de la vidéo IA long format. C'est également une annonce à analyser avec rigueur — les déclarations des éditeurs de vidéo IA devançant souvent les bancs d'essai indépendants.
Ce que Higgsfield a concrètement transformé
Selon le compte-rendu d'OpenAI, Higgsfield a mis au point un workflow basé sur GPT-6 Astra qui produit des vidéos pédagogiques de plus de 10 minutes pour sa chaîne YouTube. Le PDG et cofondateur de Higgsfield, Alex Mashrabov, a précisé que les générations précédentes étaient bridées à environ une minute.
Le basculement opérationnel est déterminant : un rendu plus étendu signifie l'absence de montage manuel pour les formats de durée intermédiaire. Au lieu d'assembler une douzaine de séquences courtes sur un banc de montage, une équipe peut sortir d'un seul bloc une vidéo IA continue — du moins selon les affirmations des deux entreprises.
Mashrabov décrit cette avancée comme la possibilité pour un créateur unique de piloter une production haut de gamme de bout en bout, sans mobiliser une équipe pour réaligner des fragments disparates. C'est toute la promesse de la vidéo IA long format : moins d'intermédiaires, moins de raccords visibles.
L'architecture logicielle sous-jacente
Le processus de Higgsfield associe la génération vidéo à l'orchestration logicielle. D'après OpenAI, deux briques majeures composent cette chaîne de production moderne de vidéo IA :
- GPT-6 Astra — assure la génération de la vidéo IA et anime les agents créatifs chargés d'automatiser les tâches de production répétitives, comme la création de variantes de plans.
- L'appel d'outils (Tool calling) — GPT-6 Astra permet à ces agents d'invoquer des outils tiers pour des opérations manuelles complexes, dont la modélisation 3D.
Le recours à la modélisation 3D constitue l'élément le plus révélateur. Mashrabov lie directement l'usage de cet outil à la cohérence spatiale : lorsque la géométrie d'une même scène peut être réinterrogée de façon stable, le modèle dispose d'un point d'ancrage fixe au lieu de réinventer l'espace physique à chaque plan. C'est exactement l'infrastructure technique requise pour une vidéo IA longue.
Un second modèle, GPT-Image-2.5, interviendrait pour le contrôle visuel de précision — la couche qui empêche les traits des personnages et les styles de dériver tout au long d'une vidéo IA. Ensemble, ils forment une pile d'outils cohérente plutôt qu'un générateur isolé, démarquant ce workflow d'un outil de plans courts.
Pourquoi la cohérence représentait le véritable obstacle
La durée brute n'a jamais été la difficulté majeure ; c'était la continuité temporelle. Une séquence de vidéo IA de 10 secondes peut dissimuler presque n'importe quelle anomalie ; une séquence de 10 minutes expose le moindre défaut.
Les traits des visages fluctuent, les vêtements changent de texture, le mobilier se déplace et l'éclairage varie d'un plan à l'autre. Le spectateur tolère ces anomalies dans un mème rapide, mais décroche immédiatement d'un tutoriel. C'est la raison pour laquelle la vidéo IA long format est restée en retrait par rapport aux plans courts, malgré les progrès graphiques spectaculaires. Toutes les feuilles de route de la vidéo IA se heurtent à cet écueil.
L'approche de Higgsfield — combinant agents, outils spécialisés et couche de contrôle — tente de maintenir la stabilité d'un univers visuel sur de nombreuses itérations. Si la méthode est validée, l'intérêt ne portera pas seulement sur la durée, mais sur la viabilité même du format.
Pourquoi la prudence reste de mise
C'est le point que la plupart des commentaires omettent : les données chiffrées émanent exclusivement d'OpenAI et de Higgsfield. Comme l'a relevé l'analyse de Data Phoenix, cette communication ne s'accompagne d'aucun banc d'essai indépendant évaluant la qualité du rendu, le temps de calcul, le coût de revient ou le volume d'intervention humaine requis.
La communication ne précise pas non plus si la vidéo IA finale de 10 minutes découle d'un rendu unique du modèle ou d'une orchestration de multiples segments courts assemblés par voie logicielle. Ces deux architectures répondent à des réalités techniques radicalement différentes, ce qui compte pour quiconque conçoit un pipeline de vidéo IA.
Il convient donc de considérer ces 10 minutes comme des performances déclarées par l'éditeur jusqu'à publication de tests tiers. Cela ne disqualifie pas l'annonce, mais impose de tester avant de reconstruire sa chaîne de travail. Douter d'une annonce de vidéo IA ne coûte rien ; réorganiser sa production sur une fausse promesse s'avère très onéreux. Et si les chiffres se vérifient, c'est l'ensemble de la vidéo moyen format qui basculera.
Ce que cela implique pour les créateurs
Trois constats s'imposent aux professionnels de la vidéo IA :
- La continuité est le nouveau champ de bataille — la vraie valeur ne réside plus dans la durée du plan, mais dans la stabilité d'un raccord à l'autre.
- L'orchestration surpasse le générateur unique — agents, outils tiers et calques de référence constituent la méthode pour fabriquer une vidéo IA longue.
- Les chiffres des éditeurs doivent être éprouvés — validez toujours les promesses sur vos propres scénarios de production.
- Le moyen format devient crédible — vidéos explicatives, cours en ligne et modules de formation sont les premiers segments concernés.
À court terme, l'impact se fera sentir sur la vidéo IA pédagogique et technique, et non sur le cinéma de fiction. Il s'agit néanmoins d'un marché immense, où la vidéo IA peut s'imposer par l'efficacité économique avant de triompher par la virtuosité artistique.
Un prompt à tester aujourd'hui
La cohérence commence par une description visuelle claire et reproductible — la discipline dont dépend toute vidéo IA d'envergure. Testez ceci sur Fanch AI :
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
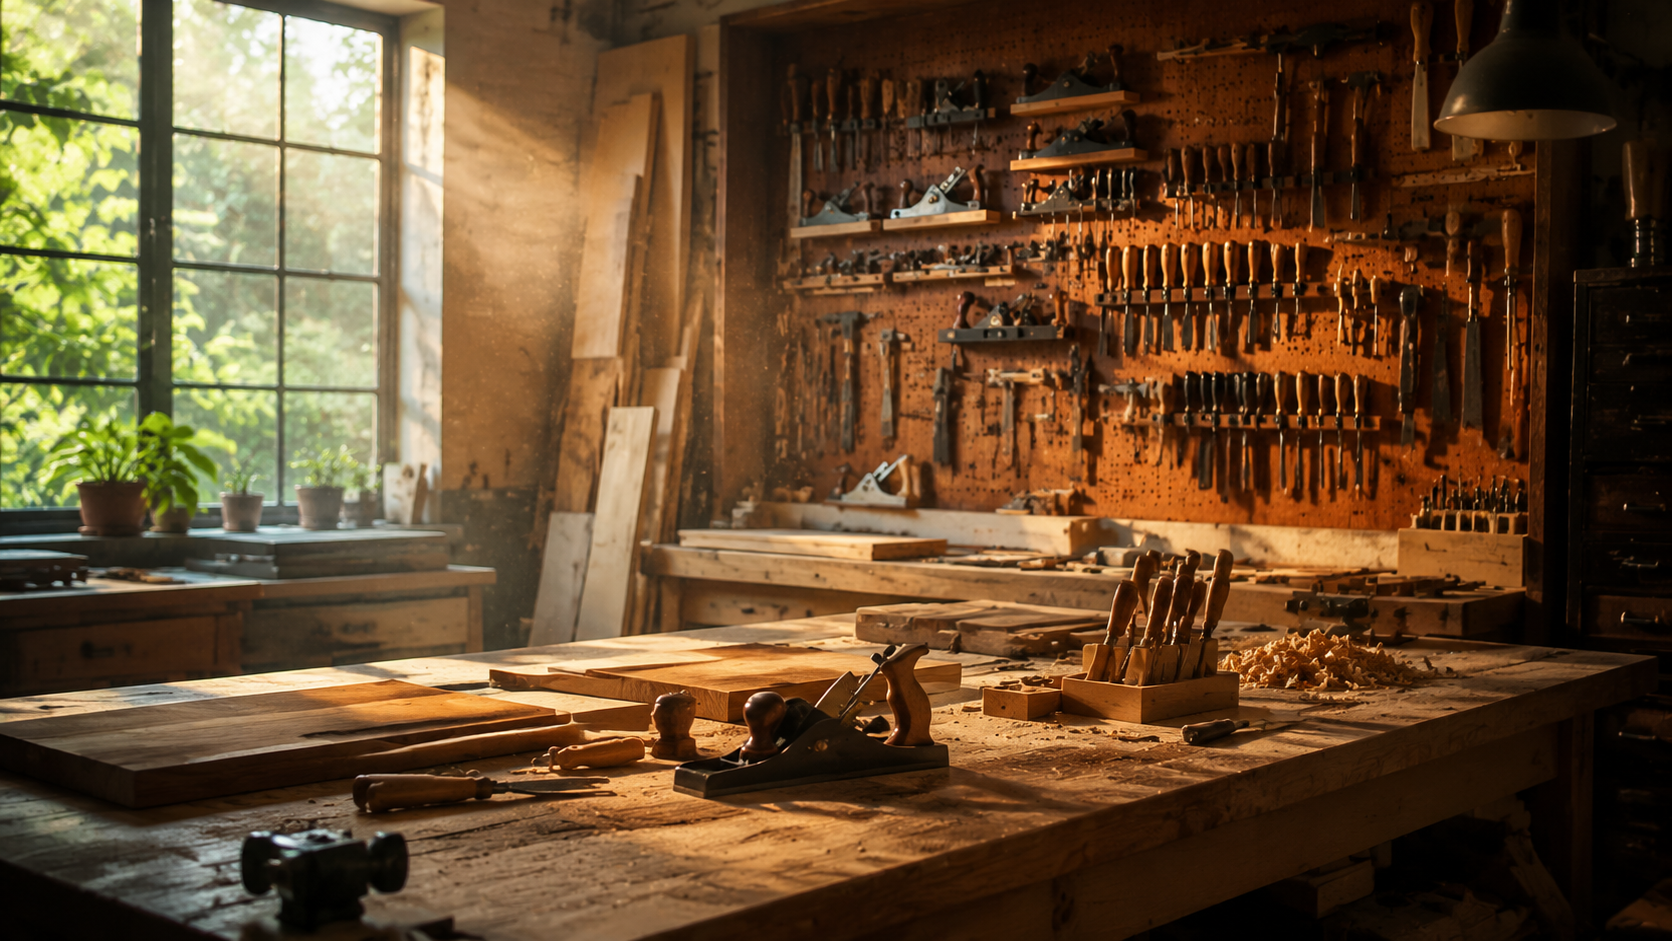
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
Pourquoi Fanch AI s'intègre dans ce workflow
Que vous prépariez une vidéo IA longue ou un plan unique, l'image de référence prime toujours. Fanch AI vous met à disposition un modèle d'image dédié que vous pilotez avec des prompts précis — vous permettant de figer les traits d'un personnage, sa garde-robe et son éclairage avant de lancer la moindre seconde de vidéo IA. Une continuité réussie repose sur d'excellents visuels fixes, et disposer d'une image de référence parfaitement maîtrisée est le meilleur investissement pour votre projet de vidéo IA.