
Un nouveau benchmark de vidéo IA révèle une fracture nette entre qualité visuelle et garde-fous | Fanch AI
Un nouveau benchmark de vidéo IA (AI video benchmark) publié à Hong Kong met en lumière une réalité technique inconfortable pour l'ensemble des acteurs. Cette évaluation, menée par l'école de commerce de l'Université de Hong Kong (HKU), établit que les modèles de vidéo chinois dominent désormais sur le terrain de la qualité visuelle brute — Seedance 2.0 Pro se classant au premier rang des capacités de génération devant Veo 3.1 et Sora 2 Pro —, tandis que ces mêmes modèles marquent le pas sur le plan des mécanismes de protection et de sécurité.
Cette dualité donne à ce benchmark de vidéo IA une portée qui dépasse largement l'effet d'annonce. Il s'agit de la première étude d'envergure évaluant simultanément la fidélité graphique et la robustesse éthique au sein d'un même protocole, et les deux volets de l'analyse pointent dans des directions résolument opposées.
Les conclusions majeures du rapport de l'HKU
Trois enseignements principaux structurent ce benchmark de vidéo IA :
La hiérarchie de la qualité visuelle s'est inversée. Dans ce benchmark de vidéo IA, le modèle chinois de tête a devancé les fleurons américains sur les métriques de rendu visuel. Cette observation contredit l'hypothèse prévalant au début de l'année 2026, selon laquelle Veo et Sora constituaient le plafond indépassable de l'industrie — une certitude que ce classement remet directement en cause.
Les systèmes de modération n'ont pas progressé au même rythme. Le même travail montre que les modèles chinois affichent une vigilance moindre sur les garde-fous et les dispositifs défensifs — le rapport formulant lui-même le constat d'une orientation claire vers l'excellence visuelle au détriment de la fermeté des filtres de sécurité.
Cet écart découle d'un arbitrage assumé. Pris dans leur globalité, ces résultats décrivent des modèles paramétrés pour maximiser le rendu graphique plutôt que pour multiplier les refus de traitement. Il s'agit d'un choix de conception logicielle délibéré, et seule une méthodologie mesurant conjointement ces deux dimensions permet de le mettre en évidence.
Pourquoi une école de commerce a-t-elle conduit ce banc d'essai ?
L'origine d'une évaluation conditionne la façon dont il convient d'en interpréter la portée. Il ne s'agit pas d'un travail mené par un laboratoire d'informatique théorique mesurant des ratios PSNR sur des bases synthétiques. L'étude émane de l'école de commerce de l'HKU, ce qui oriente directement les questions posées : applicabilité opérationnelle, tenue du produit en conditions réelles et politique de gestion des risques pour les entreprises utilisatrices.
Cette approche rend ce benchmark de vidéo IA particulièrement utile pour les décideurs et directeurs de production. Il s'attache à déterminer « quel outil délivre le résultat attendu et quelles requêtes il refuse d'exécuter », plutôt que de chercher « quelle fonction de coût optimise mathématiquement l'architecture ».
Cette posture impose également des limites méthodologiques évidentes. L'analyse d'une seule institution dotée de son propre barème fournit un repère précieux, mais ne saurait constituer une vérité définitive. Aucun article évalué par les pairs n'étaye formellement cette publication à ce jour, et le corpus de prompts, les coefficients de pondération et les versions de modèles testées relèvent des choix propres aux auteurs.
Que recouvrent concrètement les « garde-fous » d'un modèle vidéo ?
Pour les modèles textuels, la sécurité relève d'une logique binaire : la requête est-elle rejetée ou honorée ? En vidéo, la dynamique s'avère nettement plus complexe, et c'est précisément là que l'évaluation comparative prend tout son sens.
Pour un modèle génératif vidéo, le volet défensif recouvre plusieurs réalités techniques : la capacité à bloquer les prompts explicitement proscrits ; la fermeté du filtre lorsque l'intention interdite est dissimulée sous une tournure innocente ; la qualité de la dégradation de l'image (refus propre plutôt que production d'un fichier corrompu) ; et le traitement déterministe, et non aléatoire, des thématiques sensibles avérées (droit à l'image, violence, contenus suggestifs).
Un modèle brillant sur le réalisme visuel mais permissif sur ces comportements correspond à un profil d'usage très précis : exceptionnel entre les mains d'un professionnel encadrant strictement ses requêtes, risqué pour une plateforme grand public ouverte à tous les flux. Un benchmark de vidéo IA quantifiant ces deux données permet d'arbitrer en toute connaissance de cause.
Garder un esprit critique face aux résultats publiés
Quatre réserves fondamentales méritent d'être gardées à l'esprit face à ces données :
Une étude unique ne constitue pas une loi générale. Le travail d'un seul institut offre un faisceau d'indices substantiel, non une vérité immuable. Le protocole n'a pas encore fait l'objet d'une reproduction indépendante.
Les hiérarchies techniques deviennent rapidement obsolètes. Aucun benchmark de vidéo IA ne conserve sa pertinence au-delà d'un trimestre. Veo 3.1, Sora 2 Pro et Seedance 2.0 Pro sont des versions récentes dont les itérations suivantes sont déjà en cours d'entraînement. Toute comparaison n'est que la photographie instantanée d'un secteur en mutation perpétuelle.
La « qualité visuelle » reste une construction méthodologique. Elle dépend strictement de ce que privilégie le barème : fluidité des trajectoires, finesse des matières, justesse des éclairages, fidélité au texte ou simple appréciation esthétique humaine. Deux démarches rigoureuses peuvent aboutir à des classements divergents.
La géographie n'est pas le paramètre déterminant. La lecture féconde de ce travail ne réside pas dans l'opposition entre modèles chinois et américains, mais dans la comparaison entre modèles réglés pour la puissance d'affichage et modèles bridés par la prudence défensive. La dimension géopolitique fait le buzz ; l'arbitrage fonctionnel fait la pédagogie.
Les conséquences concrètes pour les créateurs de vidéo
Si vous intégrez les données de ce benchmark de vidéo IA dans votre pratique professionnelle, trois réflexes s'imposent :
Cessez de considérer les solutions américaines comme l'unique référence de qualité. Le retard a été rattrapé sur le rendu visuel pur. Si vous aviez écarté des outils comme Seedance pour des motifs graphiques, une réévaluation s'impose.
Évaluez les seuils de blocage avant d'engager vos chaînes de production. Un modèle peu restrictif offre une plus grande liberté sur les scénarios atypiques, mais impose de prendre en charge la modération en interne.
Sélectionnez vos outils en fonction du plan à réaliser, pas de la notoriété de la marque. Le modèle en tête d'un classement généraliste peut tout à fait échouer sur votre découpage technique spécifique. L'intérêt d'un comparatif est précisément de substituer l'analyse technique aux préférences de marque.
Comment réaliser son propre protocole de test interne
La réaction la plus pragmatique face aux bancs d'essai publiés consiste à mener sa propre batterie de tests ciblés. Cela demande une vingtaine de minutes :
1. Fixez cinq prompts représentatifs. Couvrez vos besoins réels : déplacement de personnage, mouvement d'appareil, gros plan sur une texture complexe, surface comportant du texte et concept abstrait.
2. Verrouillez les paramètres d'encadrement. Conservez le même ratio, la même durée et la même graine (seed) lorsque l'option existe, afin d'évaluer les moteurs et non les réglages.
3. Limitez l'évaluation à trois critères stricts. Prise en compte du prompt, continuité temporelle du mouvement et absence d'artefacts graphiques. Multiplier les axes disperse l'analyse.
4. Visionnez systématiquement à vitesse réelle. L'avance rapide masque les décrochages cinétiques, qui constituent précisément le point de rupture des vidéos générées.
5. Réactualisez votre protocole tous les trois mois. Les classements publics vieillissent vite ; vos repères internes nécessitent la même veille régulière.
Un prompt d'évaluation à exécuter
Pour éprouver la continuité temporelle d'un modèle, utilisez un plan combinant une trajectoire de sujet lisible et un déplacement d'appareil maîtrisé :
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
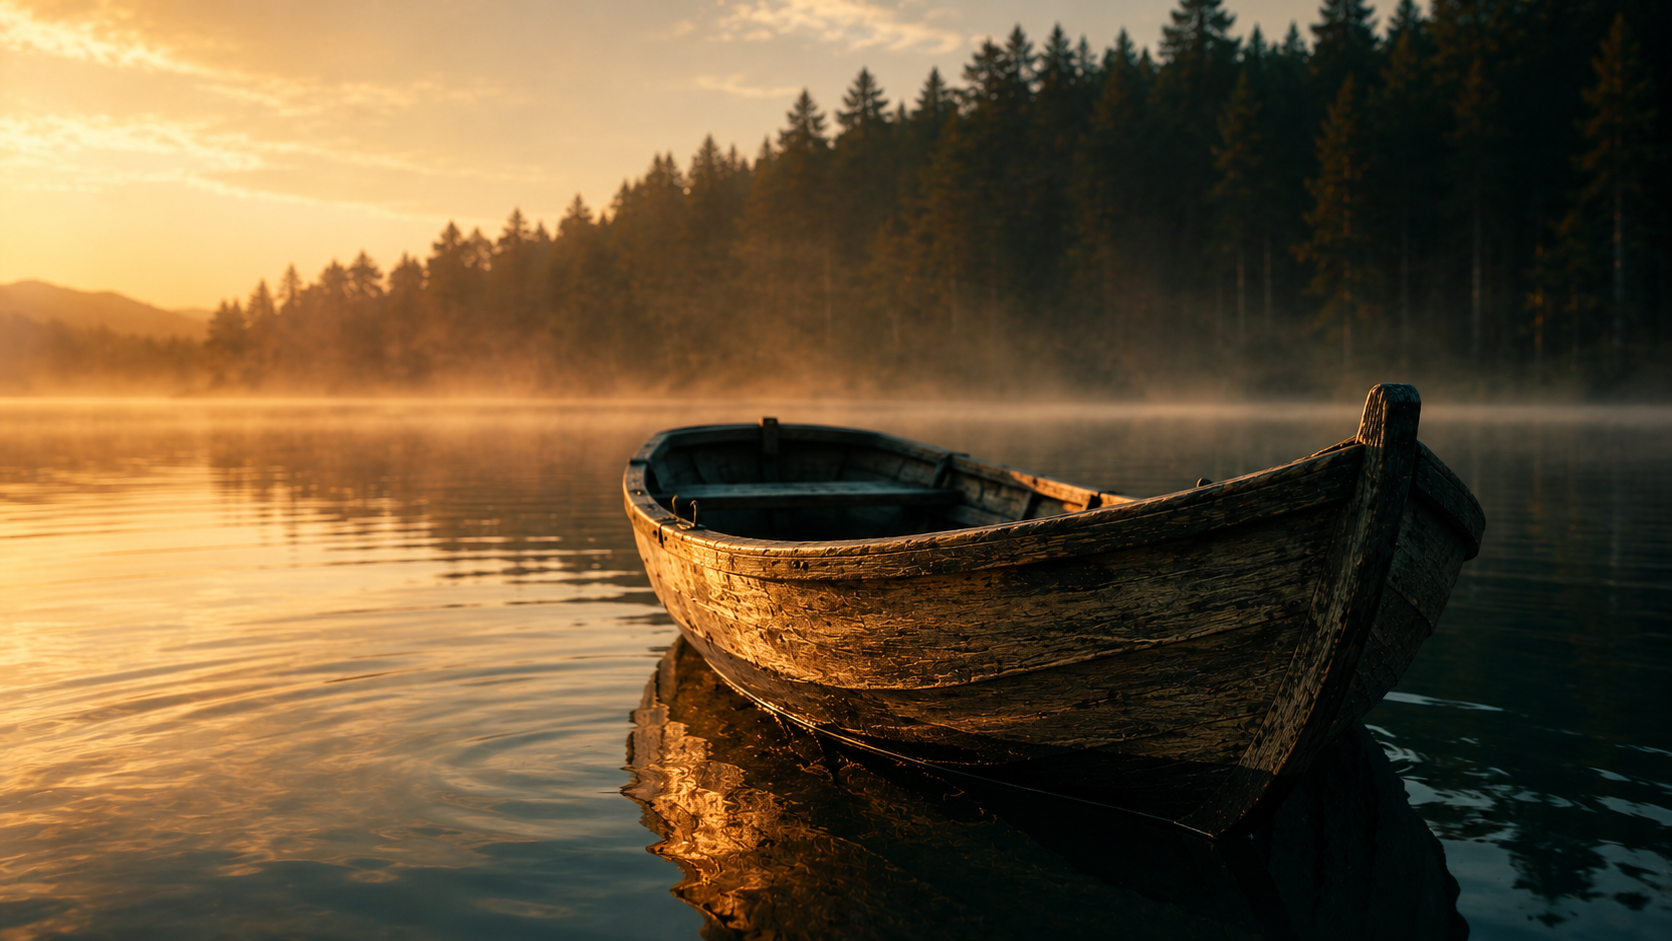
A cinematic still of a lone wooden rowboat drifting on a calm lake at golden hour, seen from a low angle just above the waterline: warm rim light along the hull, gentle ripples spreading outward, distant mist-covered pine treeline, soft haze in the air. Fine detail in the wet wood grain and water surface, shallow depth of field, warm amber and cool teal palette, 16:9 framing, 8K detail, no text overlay.
Générez ce visuel fixe de référence, puis confiez-le au modèle vidéo pour observer le comportement des reflets aquatiques et des micro-textures au fil du mouvement.
Pourquoi Fanch AI fiabilise votre démarche
Le principal enseignement d'un benchmark de vidéo IA rigoureux est que le resserrement des performances brutes redonne toute sa valeur à la précision du prompt. Fanch AI met à votre disposition un modèle d'image dédié pour caler vos choix de cadre et de lumière sur une image fixe économique avant d'engager vos crédits vidéo, vous permettant ainsi de comparer les outils sur une base visuelle parfaitement maîtrisée.