
Génération locale d'images par IA : Ce que vous coûte réellement la carte graphique que vous possédez déjà | Fanch AI
L'argument en faveur de la génération locale d'images par IA (local AI image generation) paraît imparable : puisque vous possédez déjà une carte graphique puissante, le coût marginal de chaque image devient nul. Un article remarqué de XDA résumait exactement la situation ainsi : exécuter recherche, génération de code et création visuelle sur un unique GPU déjà amorti, sans débourser le moindre centime d'abonnement.
Ce constat est à la fois exact et incomplet. La génération locale d'images par IA offre bel et bien un coût marginal par image proche de zéro. Mais elle s'accompagne d'une facture sous-jacente qui se règle dans trois monnaies absentes des gros titres : la facture d'électricité, le temps d'administration système et l'écart qualitatif sur les rendus.
Voici la réalité concrète de cet environnement technique, son coût réel à l'usage, et les cas précis où la génération locale d'images par IA s'impose sans discussion.
La réalité d'une pile logicielle auto-hébergée
L'installation mise en avant dans cet article n'est pas une simple collection de scripts bricolés. Il s'agit d'une application unifiée reposant sur Pixeltable, combinant plusieurs modèles spécialisés : un modèle d'image open-source pour la création visuelle, un modèle dédié au code et un modèle MoE (mélange d'experts) pour l'analyse documentaire.
La configuration de référence pour cette génération locale d'images par IA s'articule autour d'une RTX 4070 Ti Super 16 Go, faisant tourner FLUX pour les images et Qwen pour le développement. Nous parlons d'une carte graphique grand public de milieu de gamme, pas d'un serveur d'entreprise. Le ticket d'entrée pour la génération locale d'images par IA se résume désormais à « une carte graphique que vous avez peut-être déjà dans votre tour ».
L'intérêt principal réside dans l'intégration de l'ensemble. La plupart des utilisateurs travaillant en local jonglent entre trois interfaces cloisonnées. Rassembler génération d'images, assistance au code et synthèse documentaire au sein d'un même pipeline relève d'une optimisation de méthode de travail, non d'une prouesse matérielle.
Pourquoi l'idée d'une « carte graphique gratuite » n'est que partiellement vraie
L'équation économique de la génération locale d'images par IA repose sur un principe financier bien connu : les coûts irrécupérables sont déjà payés. Si votre carte graphique est déjà installée pour le jeu vidéo ou le montage vidéo 4K, le coût incrémental pour générer des images se résume à l'électricité consommée.
Faites le calcul pour votre propre matériel : relevez la puissance absorbée par la carte en pleine charge (environ 300W pour ce segment). Une heure de rendu continu correspond à 0,3 kWh. Avec un kilowatt-heure à environ 0,20 $, cela représente six centimes de dollar par heure de calcul. Selon vos réglages et le modèle employé, une heure de génération locale d'images par IA produit davantage d'images qu'un mois d'utilisation standard d'une API commerciale.
L'intérêt financier immédiat est indiscutable, et c'est ce qui pousse tant de créateurs vers l'auto-hébergement. Mais ce calcul n'éclaire qu'une seule ligne du grand livre de comptes.
Les coûts cachés que personne ne quantifie
Votre temps de travail. Maintenir opérationnelle une installation de génération locale d'images par IA exige une veille technique permanente. Les poids des modèles évoluent, les nœuds personnalisés de ComfyUI cessent de fonctionner, les pilotes graphiques régressent et l'environnement logiciel refuse de démarrer sans raison apparente. Si le dépannage informatique vous passionne, c'est un passe-temps valorisant ; si votre priorité est de livrer des visuels à des clients, cela devient une tâche administrative non rémunérée.
L'écart qualitatif persistant. C'est la réalité la plus concrète de la génération locale d'images par IA. Les modèles propriétaires hébergés dans le cloud conservent une nette avance sur le rendu des micro-textures, la lisibilité des typographies complexes et la justesse anatomique des corps. Faire tourner des modèles sur une carte de 16 Go impose d'employer des versions quantifiées (quantized), or la quantification rogne précisément sur ces finesses de rendu.
L'absence totale d'engagement de service (SLA). Lorsqu'un service cloud rencontre une panne, des équipes d'ingénieurs s'attellent à la résoudre. Votre installation locale s'arrête net dès que votre matériel surchauffe ou qu'une bibliothèque Python entre en conflit avec une mise à jour système.
Le partage au sein d'une équipe. Dès qu'un collaborateur doit lui aussi générer des images, votre poste de travail se transforme en serveur improvisé. Vous héritez alors de toutes les contraintes d'une infrastructure réseau partagée, avec une astreinte technique qui repose sur vous.
Les 4 cas où la génération locale surpasse tout le reste
Dans ces quatre contextes d'usage, le passage au local est largement rentabilisé :
Les volumes de production massifs. Une fois le matériel amorti, le coût de la génération locale d'images par IA dépend uniquement de votre patience, plus de votre carte bancaire. Vous pouvez lancer des centaines de variations pendant la nuit sans surcoût.
La confidentialité absolue des données. Les images générées et vos prompts ne quittent jamais votre disque dur. Pour les mandats professionnels encadrés par des accords stricts de non-divulgation (NDA), la génération locale d'images par IA élimine d'emblée toute préoccupation juridique liée au cloud.
La fixation d'un style sur mesure. Ajuster finement (fine-tuning / LoRA) un modèle ouvert sur vos propres créations permet de verrouiller une identité visuelle singulière qu'aucun prompt ne peut répliquer sur un modèle généraliste. C'est l'argument le plus fort en faveur de la voie locale.
L'affranchissement des filtres de modération. Si vos requêtes professionnelles légitimes se heurtent régulièrement aux blocages préventifs des modèles hébergés, disposer de son propre moteur lève ce goulet d'étranglement. La génération locale d'images par IA n'impose aucune censure d'entreprise — ce qui offre une totale liberté créative tout en engageant votre entière responsabilité.
Les cas où le local est perdant
La lucidité impose d'admettre les limites inverses :
Si votre cahier des charges exige une restitution parfaite des matières, des inscriptions typographiques impeccables ou des poses complexes sans retouche manuelle, les modèles frontières du cloud restent indispensables. Si vous avez besoin d'un outil accessible instantanément par plusieurs collaborateurs depuis un simple navigateur, vous décrivez un service hébergé en SaaS. Et si votre usage est épisodique, l'économie d'électricité ne compensera jamais le temps investi à configurer votre environnement local.
La grille de décision est simple : la génération locale d'images par IA répond aux impératifs de volume, de confidentialité et de personnalisation poussée ; les solutions hébergées privilégient la simplicité opérationnelle, la qualité brute de premier ordre et l'absence totale de maintenance.
La réalité d'une limite à 16 Go de VRAM
Seize gigaoctets constituent un seuil matériel strict qui détermine ce que votre installation de génération locale d'images par IA peut réellement accomplir.
Cette enveloppe suffit amplement pour exécuter un modèle d'image correctement quantifié. En revanche, faire tourner un grand modèle de langage MoE en pleine précision est hors de portée : vous devrez utiliser des déclinaisons fortement compressées dont les pertes de cohérence sont manifestes. Quant à la génération vidéo sur 16 Go, elle relève encore de la bidouille expérimentale, loin d'un flux de production fluide.
Une carte de 16 Go est donc un excellent moteur de génération locale d'images par IA, mais un environnement très contraint pour le reste des usages d'IA générative lourde. Si l'image représente 80 % de votre activité, l'équipement est idéal ; si elle ne compte que pour 20 %, vous consentez à de lourds compromis pour les 80 % restants.
Méthode pragmatique pour démarrer
1. Commencez par l'image seule. Oubliez les chaînes logicielles complexes tant que votre flux de génération visuelle n'est pas parfaitement stable. Un modèle, un chargeur, un dossier de sortie.
2. Choisissez délibérément votre niveau de quantification. Évaluez le même prompt sous deux précisions différentes. L'écart visuel vous indiquera le seuil qualitatif réel que votre carte peut livrer à un client.
3. Chronométrez votre temps d'installation. Ne mesurez pas la vitesse de calcul de la puce, mais le temps passé à configurer le système. Ce total représente votre véritable coût d'entrée, que presque personne ne prend la peine de calculer.
4. Conservez un recours dans le cloud. Appuyez-vous sur la génération locale d'images par IA pour explorer en masse et produire vos ébauches, puis basculez sur un modèle hébergé lorsque vous devez livrer un visuel final irréprochable. C'est l'organisation hybride retenue par la majorité des professionnels.
5. Réévaluez votre installation tous les six mois. L'écosystème open-source progresse à un rythme effréné et les écarts de rendu diminuent. L'arbitrage technique que vous posez aujourd'hui sera profondément renouvelé d'ici l'année prochaine.
Un prompt d'étalonnage à tester
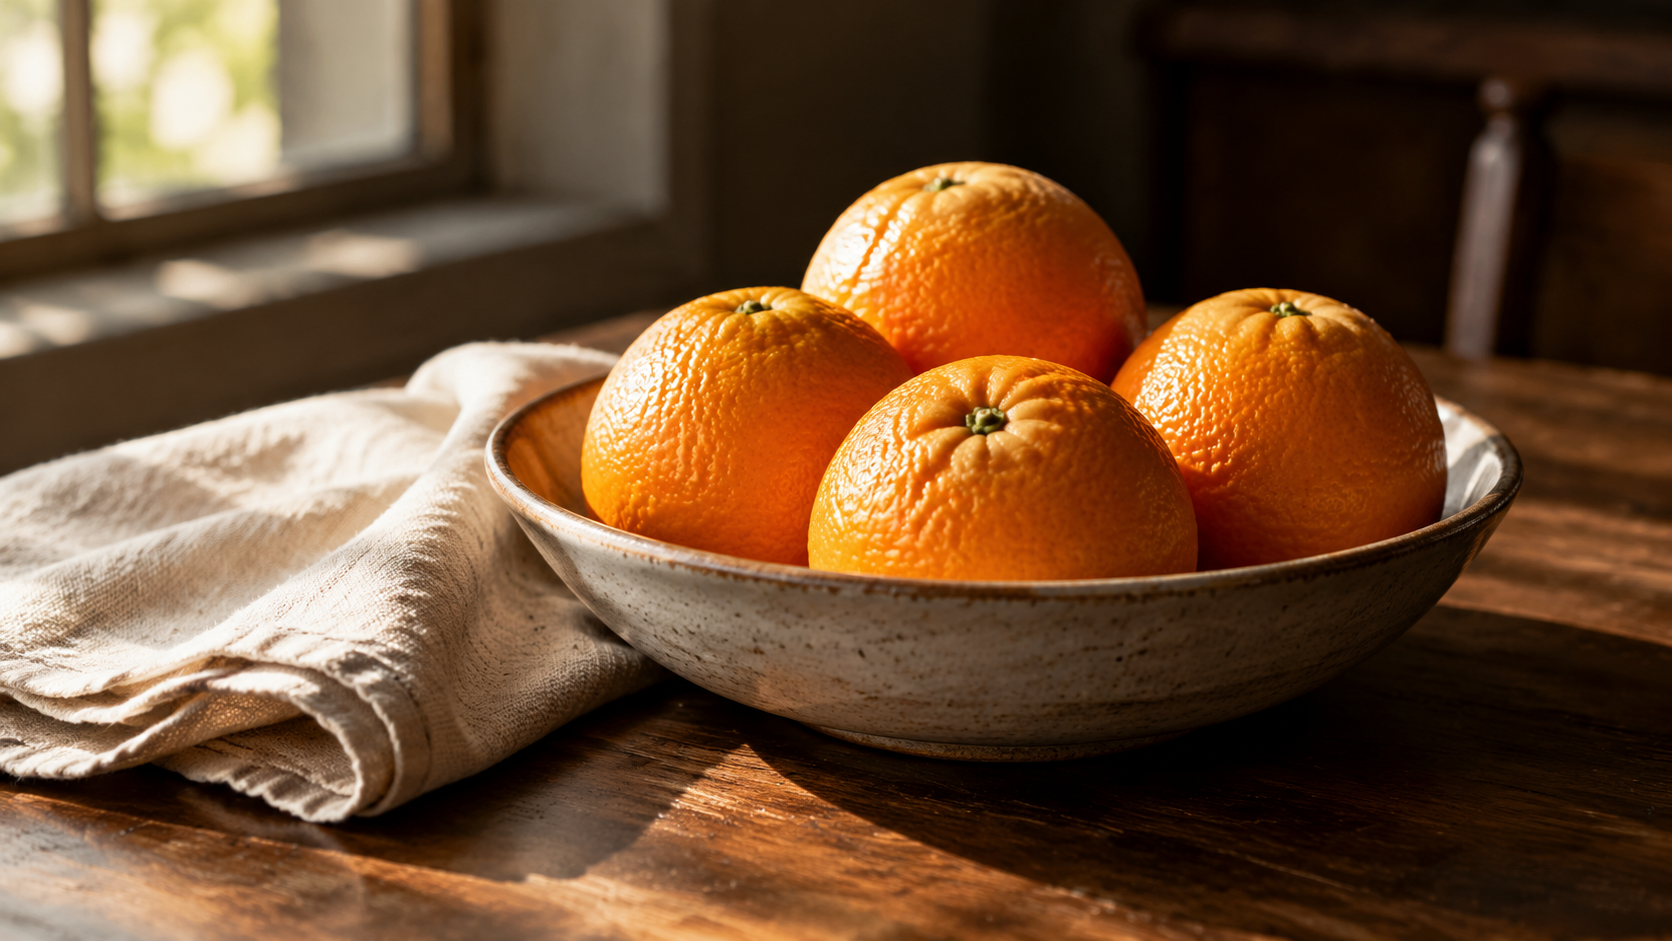
Avant d'investir un week-end complet dans la configuration d'un environnement local, vérifiez si le modèle envisagé sait gérer les sujets que vous vendez au quotidien. La nature morte met immédiatement en évidence la physique de la lumière et la finesse des surfaces :
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
A moody editorial still life on a dark walnut table: a shallow ceramic bowl holding four ripe oranges, a folded linen napkin beside it, soft window light from the left falling across the fruit, deep shadows in the background. Visible texture in the orange peel and the ceramic glaze, muted warm palette, shallow depth of field, fine film grain, 16:9 framing, 8K detail, no people, no brand logos, no text overlay.
Exécutez ce même prompt sur votre propre installation de génération locale d'images par IA. Cette comparaison directe constitue le seul banc d'essai véritablement pertinent pour vos besoins professionnels.
Pourquoi Fanch AI complète idéalement cette organisation
La génération locale d'images par IA apporte une réponse imbattable pour le volume, la protection des données et le contrôle sur mesure ; elle est en revanche inadaptée quand vous devez obtenir un visuel de premier ordre en quelques minutes. La plupart des créateurs associent judicieusement ces deux mondes : la méthode la plus productive consiste à verrouiller d'abord la composition sur une plateforme souple et accessible.
Fanch AI met à votre disposition un modèle d'image dédié que vous dirigez au moyen de prompts précis, vous permettant d'arrêter votre cadrage, votre lumière et votre palette dans des conditions idéales, avant de décliner vos concepts à grande échelle sur votre propre matériel.