
7,095枚の画像:ByteDance の画像生成AI訴訟の行方を決める「数字の魔力」 | Fanch AI
7,095(ナナセンキュウジュウゴ)。「数百万枚の画像」でも、「インターネット上の膨大なデータ」でもありません。7,095 枚の写真。棚卸しの在庫数のように具体的なこの数字には、明確な理由があります。
自動車写真専門の制作会社 EVOX Productions が、TikTok の親会社である ByteDance をカリフォルニア州中部地区連邦地方裁判所に提訴しました。ByteDance の画像生成モデル Seedream の AI 学習データ(AI training data) として、これら 7,095 枚の画像を無断でコピー・使用したという主張です。この訴訟(EVOX Productions LLC v. Bytedance Inc. et al, 事件番号 5:26-cv-06428)は今週、Music Business Worldwide や Digital Music News で報じられました。
AI 学習データ を無断使用したという主張自体は、もはや珍しいものではありません。過去 2 年間に起きた AI 関連の著作権訴訟は、すべて似たような申し立てを行っています。この訴訟が業界に波紋を広げている真の理由は、その申し立てから導き出される「算数(掛け算)」の恐ろしさにあります。
訴状で主張されていること
前提として、現在の法的なステータスを正確に把握しておく必要があります。これらは原告が訴状で主張している内容であり、まだ法廷で事実認定されたものではありません。ByteDance が法的な責任を問われたわけではありません。
主張内容: EVOX が著作権を持つ自動車写真がスクレイピングされ、ByteDance の画像生成モデル Seedream の AI 学習データ として使用された。
被害の規模: 7,095 枚の画像。数十億パラメータを誇る AI の世界では微々たる数字ですが、これは意図的です。無限のデータの塊ではなく、「1 枚ずつ数え上げ、カタログ化された特定の集合」であることを強調しています。
管轄裁判所: カリフォルニア州連邦地方裁判所。原告と被告は共にデラウェア州法人の企業ですが、この種の AI 訴訟が近年集中的に蓄積されている地区が選ばれました。
判例の現状: 米国の司法では、この種の AI 学習データ に関する最終的な法的判断はまだ下されていません。これはあくまで提訴の段階であり、今後の証拠開示手続き(ディスカバリ)、裁判所による著作物の性質の法的な定義、そして被告側の反論によって結果は大きく変わります。
なぜ「自動車写真会社」が最も危険な原告なのか
この部分こそが最も理解すべきポイントです。新聞社や巨大なストックフォト企業よりも、なぜ EVOX のような専門写真会社の方が AI 学習データ 訴訟において圧倒的に脅威となるのでしょうか。
自動車写真そのものが構造化されたカタログである。 構造化されたカタログこそ、AI 学習データ が喉から手が出るほど欲しがる素材です。決まった撮影アングル、年式、カラーバリエーション、内装、ホイールのディテール——彼らの作品は高度に体系化されており、数え上げることが可能です。EVOX のような企業は、自社が何を所有しているかを完璧に把握しており、不正利用されたファイルを 1 枚ずつ正確に指差すことができます。
1 枚 1 枚の画像が個別に識別可能である。 物理的な透かし(ウォーターマーク)、埋め込まれたメタデータ、そして一貫したライティングスタイルにより、出所(Provenance)の検証が極めて容易です。「自分たちのどの画像が使われたか証明できない」という、これまでの AI 学習データ 訴訟の最大の弱点を見事に克服しています。目視可能なマークと構造化されたライブラリが、立証の壁を破壊しました。
規格化されているため、損害賠償をスケール(掛け算)しやすい。 何千枚もの類似した画像が 1 枚ずつ個別に著作権登録されているため、「巨大でありながら簡単に項目化できる」請求リストが完成します。これは、計量不可能な過去のアーカイブ記事を巡って争う新聞社とは対極のアプローチです。
ビジネスモデルそのものが「ライセンス供与」である。 自動車ディーラーや中古車プラットフォームに対して画像を 1 枚単位で販売(ライセンス)している企業は、「市場における実害」を法廷で証明するのに極めて有利です。被告が奪ったとされるものは、原告の収益モデルそのものだからです。
これら「数え上げ可能」「識別可能」「ライセンス可能」という要素が組み合わさることで、AI 学習データ 訴訟の最強の原告は、巨大メディア企業ではなく、こうした専門的なストックフォト・ライブラリの姿をしているのです。
裁判の行方を左右する「数字の魔力」
多くのメディア報道がスルーしてしまう、米国の著作権訴訟における最も恐ろしいメカニズムがここにあります。
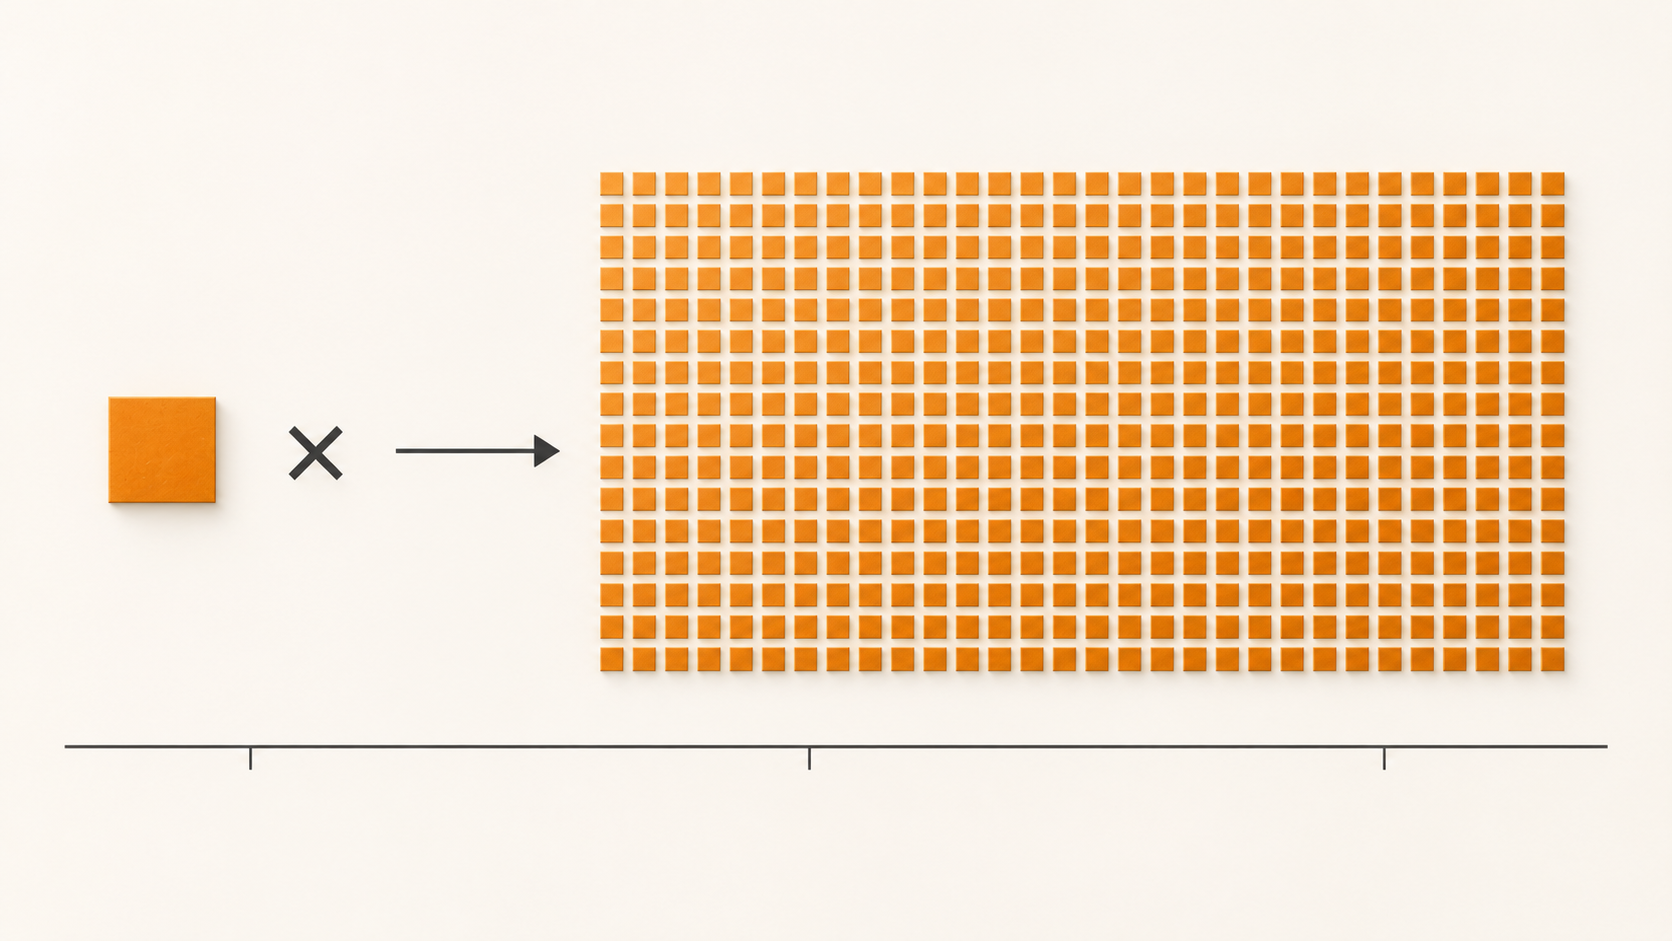
米国著作権法において、AI モデルに対する「実損害(Actual damages)」を証明することは極めて困難です。そのため、原告側の弁護士が狙うのは常に 「法定損害賠償(Statutory damages)」 です。重要なのは、法定損害賠償は一括のパッケージではなく、「侵害された著作物 1 件ごと」 に計算されるという点です。つまり、リスクの総額は「どれだけの損害を与えたか」ではなく、「著作物の数 × 法定賠償額のレンジ」で決まります。AI 学習データ 訴訟において、この「掛け算」こそがすべての法廷闘争の焦点となります。
したがって、この AI 学習データ 訴訟における最大の法的争点は「コピーが行われたかどうか」ではありません。「写真 1 枚 1 枚が、それぞれ独立した『1 つの著作物』としてカウントされるのか?」 という一点に尽きるのです。
EVOX は並行して行っている関連訴訟の書面の中で、この法理を明確に主張しています——「個々の画像が、それぞれ独自の法定賠償を受ける資格のある独立した著作物である」と。その並行訴訟では、対象となる画像の数は数十万枚規模に達すると記載されています。今回の ByteDance 訴訟にこの論理を当てはめると、規模こそ 7,095 枚と小さくなりますが、1 枚 1 枚を独立した著作物として掛け算すれば、単価が低くても企業にとって十分な抑止力(あるいは破壊力)を持つ莫大な賠償額に膨れ上がります。
被告側は当然、真逆の主張を展開するはずです。「カタログ全体で実質的に 1 つの『編集著作物』である」、あるいは「全体を単一の『集合的著作物(Collective work)』として扱い、賠償は 1 回分のみとすべきだ」と。このアルゴリズムではなく「著作物の数え方」を巡る争いこそが、損害賠償額の桁を決めるのです。
AI 学習データ を使ってビジネスを展開するすべての企業にとって、これこそが注視すべき最重要ポイントです。もし裁判所が「画像 1 枚=独立した 1 つの著作物」という判決を下せば、業界全体の AI 学習データ 収集(スクレイピング)に伴う賠償リスクが、一夜にして天文学的な数字へと跳ね上がることになります。
EVOX の訴訟は「単発の事故」ではない
注目すべきは、EVOX が並行する別の AI 学習データ 訴訟において、Midjourney を相手取っても同様の法的措置を講じているという事実です。これにより、本件の訴状の読み方が大きく変わります。
不満を持った写真家が単発で訴訟を起こすのは、単なる「個人の権利主張」です。しかし、同じ原告が複数の AI 企業に対して連続して訴訟を仕掛けるのは、明確な 「戦略(Strategy)」 です。法的な理論を確立し、判例という実績を積み上げ、複数の被告から和解金を引き出すか法廷で打ち負かすことを目的としています。AI 学習データ を巡る訴訟は現在、少数の「常連の原告」が火力の大部分を担う形で、まさにこのパターンへと収束しつつあります。
現実的な影響として、ByteDance の訴訟が孤立して裁かれることはありません。並行する Midjourney などの訴訟の書面や判決が互いに影響を与え合い、「1 作品ごと(per work)」の解釈に関するいかなる判決も、瞬く間に業界全体のスタンダードとして波及していくでしょう。
もし原告の主張が通れば、AI 画像業界はどう変わるか
もしこの「1 枚=1 著作物」の理論が法廷で認められれば、3 つの地殻変動が起きます。
AI 学習データが「価格のついた負債」に変わる。 1 作品ごとの掛け算(Multiplier)が現実の脅威となった瞬間、AI 企業が誇示してきた「データセットの圧倒的な規模」は無料の堀ではなくなり、貸借対照表上の巨大なリスクエクスポージャーに変わります。これはどんな倫理的非難よりも強烈に、AI 研究所の AI 学習データ 収集手法を根本から変えさせる力を持っています。
AI 学習データのライセンス市場が本格的に立ち上がる。 無断スクレイピングされたカタログが「天文学的な賠償リスク」を意味するなら、合法的にライセンスされたカタログは「確実な商業的価値」を持つことになります。過去 3 年間、机上の空論に近かった AI 学習データ の取引市場に、ついにリアルな価格シグナルが点灯します。
AI 学習データの出所証明(Provenance)が必須の防衛策になる。 学習に使った 1 枚 1 枚の画像の出所を明確に説明できるかどうかが、管理可能なビジネスリスクで済むか、青天井の賠償リスクで倒産するかの分かれ道になります。
この訴訟が「変えない」こと
メディアの報道は往々にして過剰な危機感を煽るため、この訴訟の限界も冷静に把握しておく必要があります。
この AI 学習データ 訴訟によって、あなたが個人的に画像生成 AI を使うことが違法になるわけではありません。これはあくまで、モデルの「訓練者(Trainer)」と「権利者」の間で起きた、AI 学習データ の調達方法を巡るビジネス上の紛争です。他人が訓練したモデルをユーザーとして利用することの合法性には一切触れておらず、あなたがキーボードを叩いてプロンプトを入力する行為(Prompting)には何の影響も及ぼしません。
また、この訴訟が「フェアユース(公正利用)」の論争に最終的な決着をつけるわけでもありません。AI 学習データ を巡る議論は何年にもわたって明確な答えが出ないまま続いており、一地方裁判所への提訴だけで最終結論が出ることはありません。
報道や訴状を冷静に読み解くための 4 つの視点
「主張」は「判決」ではない。 現時点ではいかなる法的責任も確定しておらず、「7,095」という数字も原告が独自に算出したものに過ぎません。
AI 学習データのカウント方法はあくまで原告の「手法」である。 「7,095」という数字は、EVOX が自社の画像を特定し、AI の出力と照合した手法の結果を反映しています。裁判所がそのカウント方法や証拠能力を認めるかどうかは全く別の問題です。
「1 作品ごとの賠償(per-work theory)」は法的に争われている。 これは原告側が賠償額を最大化するための法解釈であり、確定した法律ではありません。
初期段階の訴訟は形を変えやすい。 この種の紛争では、訴状が修正されたり、一部の請求が取り下げられたり、最終的に非公開の示談(和解)で終わるのが常套手段です。
これが AI クリエイターに意味すること
あなたが AI を訓練する側(Trainers)なら: データの出所(Provenance)管理は、今や純粋な技術的課題ではなく、企業の生死を分けるリスクマネジメントの最前線です。
あなたがストックフォト等のライセンサー(Licensors)なら: あなたの資産価値はたった今、跳ね上がりました。個別に識別可能で、数え上げ可能なライブラリこそが、合法的であることを証明したい AI 学習データ 市場が今最も喉から手が出るほど求めている「ゴールド」なのです。
あなたが単に画像を生成するだけのユーザー(Generators)なら: これはあなたの戦いではありません。安心してモデルを使い、プロンプトの腕を磨き続けてください。ただし「1 作品ごとの賠償」の判決の行方は注視すべきです。その莫大な賠償コストは最終的に、あなたが支払う AI ツールのサブスクリプション料金の値上げとして跳ね返ってくるからです。
試してみるべきプロンプト
この訴訟の本質的な精神を画像で表現したいなら、「物理的なアーカイブ(保管庫)」こそが最も誠実なモチーフです。ストックフォト・ビジネスの本質とは、まさにこうした物理的な図書館のデジタル版に他ならないからです。
以下をコピーして Fanch AI に貼り付け(モデル選択:gpt_image_2):
A wide documentary photograph down the aisle of a vast photographic archive: long rows of steel filing drawers receding into dim depth on both sides, cardboard slide boxes stacked on open metal shelves, a single shaft of daylight falling from a high window and catching dust in the air. Fine detail in the brushed steel drawer fronts, worn paper labels and the fibre of the cardboard boxes, cool grey and warm sepia palette, deep perspective, slight vignetting at the frame edges, 16:9 framing, 8K detail, no people, no legible text.
この業界において、「アーカイブ」とは、その中に何が入っているかを「1 枚残らず正確に把握している」ことによってのみ価値が生まれる唯一の画像群なのです。
なぜ Fanch AI がクリエイターの盾になるのか
AI 学習データ を巡る法的な争いの本質は、「画像ライブラリがどう『学習・収集』されるか」のルールの綱引きであり、「人間が画像を『生成・表現』すべきかどうか」の議論ではありません。この違いは極めて重要です。法的リスクの矢面に立たされるのは、クローラーでデータをかき集める「モデル訓練者」であり、キーボードを叩いてプロンプトを入力する「個人のクリエイター」ではありません。
Fanch AI はプロンプトの指示を精密に反映する専用画像モデルを提供しています。誰かのカタログ写真からの盗用リスクに怯えることなく、あなた自身の「言葉による説明」から、100% オリジナルで必要なビジュアル素材を直接生み出すことができます。あなたの作品、あなたのクリエイティビティ、そしてあなたの権利を、明確に自分自身のものとして保持し続けてください。