
Higgsfield が AI 動画を 1 分から 10 分超へ拡張:長尺化の真実と課題 | Fanch AI
短いクリップの制限は、これまで AI 動画(AI video) を定義づける最大の制約でした。大半の生成ツールは数秒で上限に達し、野心的なツールでもせいぜい 1 分程度で停止します。Higgsfield はこの天井を突破し、連続出力を約 1 分から 10 分以上 へと拡大したと発表しました。もしこれが実用レベルで維持されるなら、過去 1 年間で AI 動画 における最大の変革となります。
この変化は今週公開された OpenAI の顧客導入事例で明らかになったもので、長尺 AI 動画 が向かう未来を知る上で貴重な材料となります。ただし、ベンダーによる AI 動画 の発表は独立した検証に先んじる傾向があるため、慎重に見極めるべき主張でもあります。
Higgsfield は実際に何を変えたのか
OpenAI の発表によると、Higgsfield は自社の YouTube チャンネル向けに 10 分を超えるチュートリアル動画 を生成する GPT-6 Astra ベースのワークフローを構築しました。Higgsfield の CEO 兼共同創業者である Alex Mashrabov 氏は、従来のプロセスでは 1 回の生成につき約 1 分 が限界だったと述べています。
実務上の決定的な転換点は、出力が長尺化することで中尺コンテンツにおける手動での動画結合が不要になることです。編集ソフトで十数本の短いクリップを組み立てる代わりに、チームは単一のシームレスな AI 動画 を制作できるようになります。
Mashrabov 氏は、制作チームがバラバラの断片を寄せ集めるのではなく、1 人のクリエイターがハイエンドな映像制作を最初から最後まで完結できる機能であると位置づけています。これこそが長尺 AI 動画 が約束する未来であり、手戻りと継ぎ目の削減を意味します。
その背景にあるモデルスタック
Higgsfield のワークフローは、単なる動画生成と高度なオーケストレーション(統合制御)を組み合わせています。OpenAI によれば 2 つのシステムが連携しており、現代の AI 動画 パイプラインがどのように構築されているかを示しています:
- GPT-6 Astra — AI 動画 生成を司るとともに、複数のカットバリエーション生成など反復的な制作タスクを自動化するクリエイティブエージェントを実行。
- ツール呼び出し(Tool calling) — GPT-6 Astra はこれらのエージェントが 3D モデリング を含む複雑な手作業タスクのために外部ツールを呼び出すことを可能にします。
3D モデリングのディテールは特に興味深いポイントです。Mashrabov 氏はツールの活用を一貫性(コンシステンシー)に直接結びつけています。同一の基礎的なシーンジオメトリを繰り返し参照できることで、モデルはショットごとに世界を一から再構築することなく、安定したアンカー(基準点)を保持できます。これこそが長尺 AI 動画 に不可欠な基盤です。
さらに、もう 1 つのモデルである GPT-Image-2.5 が精密な視覚制御層を担当し、長尺の AI 動画 全体を通じてキャラクターやスタイルがブレるのを防いでいると報告されています。単一のジェネレーターではなく、複合的なスタックを形成している点こそが、単発クリップ生成ツールとこのワークフローの決定的な違いです。
なぜ「一貫性」こそが真の障壁だったのか
動画の長さそれ自体は、決して最も難しい問題ではありませんでした。真の難関は「時間的連続性(Continuity)」です。10 秒の AI 動画 ならほぼあらゆる不整合を隠せますが、10 分の動画では誤魔化しが利きません。
顔の特徴が歪み、服装が変わり、部屋の配置が勝手に変わり、カット間でライティングが破綻します。視聴者はミーム動画なら許容しても、チュートリアル動画でそれが起きれば即座に離脱します。単発クリップの画質が劇的に向上した今でも、長尺 AI 動画 が短尺に後れを取ってきた理由はここにあります。本格的な AI 動画 の開発計画はすべて同じ壁に突き当たってきました。
Higgsfield のアプローチ(エージェント+外部ツール+制御レイヤー)は、本質的に多数の生成プロセスを跨いでも仮想世界を安定させ続ける試みです。もしこれが完全に機能すれば、解放されるのは単なる「尺の長さ」ではなく、制作フォーマットそのものです。
この主張を冷静に読み解くべき理由
大半のメディアが見落としている重要な事実があります。Higgsfield の数値は OpenAI および Higgsfield 自身が発表したもの です。アナリストの Data Phoenix が指摘しているように、この事例には画質、制作時間、コスト、あるいは必要な人間による介入の度合いに関する第三者による独立したベンチマークは一切含まれていません。
また、完成した 10 分の AI 動画 が単一のモデルによる一発生成なのか、それともツールによって繋ぎ合わされた多数の短い断片のオーケストレーションなのかも公式には明確にされていません。これらは全く異なる技術的アプローチであり、AI 動画 を基盤としたワークフローを検討しているすべての人にとって極めて重要です。
独立した検証結果が示されるまでは、この 10 分という数値をベンダー発表の参考性能として捉えるのが賢明です。それは否定するためではなく、ワークフローを全面的に再構築する前に事実確認を行うためです。AI 動画 の主張を慎重に見極めるコストはゼロですが、誤った前提でパイプラインを再設計するコストは甚大です。そして、もしこの数値が本物であれば、中尺コンテンツの全領域が一変することになります。
クリエイターにとっての意味
AI 動画 を扱うすべての人にとって、3 つの実用的な示唆があります:
- 時間的一貫性こそが最前線である — 次の差別化要因は単発クリップの長さではなく、カット間の安定性にある。
- オーケストレーションが単発生成に勝る — エージェント、外部ツール、参照レイヤーの組み合わせこそが、長尺 AI 動画 を実現する道である。
- ベンダーの数値は検証が必要である — 信用する前に、必ず自身の素材とユースケースで検証すること。
- 中尺フォーマットが現実的になる — 解説動画、チュートリアル、研修コンテンツが最も大きな影響を受ける。
近い将来における現実的な影響先は、映画製作ではなく解説・教育用 AI 動画 です。これは依然として巨大で未開拓の市場であり、AI 動画 が芸術的評価を得る前に、まず経済的合理性で勝利できる領域です。
今すぐ試せるプロンプト
映像の一貫性は、明確で再現性の高い視覚的描写から始まります。これはあらゆる長尺 AI 動画 が依存している基本原則です。Fanch AI でこれを試してみてください:
以下をコピーして Fanch AI に貼り付け(モデル選択:gpt_image_2):
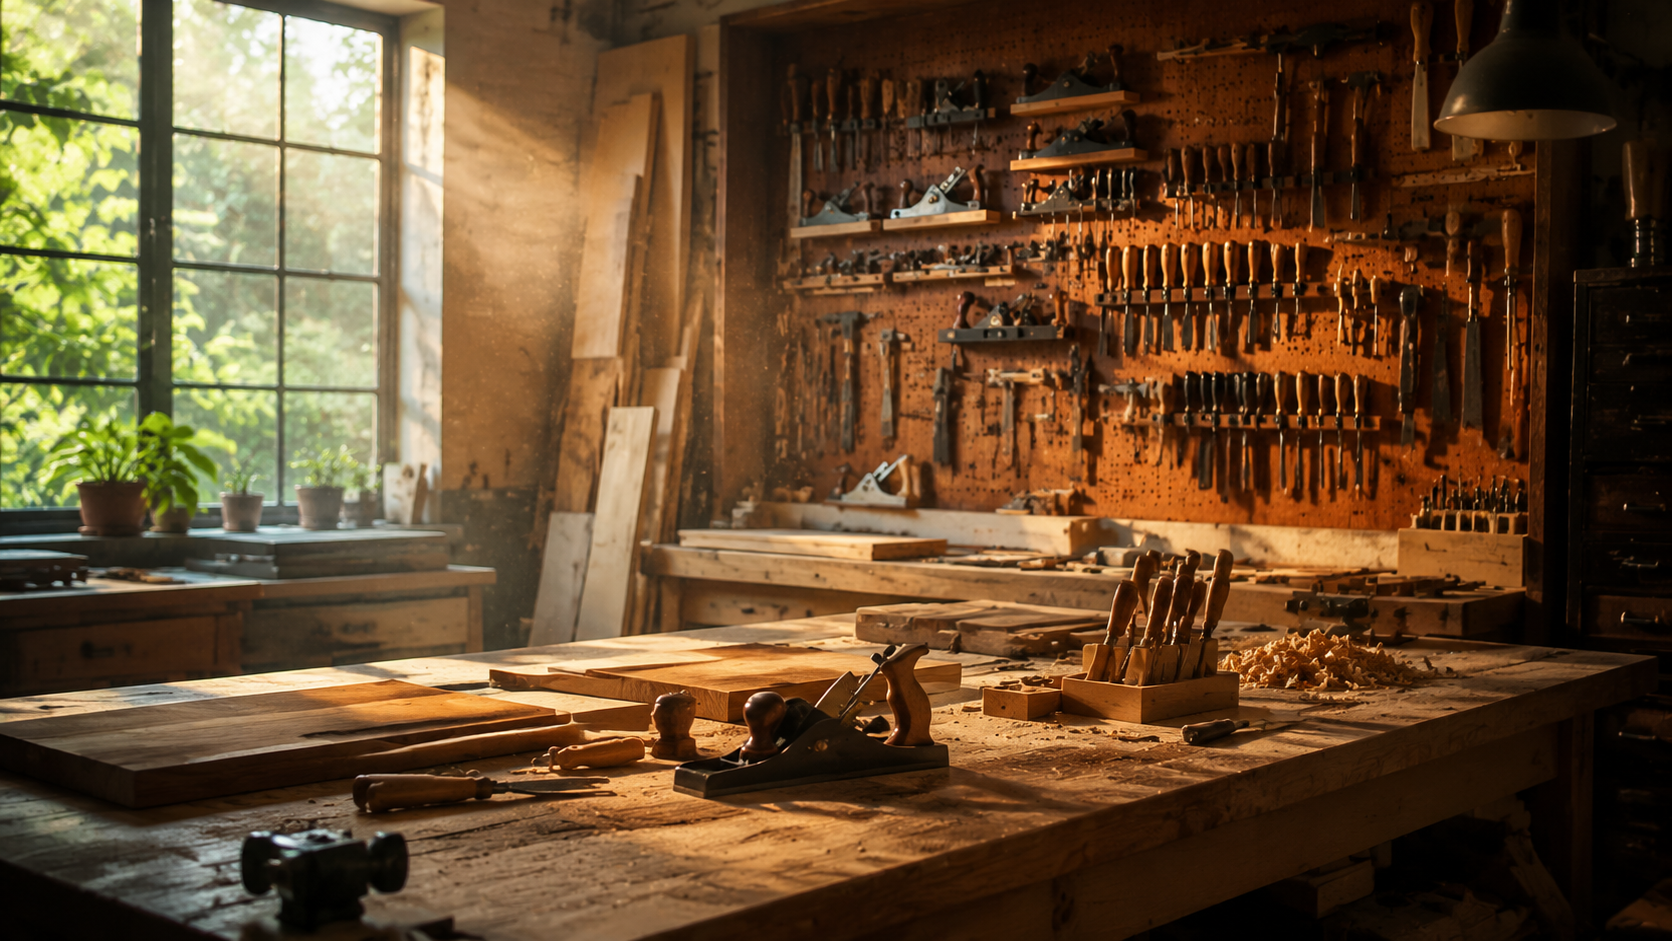
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
なぜ Fanch AI がこのワークフローに適しているのか
長尺 AI 動画 を制作する場合でも、単一のキービジュアルを作る場合でも、まず最初に必要なのは視覚的リファレンスです。Fanch AI は精密なプロンプトで指示できる専用の画像モデルを提供し、1 秒の AI 動画 を生成する前に、外見、衣装、ライティングの設計を完全に固定することができます。優れた連続性は優れた静止画から始まります。自らコントロールできるリファレンスフレームこそが、AI 動画 プロジェクトにおける最も手堅い投資となります。
👉 ここからスタート:Fanch AI の GPT Image 2 — あなたの AI 動画に必要なキーフレームを今すぐ作成しましょう。