
香港大学の最新 AI 動画ベンチマーク:画質と安全性で二極化する評価 | Fanch AI
香港大学から発表された最新の AI 動画ベンチマーク(AI video benchmark) は、業界関係者にとって複雑な現実を突きつける結果となりました。香港大学ビジネススクールが公開したこの評価レポートによると、中国製動画モデルが視覚的な生成品質で優位に立ち、Seedance 2.0 Pro が Veo 3.1 や Sora 2 Pro を抑えて生成能力トップを獲得した一方で、同モデル群はセーフガード(安全性・防御対策)の面で遅れをとっていることが明らかになりました。
この組み合わせこそ、今回の AI 動画ベンチマーク が単なるニュースの見出し以上の価値を持つ理由です。画質と安全性を同一のフレームワークで測定した大規模な評価であり、レポートの両輪は全く正反対の方向を指し示しています。
香港大学レポートが示した 3 つの核心
この AI 動画ベンチマーク を特徴づける 3 つの重要な知見:
生成品質の逆転。 今回の AI 動画ベンチマーク において、トップの中国製モデルが視覚的生成スコアで米国の主要モデルを上回りました。これは、Veo や Sora が絶対的な頂点と見なされていた 2026 年初頭までの共通認識を覆すものであり、これまでの前提が通用しなくなっていることを示しています。
セーフガードは連動して向上しなかった。 同じ AI 動画ベンチマーク において、中国製モデルは防御機能や安全基準の遵守において弱さを見せました。現地メディアの報道によると、レポート自体が「品質を最優先し、防御面を意図的に軽量化している」と指摘しています。
この差は偶然ではなく製品戦略のトレードオフである。 総合的に見ると、この結果は「出力の質に全力を注ぎ、リフューザル(拒否応答)にはリソースを割かない」という設計思想を反映しています。これは明確なプロダクト判断であり、双方を同時に測定する AI 動画ベンチマーク だからこそ可視化できた事実です。
なぜビジネススクールがこのベンチマークを実施したのか
評価の出所は、データの信頼性を判断する上で重要です。これはコンピュータサイエンスの研究室が合成データセット上で PSNR を計測したような学術論文ではありません。香港大学のビジネススクールが主導したからこそ、問いと答えの双方が実務的です。すなわち、現場の実効性能、製品レベルの挙動、そして企業が直面する防衛体制のあり方が問われています。
そのため、この AI 動画ベンチマーク は研究者よりも導入を検討する企業担当者にとって極めて有用です。「損失関数でどのアーキテクチャが勝つか」ではなく、「どのモデルが実際に機能し、何を拒否するのか」に答えてくれます。
ただし、そこには限界もあります。独自の評価基準を持つ単一機関による検証は、有力なデータポイントではあっても確定的な絶対ランキングではありません。現時点で査読付き論文が存在するわけではなく、プロンプトの選定、配点比率、評価対象のモデルバージョンはすべて著者たちの裁量に基づいています。
動画モデルにおける「セーフガード」の真意
テキストモデルにおける安全性は、「モデルが要求を拒絶するかどうか」という比較的単純な問いです。しかし動画ははるかに複雑であり、そこにこそ AI 動画ベンチマーク の存在意義があります。
動画モデルにおける防御的側面は多岐にわたります。明白に禁止されたプロンプトを拒否できるか。一見無害な表現に偽装された要求に対して一線を維持できるか。不適切なプロンプトに対して破綻した映像を出力するのではなく、適切に処理を中断できるか。肖像権侵害、暴力、成人向けコンテンツといった既知のリスク領域に対して、確率的なすり抜けを起こさず一貫して対処できるか。
視覚的な描写力で満点を叩き出しながら、こうした安全行動で低スコアを記録するモデルは、きわめて尖った製品特性を持ちます。規約を厳守するプロにとっては強力な武器ですが、一般ユーザーに広く開放するプラットフォームにとっては重大なリスクとなります。双方を可視化する AI 動画ベンチマーク があって初めて、当て推量ではない導入判断が可能になります。
AI 動画ベンチマークを冷静に読み解くための留意点
この調査結果を受け止めるにあたり、ベンダーの公式発表と同様に留意すべき 4 つの視点があります。
1 つの調査は 1 つの調査に過ぎない。 単一機関による AI 動画ベンチマーク は有力な状況証拠ですが、絶対的な証明ではありません。この評価手法自体が他機関で再現検証されたわけではありません。
ランキングの賞味期限は短い。 いかなる AI 動画ベンチマーク も 1 四半期と原形をとどめません。Veo 3.1、Sora 2 Pro、Seedance 2.0 Pro はいずれも最新リリースですが、後継モデルの開発はすでに進行中です。ベンチマークは常に、動いている標的の一瞬の影に過ぎません。
「視覚品質」という言葉の主観性。 評価基準が何を優遇するか(動きの連続性、質感、ライティング、プロンプト追従性、人間の嗜好性)によって順位は激変します。どちらも妥当に見える 2 つの異なるベンチマーク設計が、全く正反対の順位を導き出すことは珍しくありません。
国籍は本質的な変数ではない。 この AI 動画ベンチマーク の真に有益な読み方は「中国対米国」という枠組みではなく、「出力最大化に振ったモデル」対「拒否防御を重視したモデル」の比較です。国籍はニュースの切り口に過ぎず、設計思想のトレードオフこそが学ぶべき本質です。
クリエイターにとっての実践的な示唆
この AI 動画ベンチマーク を真摯に受け止める場合、以下の実務的アプローチが有効です。
「米国製モデルが画質の天井である」という思い込みを捨てる。 少なくとも純粋な視覚的出力において、その差は消失しました。品質上の懸念から Seedance を選択肢から外していた場合は、再検証の価値があります。
導入前に「何が拒否されるか」を確認する。 セーフガード評価が低いモデルを採用する場合、境界線上のプロンプトに対する挙動が良くも悪くも緩やかになることを運用面で見越しておく必要があります。
ブランド名ではなく、カットの要件で選ぶ。 AI 動画ベンチマーク で総合首位となったモデルであっても、あなたの個別の絵コンテで勝てるとは限りません。ブランド信仰を捨て、案件ごとの道具選びに徹することこそがベンチマークの最大の活用法です。
自身でできるミニベンチマークの設計手順
他者の AI 動画ベンチマーク を受けて取るべき最も価値ある行動は、自分専用の小さな評価系を作ることです。所要時間は 20 分程度です。
1. 5 つのプロンプトを固定する。 実際の制作現場で扱う要素(人物の歩行、カメラワーク、質感の接写、文字を含む看板、抽象的概念)を網羅します。
2. 生成設定を統一する。 アスペクト比、尺、可能な場合はシード値を同一にします。これを怠ると、モデルではなく設定の差異を比較することになります。
3. 評価軸は 3 つに絞る。 プロンプト追従性、動きの破綻の少なさ、アーティファクト(ノイズ)の発生度。評価軸を増やしすぎると判断基準がブレます。
4. 等倍速で再生して確認する。 シークバーを素早く往復させると動きの破綻を見落とします。AI 動画の本質的な欠陥は常にモーションに現れます。
5. 四半期ごとに再テストする。 あらゆる公開ベンチマークと同様に、自身のテスト環境も定期的なアップデートが必要です。
試してみるべきプロンプト
動きの破綻をテストする場合、明確な被写体の動き 1 つと明確なカメラワーク 1 つを組み合わせたショットを使用します。要素を盛り込みすぎると、どの部分が失敗の原因か特定できなくなります。
以下をコピーして Fanch AI に貼り付け(モデル選択:gpt_image_2):
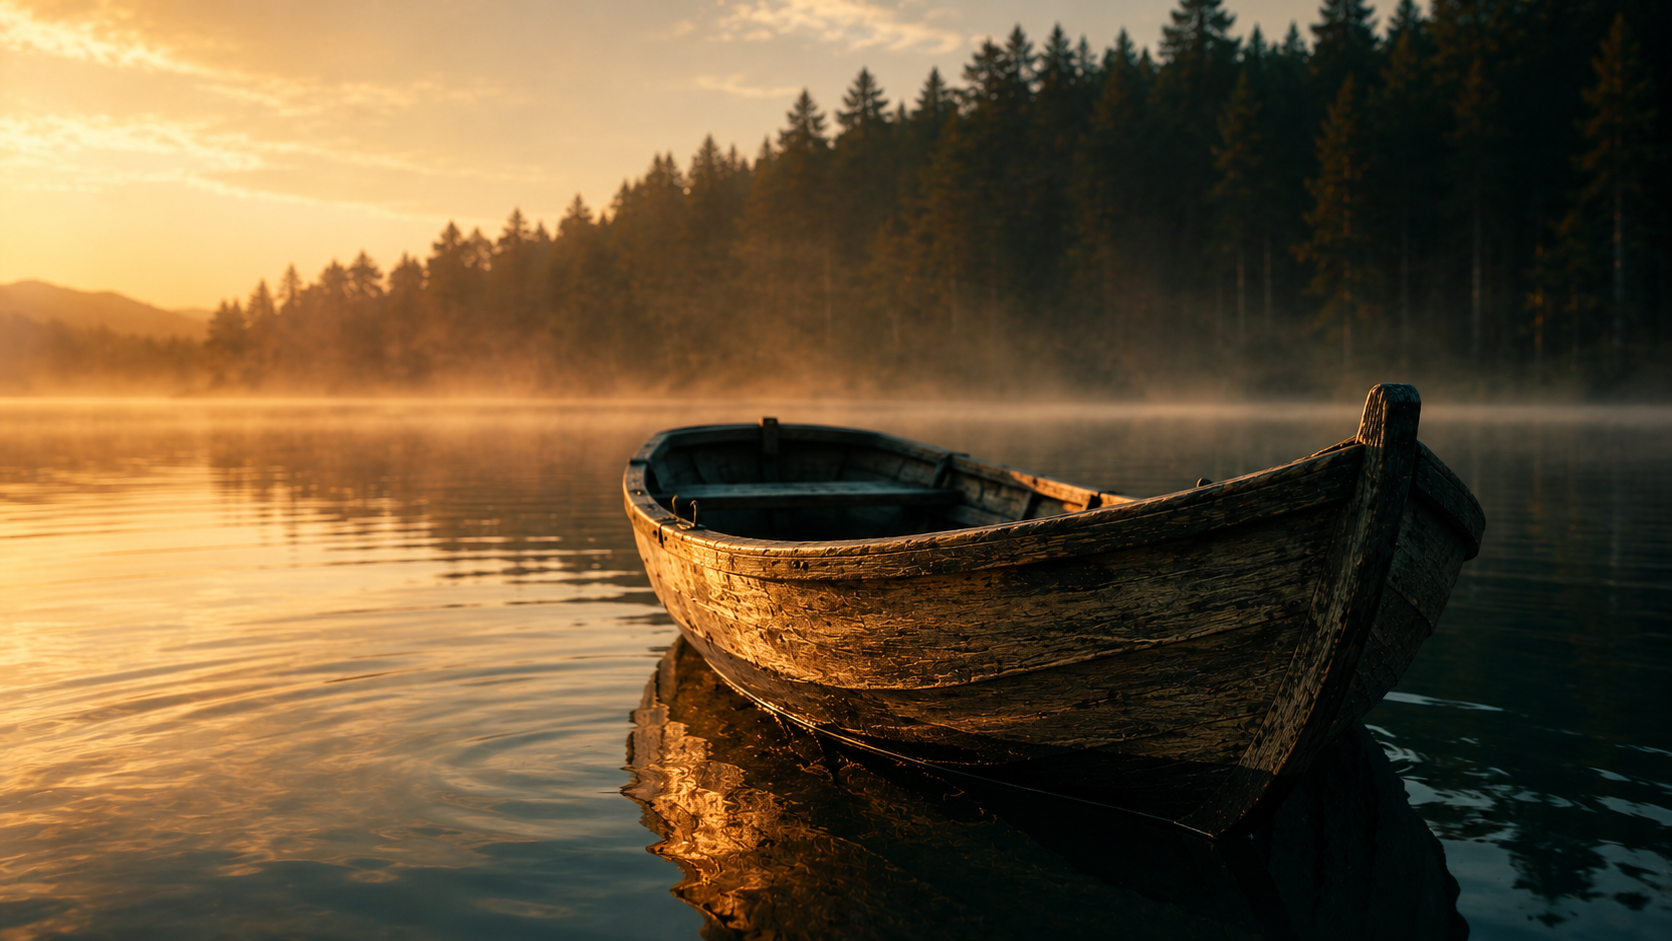
A cinematic still of a lone wooden rowboat drifting on a calm lake at golden hour, seen from a low angle just above the waterline: warm rim light along the hull, gentle ripples spreading outward, distant mist-covered pine treeline, soft haze in the air. Fine detail in the wet wood grain and water surface, shallow depth of field, warm amber and cool teal palette, 16:9 framing, 8K detail, no text overlay.
まずこの基準フレームを固定し、それを動画モデルに投入してモーションの保持力を観察してください。
なぜ Fanch AI がこの検証に適しているのか
優れた AI 動画ベンチマーク が示す教訓は、モデル間の画質差が縮まった結果、プロンプトの設計精度こそが勝敗を分けるようになったということです。Fanch AI はプロンプトに忠実な専用画像モデルを提供しており、高価な動画生成クレジットを消費する前に、低コストな静止画で構図やライティングを完全に固定できます。完全にコントロールされた基準フレームの上でこそ、各動画モデルの真の性能を正しく比較できます。