
7,095장의 사진: 바이트댄스 이미지 생성 AI 소송의 향방을 결정지을 숫자의 힘 | Fanch AI
7,095(칠천구십오). 막연하게 "수백만 장의 이미지"나 "인터넷에 널린 방대한 데이터"라고 뭉뚱그린 표현이 아닙니다. 정확히 7,095장의 사진. 마치 재고 조사 명세서처럼 구체적인 이 숫자는, 실제로 이 숫자가 손해배상 청구의 기준 목록이기 때문에 그토록 정밀한 것입니다.
자동차 전문 사진 에이전시 EVOX Productions가 TikTok의 모기업인 바이트댄스(ByteDance)를 캘리포니아 중부 지방법원에 제소했습니다. 바이트댄스가 자사의 이미지 생성 모델 Seedream을 위한 **AI 학습 데이터(AI training data)**로 EVOX의 사진 7,095장을 무단으로 복제하여 사용했다는 혐의입니다. 이 사건(EVOX Productions LLC v. Bytedance Inc. et al, 사건 번호 5:26-cv-06428)은 이번 주 Music Business Worldwide와 Digital Music News 등의 매체를 통해 세상에 알려졌습니다.
AI 학습 데이터를 무단 도용했다는 혐의 자체는 더 이상 새로운 뉴스가 아닙니다. 지난 2년간 생성형 AI 모델을 상대로 제기된 거의 모든 저작권 소송이 비슷한 레퍼토리를 반복해 왔습니다. 이 소송이 업계에 지각변동을 일으킬 수 있는 중대한 사안인 이유는, 이 고발에 뒤따라오는 무시무시한 '곱셈 산수' 때문입니다.
소장(Complaint)이 제기하는 핵심 혐의
먼저 현재의 법적 상황을 정확히 인지할 필요가 있습니다. 이는 어디까지나 원고가 법원에 제출한 소장의 일방적 주장이며, 아직 재판부의 판단이 내려지지 않았습니다. 바이트댄스는 현재 어떠한 법적 책임도 확정받지 않은 상태입니다.
핵심 혐의: EVOX가 저작권을 보유한 자동차 사진들이 무단 크롤링(Scraping)되어, 바이트댄스의 이미지 생성 모델 Seedream의 AI 학습 데이터로 쓰였다.
피해 규모의 특정: 7,095장의 이미지. 수십억 개의 파라미터가 오가는 인터넷 대형 모델의 스케일로 보면 아주 미미한 숫자입니다. 하지만 이는 원고 측의 매우 의도적인 법적 전략입니다. 형태를 알 수 없는 거대한 데이터 덩어리가 아니라, 1장씩 개별적으로 식별하고 카탈로그화할 수 있는 확고한 증거 세트임을 강조하는 것입니다.
관할 법원: 캘리포니아 연방 법원. 원고와 피고 모두 델라웨어(Delaware)에 등록된 기업이지만, 최근 이와 유사한 성격의 AI 저작권 소송들이 집중적으로 누적되어 선례가 쌓이고 있는 캘리포니아 관할 구역을 선택했습니다.
관련 판례 현황: 현재 미국 사법부에는 이런 구체적인 형태의 AI 학습 데이터 무단 사용과 관련해 확립된 최종 판결이 아직 없습니다. 이제 막 링 위에 오른 상태이며, 최종 결과는 증거 개시 절차(Discovery), 재판부가 해당 저작물의 성격을 어떻게 규정할지, 그리고 바이트댄스가 앞으로 내놓을 방어 논리에 따라 크게 달라질 것입니다.
왜 '자동차 사진 에이전시'가 가장 위험하고 껄끄러운 원고인가
이 대목이 이번 사건에서 가장 주의 깊게 살펴봐야 할 핵심입니다. 왜 대형 언론사나 일반적인 스톡 이미지 업체보다 EVOX 같은 전문 사진 에이전시가 AI 연구소들에게 훨씬 치명적인 위협이 되는지를 설명해 주기 때문입니다.
자동차 사진 자체가 이미 고도로 구조화된 카탈로그(Database)입니다. 체계적으로 정리된 카탈로그야말로 질 좋은 AI 학습 데이터를 구축하기 위해 AI 기업들이 가장 탐내는 최상급 먹잇감입니다. 정형화된 카메라 앵글, 정확한 연식, 컬러 베리에이션, 내부 인테리어, 휠 디테일 등 이들의 사진 작업은 극도로 체계적이며 빠짐없이 '열거 가능(Enumerable)'합니다. EVOX 같은 기업은 자신들이 소유한 자산이 무엇인지 픽셀 단위로 정확히 꿰뚫고 있으며, 도용된 파일 하나하나를 정확히 짚어낼 수 있습니다.
각 이미지가 개별적으로 완벽하게 식별 가능합니다. 물리적인 워터마크, 파일에 심어진 숨겨진 메타데이터(EXIF), 그리고 절대적으로 일관된 스튜디오 조명 스타일 덕분에 이미지의 출처(Provenance) 검증이 너무나 쉽습니다. '출처 입증'은 그동안 제기된 대다수 AI 학습 데이터 소송에서 원고 측이 가장 고전했던 약점이었습니다. 대부분의 원고는 구체적으로 어떤 작품이 모델에 먹혔는지 명확히 증명하지 못했습니다. 시각적 마커가 선명하고 구조화된 카탈로그 라이브러리는 이 입증의 장벽을 단숨에 부숴버립니다.
표준화된 규격 덕분에 손해배상 청구의 스케일업(확장)이 쉽습니다. 수천 장의 사진이 기술적으로 유사하면서도 각각 개별적인 저작권으로 등록되어 있어, 청구 목록이 방대하면서도 항목화하기가 매우 쉽습니다. 수량조차 파악하기 힘든 오래된 과거 기사 아카이브를 놓고 피해 규모를 입증해야 하는 뉴스 매체들의 고군분투와는 정반대의 상황입니다.
에이전시의 핵심 비즈니스 모델 자체가 '라이선스 판매'입니다. 자동차 딜러나 중고차 플랫폼에 사진 사용권(License)을 건당 판매하여 수익을 올리는 기업은, 법정에서 '시장 피해(Market harm)'를 입증하기가 가장 수월합니다. 피고가 훔쳐갔다고 주장하는 바로 그 데이터가, 원고가 밥을 먹고사는 비즈니스 모델의 전부이기 때문입니다.
이처럼 "열거 가능하고, 식별 가능하며, 라이선스 판매가 가능한" 특성들이 결합되면서, AI 학습 데이터 소송에서 가장 두려운 적수는 전통적인 미디어 재벌이 아니라 이처럼 치밀하게 구조화된 상업용 사진 라이브러리라는 사실이 명백해지고 있습니다.
소송의 향방을 가를 '숫자'의 마법과 함정
이 부분이 일반 매체들이 다루지 않고 넘어가는 미국 저작권 소송의 가장 핵심적인 법적 메커니즘입니다.
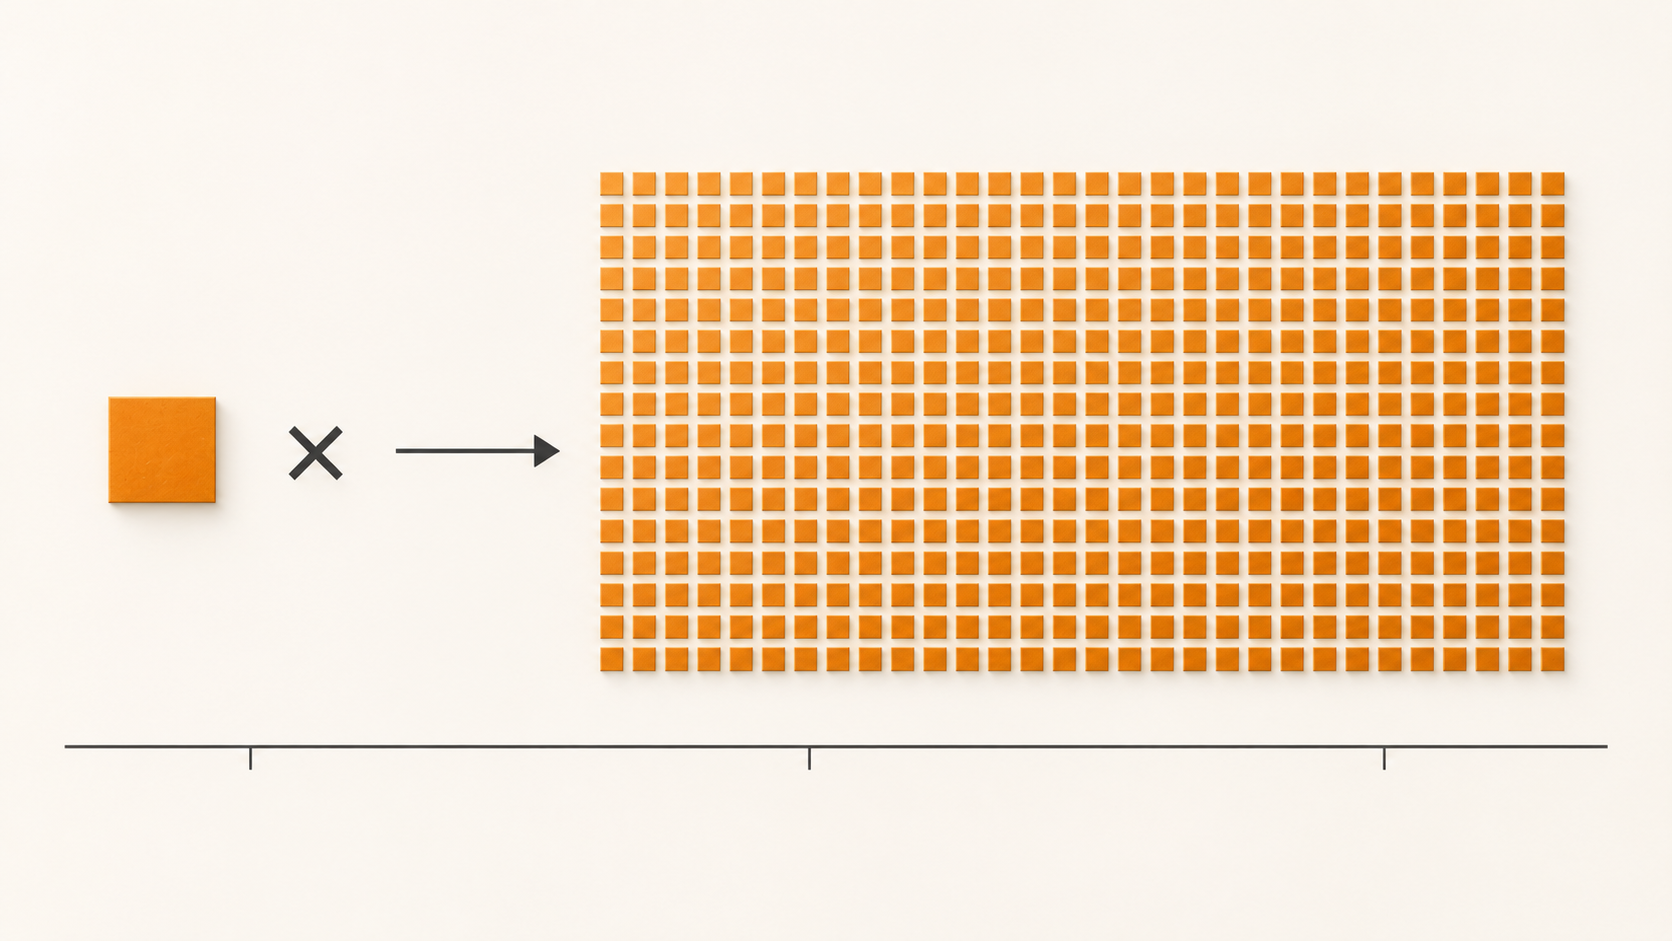
미국 저작권법 체계에서 AI 모델을 상대로 구체적인 '실제 경제적 손해(Actual damages)' 액수를 증명해 내는 것은 극도로 어렵습니다. 그래서 원고 측 변호사들이 무기로 꺼내 드는 것이 바로 **'법정 손해배상(Statutory damages)'**입니다. 법정 손해배상의 가장 무서운 점은 사건 전체를 뭉뚱그려 총액으로 배상하는 것이 아니라, '침해된 개별 저작물 1건당' 벌금을 부과한다는 데 있습니다. 즉, 피고 측의 재무적 리스크는 "얼마나 큰 피해를 주었나?"가 아니라 "침해한 저작물 수 × 법정 배상금 범위"라는 산술적 곱셈에 의해 결정됩니다. AI 학습 데이터 소송에서 이 '승수(Multiplier)'야말로 소송의 모든 것을 좌우합니다.
따라서 이 AI 학습 데이터 소송에서 판결을 가를 진짜 법적 쟁점은 "데이터 크롤링이 실제로 발생했는가?"가 아닙니다. 진짜 쟁점은 **"그 사진 7,095장을 법적으로 각각 독립된 7,095개의 저작물로 인정할 것인가?"**입니다.
EVOX는 관련된 다른 평행 소송에 제출한 서류들을 통해 자신들의 법리적 전략을 분명히 드러냈습니다. 각각의 개별 이미지는 모두 고유한 법정 손해배상을 받을 자격이 있는 '별개의 저작물'이라는 주장입니다. 평행하게 진행 중인 다른 사건에서는 이 숫자가 수십만 장에 달합니다. 비록 7,095장으로 규모는 작지만, 이번 사건에도 AI 학습 데이터에 관한 동일한 논리가 적용됩니다. 7,095장의 이미지가 각각 독립된 저작물로 인정받아 곱셈이 성립한다면, 1장당 배상액이 아무리 적더라도 그 총액은 기업의 존립을 위협할 만큼 천문학적인 징벌적 액수로 부풀어 오릅니다.
물론 바이트댄스 측 변호인단은 이를 필사적으로 방어할 것입니다. 카탈로그 전체는 실질적으로 하나의 '편집 저작물(Compilation)'에 불과하며, 따라서 7,095장이 아니라 단 1개의 '집합적 저작물(Collective work)'로 간주해 배상금도 딱 한 번만 물어야 한다고 맞설 것입니다. 크롤링 자체의 불법성 여부보다, 이 '저작물 숫자를 세는 산수 방식'을 둘러싼 법리 다툼이 결국 손해배상액의 자릿수를 결정짓게 됩니다.
AI 학습 데이터를 수집해 비즈니스를 영위하는 모든 테크 기업들이 숨죽여 지켜봐야 할 지표가 바로 이 판결입니다. 만약 법원이 대규모 데이터셋 안의 이미지 1장 1장을 모두 독립된 저작물로 인정하여 개별 배상 판결을 내린다면, AI 업계 전체가 지금까지 해왔던 AI 학습 데이터 크롤링 관행의 재무적 리스크가 하룻밤 사이에 파멸적인 수준으로 재평가될 것입니다.
EVOX는 어쩌다 걸린 단발성 원고가 아니다
주목해야 할 핵심 디테일: EVOX는 이번 사건과 병행하여 진행 중인 또 다른 AI 학습 데이터 소송에서 Midjourney를 상대로도 동일한 법적 절차를 밟고 있습니다. 이 사실은 우리가 이번 소장을 읽어내는 관점을 완전히 바꿔놓습니다.
억울한 사진작가가 어쩌다 한 번 소송을 제기하는 것은 개인의 불만 토로입니다. 하지만 동일한 원고가 복수의 이미지 생성 AI 거인들을 상대로 똑같은 패턴의 소송을 연이어 제기한다는 것은 다분히 의도적인 **'기업 전략(Strategy)'**입니다. 확실한 법리적 근거를 구축하고, 판례를 쌓고, 이를 무기로 거액의 합의금(Settlement)을 끌어내거나 업계 전체를 상대로 법정 투쟁을 벌이겠다는 계산입니다. 현재 AI 학습 데이터를 둘러싼 소송전은 정확히 이 패턴으로 굳어지고 있으며, 소수의 '상습적 원고'들이 법적 공격의 최전선에서 화력을 집중하고 있습니다.
이러한 전략이 가져올 실질적인 결과는, 바이트댄스 사건이 결코 진공 상태에서 홀로 판결되지 않을 것이라는 점입니다. Midjourney 등 병행 사건들의 서면과 판결이 서로 긴밀하게 영향을 주고받을 것이며, "1개 작품당(per work)" 배상 원칙을 지지하는 판결이 단 하나라도 나오면 그 판례는 순식간에 다른 모든 관할 법원으로 들불처럼 번져나갈 것입니다.
이 소송이 이미지 생성 AI 산업에 가져올 3가지 지각변동
만약 원고의 이 "1장당 개별 배상" 논리가 어느 법정에서든 받아들여진다면, 업계에는 다음과 같은 거대한 세 가지 변화가 닥칩니다:
AI 학습 데이터는 언제 터질지 모르는 시한폭탄(부채)이 됩니다. "작품 1개당" 법정 배상이라는 곱셈 공식이 법적 효력을 얻는 순간, AI 기업들이 그토록 자랑해 마지않던 '초거대 데이터셋 규모'는 더 이상 공짜 해자(Moat)가 아닙니다. 그것은 재무제표에 언제 얼마의 비용으로 청구될지 모르는 막대한 리스크 익스포저(위험 노출액)로 둔갑합니다. 이는 그 어떤 숭고한 윤리적 비판보다도 훨씬 빠르고 강력하게 AI 연구소들의 AI 학습 데이터 수집 방식을 뿌리부터 뜯어고치게 만들 것입니다.
AI 학습 데이터 라이선스 시장이 폭발적으로 성장합니다. 무단 크롤링한 카탈로그가 파산에 이르는 재무적 위험을 뜻한다면, 합법적인 라이선스를 획득한 카탈로그는 그야말로 엄청난 가치를 지니게 됩니다. 지난 3년간 그저 말로만 떠돌던 AI 학습 데이터 거래 시장에 드디어 명확하고 거대한 '가격표(Price signal)'가 매겨지는 것입니다.
AI 학습 데이터의 출처 추적(Provenance)은 사치품이 아니라 필수 방어막이 됩니다. 학습에 사용된 이미지 1장 1장이 어디서 합법적으로 왔는지 증명할 수 있는 능력은, 이제 통제 가능한 운영 비용을 내고 사업을 할 것인가, 아니면 한도 끝도 없는 천문학적 배상금 리스크를 떠안을 것인가를 가르는 생명선이 될 것입니다.
하지만 이 소송이 '바꾸지 못하는 것'도 있습니다
언론 보도가 과열되며 위기감을 조장하기 쉬우므로, 이 소송이 미치는 영향력의 한계도 분명히 짚고 넘어가야 합니다.
이 AI 학습 데이터 소송은 일반 사용자가 이미지 생성 AI를 사용하는 것 자체를 불법이나 위험한 행동으로 만들지 않습니다. 이 사건은 어디까지나 모델을 학습시키는 '개발사(Trainer)'와 데이터 원작자 간의 AI 학습 데이터 무단 수집에 관한 기업 간 비즈니스 분쟁일 뿐입니다. 이미 누군가 학습시켜 놓은 모델을 일반 사용자가 활용하는 것의 합법성에는 어떠한 영향도 미치지 않으며, 여러분이 프롬프트를 입력(Prompting)하는 창작 활동을 법적으로 제약하지도 않습니다.
또한, 이 소송이 논란이 많은 '공정 이용(Fair use)'에 대한 궁극적인 해답을 내려주지도 않습니다. AI 학습 데이터를 알고리즘으로 분석하는 행위가 공정 이용에 해당하는지에 대한 치열한 법적 공방은 수년째 명확한 결론 없이 이어지고 있으며, 일개 지방법원에 소장이 접수되었다는 사실 하나만으로 이 거대한 논쟁이 하루아침에 종결되지는 않습니다.
관련 보도와 소장을 냉정하게 읽어내는 법
성급한 결론을 내리기 전에 명심해야 할 네 가지 사실:
'혐의'는 '유죄 판결'이 아닙니다. 현재 바이트댄스의 어떠한 법적 책임도 확정된 바 없으며, '7,095'라는 숫자 역시 원고가 일방적으로 산정하여 주장하는 수치일 뿐입니다.
AI 학습 데이터 카운트 숫자는 원고의 '기술적 방법론'에 불과합니다. '7,095'라는 숫자는 EVOX가 자체적으로 자사의 이미지를 식별하고 매칭해 낸 소프트웨어적 결과값을 반영한 것입니다. 법원이 이 기술적 식별 방법과 증거 능력을 인정할지 여부는 완전히 별개의 치열한 법적 공방 영역입니다.
"1작품당 개별 배상(per-work theory)" 논리는 여전히 논란의 중심에 있습니다. 이는 배상액을 부풀려 압박하기 위한 원고 측의 가장 공격적인 법리적 주장일 뿐, 아직 확립된 판례나 법률이 아닙니다.
초기 단계의 소송은 얼마든지 엎어질 수 있습니다. 이 기술 분야의 소송에서는 진행 과정에서 소장 내용이 대폭 수정되거나, 일부 청구 항목이 기각되거나, 본격적인 재판이 열리기도 전에 막대한 금액으로 은밀하게 합의(Settlement)하고 소를 취하하는 일이 비일비재합니다.
이 모든 것이 영상/이미지 크리에이터에게 의미하는 바
만약 당신이 모델을 학습시키는 개발자(Trainers)라면: 이미지의 출처 추적(Provenance) 관리는 이제 선택이 아니라 리스크 관리의 최전선이자 생명줄입니다. 시스템에 주입하는 AI 학습 데이터는 단순한 기술적 재료가 아니라, 회사의 재무제표에 기록되어야 할 중대한 자산이자 부채 항목입니다.
만약 당신이 이미지 라이브러리를 보유한 라이선서(Licensors)라면: 당신이 가진 자산의 가치가 방금 폭등했습니다. 명확히 식별 가능하고 수량화할 수 있게 구조화된 라이브러리야말로, 기술의 합법성을 절실히 증명해야 하는 AI 학습 데이터 시장이 지금 당장 엄청난 돈을 주고서라도 사들여야 할 금맥입니다.
만약 당신이 이미지를 생성하기만 하는 일반 사용자(Generators)라면: 이 전쟁은 당신과 무관합니다. 계속해서 모델을 잘 활용하고 프롬프트 실력을 갈고닦으세요. 다만 "1작품당 개별 배상" 판결이 어떻게 결론 날지 멀리서 지켜보기는 해야 합니다. 만약 천문학적인 배상금 판결이 나온다면, 그 비용은 결국 당신이 매달 지불하는 AI 툴의 구독료 인상이라는 청구서로 돌아오게 될 테니까요.
이 사건의 맥락을 담아낸 테스트 프롬프트
이 뉴스의 본질적인 정서를 시각적으로 구현하고 싶다면, 로봇이나 판사봉보다는 '물리적인 아카이브(기록 보관소)' 자체를 정직하게 묘사하는 것이 가장 훌륭한 은유가 될 것입니다. 스톡 이미지 비즈니스의 본질은 결국 이 거대한 도서관의 디지털 버전에 불과하기 때문입니다.
Fanch AI에 복사하여 붙여넣기 (모델 선택: gpt_image_2):
A wide documentary photograph down the aisle of a vast photographic archive: long rows of steel filing drawers receding into dim depth on both sides, cardboard slide boxes stacked on open metal shelves, a single shaft of daylight falling from a high window and catching dust in the air. Fine detail in the brushed steel drawer fronts, worn paper labels and the fibre of the cardboard boxes, cool grey and warm sepia palette, deep perspective, slight vignetting at the frame edges, 16:9 framing, 8K detail, no people, no legible text.
현재의 AI 산업 생태계에서 '사진 아카이브'란, 오직 그 안에 정확히 무엇이 저장되어 있는지 수학적 정확도로 증명할 수 있을 때에만 수백억 원의 가치를 인정받을 수 있는 유일한 이미지들의 집합체입니다.
왜 Fanch AI가 크리에이터를 보호하는 최적의 방패인가
AI 학습 데이터를 둘러싼 이 거대한 법적 전쟁의 본질은 "거대 테크 기업들이 타인의 이미지 라이브러리를 어떻게 무단으로 수집하고 저장하는가"에 대한 책임을 묻는 것이지, "사람들이 창작 도구로서 AI를 사용해도 되는가"를 따지는 것이 아닙니다. 이 구분은 매우 중요합니다. 법적 처벌과 리스크의 화살은 네트워크를 학습시키기 위해 웹 데이터를 긁어모으는(Scraping) 엔지니어와 기업을 향하지, 책상에 앉아 프롬프트를 타이핑하는 개인 크리에이터를 향하지 않습니다.
Fanch AI는 사용자의 정밀한 프롬프트 지시를 완벽하게 반영하는 전용 고성능 이미지 모델을 제공합니다. 타인의 상업용 스톡 카탈로그를 뒤지며 저작권 분쟁의 위험을 떠안을 필요 없이, 당신의 창의적인 텍스트 묘사만으로 필요한 고품질 비주얼 에셋을 100% 오리지널로 직접 생성할 수 있습니다. 당신의 작품, 당신의 아이디어, 그리고 당신의 사용 권리를 의심의 여지 없이 당신의 것으로 안전하게 지켜내십시오.