
Higgsfield, AI 비디오 길이 1분에서 10분 이상으로 확장 | Fanch AI
짧은 클립 길이는 오랫동안 AI 비디오(AI video) 분야의 가장 큰 기술적 한계였습니다. 대다수 생성 도구는 수초 단위에 머물렀으며, 고성능 모델조차 1분 안팎에서 멈추는 것이 일반적이었습니다. Higgsfield는 이 한계를 깨고 연속 렌더링 시간을 기존 약 1분에서 10분 이상으로 끌어올렸다고 발표했습니다. 이 기술이 안정적으로 유지된다면 지난 1년간 AI 비디오 분야에서 일어난 가장 큰 기술적 도약이 될 것입니다.
이번 소식은 이번 주 공개된 OpenAI의 고객 도입 사례 연구를 통해 알려졌으며, 롱폼 AI 비디오 기술이 어디로 향하고 있는지를 잘 보여줍니다. 다만 벤더사의 공식 발표는 독립적인 성능 검증보다 앞서 나가는 경향이 있으므로 객관적인 시각에서 분석할 필요가 있습니다.
Higgsfield가 실제로 바꾼 기술적 차이점
OpenAI의 발표 내용에 따르면, Higgsfield는 GPT-6 Astra 기반의 워크플로우를 구축하여 자사 YouTube 채널용으로 10분이 넘는 분량의 튜토리얼 영상을 생성했습니다. Higgsfield의 CEO이자 공동 창업자인 Alex Mashrabov는 이전 시스템의 경우 단일 생성 작업당 약 1분이 한계였다고 밝혔습니다.
실무적 관점에서 가장 중요한 변화는 중간 길이 영상 제작 시 수작업 컷 편집 및 이어 붙이기가 불필요해진다는 점입니다. 편집 프로그램에서 수십 개의 짧은 클립을 이어 맞추는 대신, 한 번의 프로세스로 매끄럽게 이어지는 단일 AI 비디오를 제작할 수 있게 됩니다.
Mashrabov는 이 기능을 통해 여러 제작 인력이 파편화된 클립을 조립할 필요 없이, 단 한 명의 크리에이터가 고품질 프로덕션 전체를 처음부터 끝까지 총괄할 수 있다고 설명합니다. 이것이 바로 롱폼 AI 비디오가 제시하는 장점입니다. 작업 단계와 컷 간의 이질감을 최소화하는 것입니다.
뒷받침하는 기술 스택의 구조
Higgsfield의 워크플로우는 영상 생성과 에이전트 오케스트레이션(통합 제어)을 결합했습니다. OpenAI에 따르면 두 가지 핵심 시스템이 맞물려 현대적인 AI 비디오 파이프라인을 구성합니다:
- GPT-6 Astra — AI 비디오 생성을 주도하며, 다양한 앵글의 샷 베리에이션 생성과 같은 반복적인 제작 공정을 자동화하는 크리에이티브 에이전트를 구동합니다.
- 도구 호출(Tool calling) — GPT-6 Astra는 이러한 에이전트가 3D 모델링을 포함해 복잡한 수작업 영역의 외부 도구들을 능동적으로 호출할 수 있도록 지원합니다.
특히 3D 모델링 도구의 활용이 주목할 지점입니다. Mashrabov는 도구 호출 기능을 씬의 일관성 유지와 직접 연결 짓습니다. 동일한 배경 공간의 3D 지오메트리를 지속적으로 참조할 수 있게 됨으로써, 모델이 매 컷마다 공간 구조를 새로 추측할 필요 없이 안정적인 기준점을 갖게 됩니다. 이는 긴 호흡의 AI 비디오 제작에 필수적인 기술적 기반입니다.
여기에 또 다른 모델인 GPT-Image-2.5가 정밀한 시각 제어 레이어로 결합되어, 긴 AI 비디오가 재생되는 동안 인물의 이목구비나 아트 스타일이 변형되지 않도록 보정합니다. 단일 생성기가 아닌 복합 스택 형태로 파이프라인을 구성했다는 점이 단순 단발성 생성 툴과의 결정적 차이입니다.
일관성(Consistency)이 진짜 난제였던 이유
단순한 재생 시간 연장 자체가 기술의 핵심은 아니었습니다. 진짜 난제는 시계열적 연속성(Continuity)이었습니다. 10초짜리 짧은 AI 비디오는 프레임의 왜곡을 감출 수 있지만, 10분짜리 영상에서는 모든 불일치가 그대로 드러납니다.
컷이 전환될 때마다 얼굴 형태가 바뀌고, 옷의 재질이 달라지며, 방 안의 가구가 임의로 재배치되고, 조명이 뒤흔들립니다. 숏폼 밈 영상에서는 이를 넘어가더라도 정보 전달용 튜토리얼 영상에서는 시청자가 즉시 이탈하게 됩니다. 단일 클립의 화질이 비약적으로 발전했음에도 롱폼 AI 비디오가 제자리걸음을 했던 이유가 여기에 있습니다. 모든 전문적인 AI 비디오 프로젝트가 바로 이 벽에 부딪혀 왔습니다.
에이전트, 외부 도구, 정밀 제어 레이어를 융합한 Higgsfield의 방식은 여러 차례의 렌더링 과정을 거치면서도 가상 세계의 환경을 안정적으로 통제하려는 시도입니다. 이 시스템이 완벽히 검증된다면 단순한 영상 길이 확장을 넘어 콘텐츠 포맷 자체가 재정의될 것입니다.
이번 발표를 신중하게 바라보아야 하는 이유
기존 보도들이 대부분 간과하는 핵심 포인트가 있습니다. 이번 발표 수치는 OpenAI와 Higgsfield 측의 일방적인 자체 발표에 기반하고 있다는 점입니다. 데이터 분석 매체 Data Phoenix가 지적했듯, 해당 사례 보고서에는 출력 화질, 렌더링 소요 시간, 제작 비용, 인간의 개입 수준에 대한 제3자의 독립적인 벤치마크 검증이 포함되어 있지 않습니다.
또한 최종 완성된 10분짜리 AI 비디오가 단일 모델에 의한 원테이크 연속 생성인지, 아니면 툴에 의해 정교하게 조립된 짧은 세그먼트들의 자동화된 결합인지도 명확히 구분되어 있지 않습니다. 두 방식은 기술적으로 완전히 다른 메커니즘이며, AI 비디오 워크플로우를 도입하려는 실무진에게 매우 중요한 기준점입니다.
독립적인 검증 결과가 나올 때까지는 10분이라는 수치를 벤더사가 보고한 성능 지표로 해석하는 것이 합리적입니다. 기술적 성과를 폄하하려는 것이 아니라, 이를 맹신하고 프로덕션 파이프라인을 섣불리 뜯어고치기 전에 직접 검증해야 하기 때문입니다. AI 비디오 발표에 대해 신중한 태도를 취하는 데는 비용이 들지 않지만, 검증되지 않은 가정을 바탕으로 제작 환경을 재구축하는 데는 막대한 비용이 소요됩니다.
크리에이터에게 주는 시사점
AI 비디오를 다루는 크리에이터들을 위한 네 가지 핵심 시사점입니다:
- 연속성(Continuity)이 핵심 경쟁력입니다 — 다음 단계의 승부처는 단순한 클립 길이가 아닌 컷 간의 시각적 안정성입니다.
- 오케스트레이션이 단일 모델을 앞섭니다 — 에이전트, 외부 도구 연동, 레퍼런스 레이어의 결합이 긴 AI 비디오를 완성하는 표준 경로입니다.
- 공식 발표 수치는 직접 검증해야 합니다 — 새로운 기술을 현업에 적용하기 전 본인의 프로젝트 데이터로 반드시 테스트를 거치세요.
- 미드폼 콘텐츠가 현실적인 사정권에 들어왔습니다 — 설명 영상, 소프트웨어 튜토리얼, 기업 교육 콘텐츠가 가장 직접적인 수혜를 입을 영역입니다.
단기적으로 가장 현실적인 활용처는 영화가 아닌 교육 및 설명용 AI 비디오 영역입니다. 이는 여전히 수요가 공급을 압도하는 거대한 시장이며, AI 비디오가 예술적 완성도를 입증하기에 앞서 경제적 효율성으로 승부를 볼 수 있는 영역입니다.
지금 테스트해 볼 수 있는 프롬프트
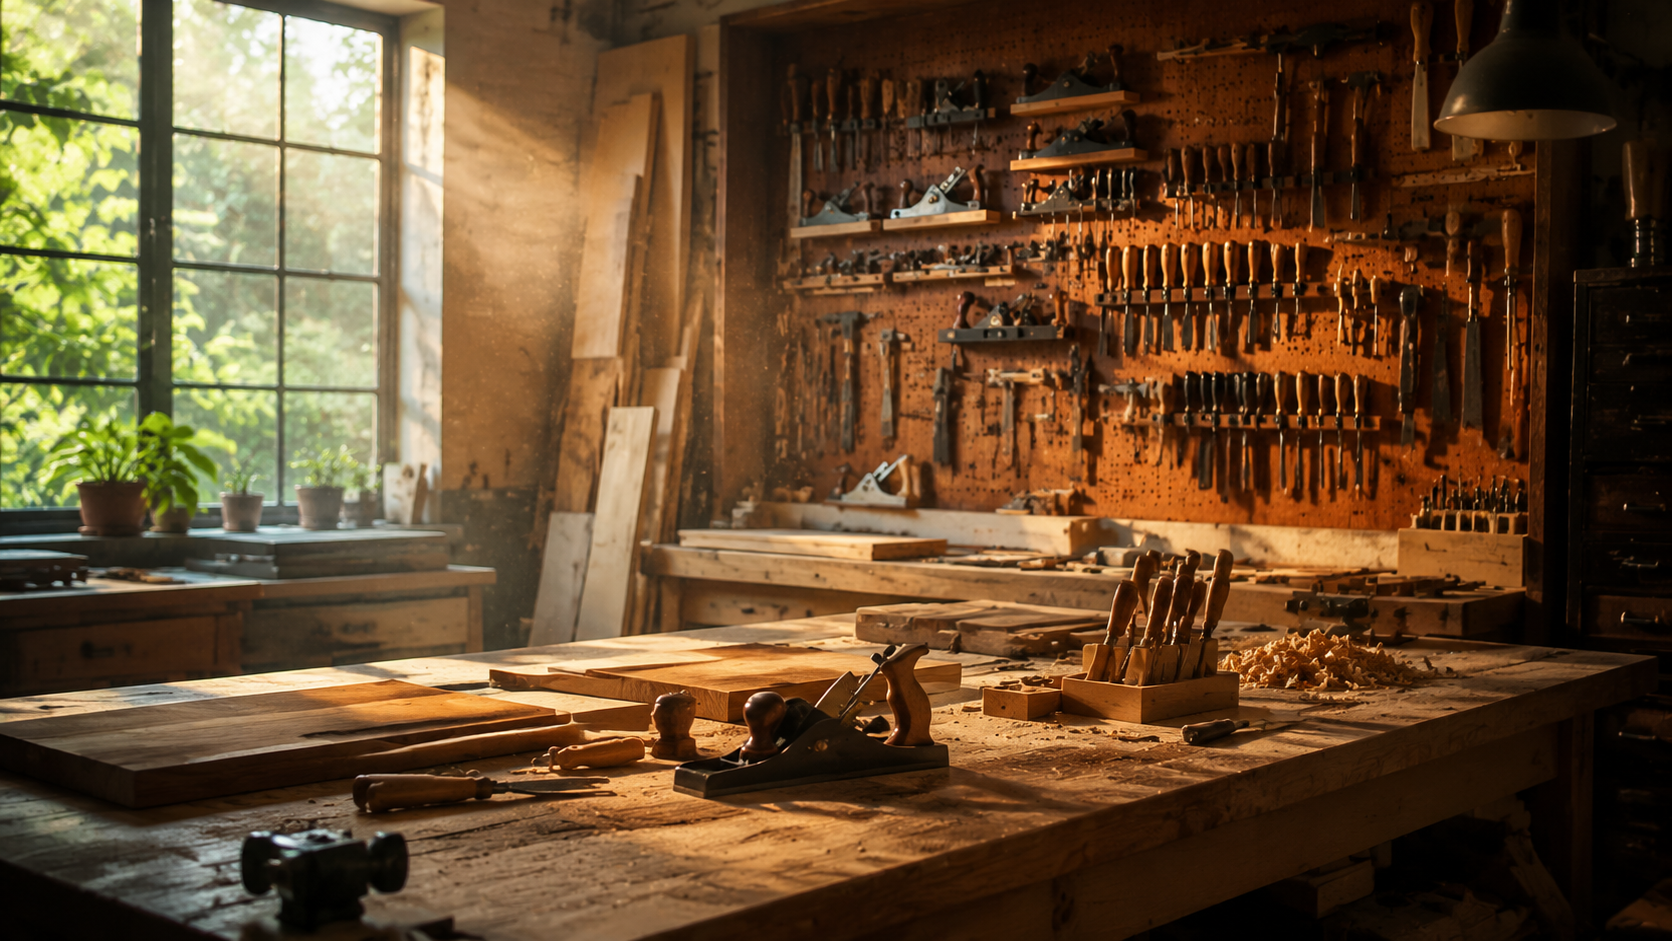
시각적 연속성은 명확하고 재현 가능한 프롬프트 묘사에서 시작됩니다. 이는 모든 완성도 높은 AI 비디오가 요구하는 기본기입니다. Fanch AI에서 이 프롬프트를 시도해 보세요:
Fanch AI에 복사하여 붙여넣기 (모델 선택: gpt_image_2):
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
Fanch AI가 이 워크플로우에 최적화된 이유
긴 호흡의 AI 비디오를 기획하든 단일 대표 컷을 제작하든, 모든 작업의 시작점은 시각적 레퍼런스 프레임입니다. Fanch AI는 정교한 프롬프트 제어가 가능한 전용 이미지 모델을 제공하여 단 1초의 AI 비디오를 렌더링하기 전에 인물의 이목구비, 의상, 조명 톤을 완벽하게 고정할 수 있도록 지원합니다. 뛰어난 영상 연속성은 정교한 정지 이미지에서 출발하며, 사용자가 완전히 통제할 수 있는 레퍼런스 프레임이야말로 AI 비디오 프로젝트의 성공을 담보하는 가장 현명한 투자입니다.
👉 여기서 시작하세요: Fanch AI의 GPT Image 2 — 내 AI 비디오에 필요한 기준 프레임을 지금 생성해 보세요.