
Higgsfield 将 AI 视频从 1 分钟突破至 10 分钟以上 | Fanch AI
片段时长一直以来都是 AI 视频(AI video) 的核心制约。绝大多数生成工具的上限仅有几秒;即便是最具野心的工具通常也在一分钟左右止步。Higgsfield 宣布其已经打破了这一天花板——将连续视频生成的时长从大约一分钟大幅跃升至 10 分钟以上。如果该技术被验证可靠,这将是 AI 视频 领域一年以来最具颠覆性的跃迁。
这一转变源于本周发布的 OpenAI 官方客户案例,它为了解长篇 AI 视频 的未来走向提供了极佳视角。同时,这也是一个值得审慎审视的论断——厂商官方公布的 AI 视频 宣传往往先行于第三方独立评测。
Higgsfield 究竟改变了什么
根据 OpenAI 的披露,Higgsfield 构建了一个基于 GPT-6 Astra 的工作流,为其 YouTube 频道生成时长超过 10 分钟的教学类视频。Higgsfield 联合创始人兼 CEO Alex Mashrabov 表示,此前单次生成的上限大约只有一分钟左右。
真正引发行业震动的是实际工作流的转变:更长的成片输出意味着对于中长视频内容无需再进行繁琐的人工拼接。根据相关公司的说法,团队无需在剪辑软件里缝合十几段破碎的短镜头,便可以直接生成一段连贯完整的 AI 视频。
Mashrabov 将这项能力定义为:单个创作者即可独立掌控整部高端成片的从头到尾制作,而不再需要一个团队去拼凑碎片。这正是长篇 AI 视频 的承诺所在:更少的交接环节,更少的分镜缝合裂痕。
其背后的技术模型栈
Higgsfield 的工作流巧妙地将底层生成与上层编排(Orchestration)结合在一起。根据 OpenAI 的说明,该方案主要依赖两大系统,它们共同展示了现代 AI 视频 生产流水线是如何搭建的:
- GPT-6 Astra — 提供底层的 AI 视频 生成能力,并驱动各类创意 Agent(智能体)自动完成重复性制作任务,例如自动生成镜头分镜变体。
- 工具调用(Tool calling) — GPT-6 Astra 允许这些 Agent 调用外部专业工具来处理复杂的人工任务,其中包括 3D 建模。
其中 3D 建模的细节尤为引人深思。Mashrabov 将工具调用与镜头一致性直接挂钩:当底层相同的场景空间几何体能够被反复调用时,模型便拥有了一个稳定的锚点,而无需在每个镜头切换时重新盲猜构想整个物理世界。这正是长篇 AI 视频 所急需的基础支撑。
此外,据报道另一款模型 GPT-Image-2.5 负责精细的视觉控制层——正是这一层级确保了角色五官和艺术风格不会在漫长的 AI 视频 中逐渐漂移失真。它们共同构成了一个复合技术栈而非单点生成器,这也是该 AI 视频 工作流与传统“一键抽卡式”短片工具的本质区别。
为何“一致性”才是真正的鸿沟
单纯延长视频长度从来不是最棘手的问题,时序连贯性(Continuity)才是。一段 10 秒的 AI 视频 几乎可以掩盖任何不一致;但一段 10 分钟的视频却会让破绽无所遁形。
面部特征漂移、服装莫名变换、房间陈设擅自重构、光影在镜头切换间跳动。观众或许能宽容一段搞笑梗片里的轻微变形,但绝不会容忍教程视频里的人物和环境频频崩坏。这就是为什么即便单镜头画面画质有了质的飞跃,长篇 AI 视频 的发展依然远滞后于短视频的原因。每一个严肃的 AI 视频 研发路线都会撞上这堵高墙。
Higgsfield 的应对策略——Agent 编排加上外部工具,配合精细控制层——本质上是一次跨多轮生成保持物理世界相对稳定的工程尝试。如果该方案全面成熟,其释放的不仅是视频时长,而是整个内容品类。
请保持客观审慎的视角
这正是多数媒体报道所略过的关键部分。Higgsfield 的所有数据均来自 OpenAI 和 Higgsfield 自身。正如科技分析机构 Data Phoenix 所指出的,该案例陈述中包含没有任何关于画质、制作耗时、综合成本或所需人工干预程度的第三方独立基准测试。
官方披露也并未明确指出,最终产出的 10 分钟 AI 视频 究竟是由单个模型一镜到底渲染生成,还是由编排工具调度缝合的大量短片段。这在技术路径上是两种截然不同的断言,对于任何打算基于 AI 视频 搭建生产线的团队来说影响巨大。
在第三方独立评测出现之前,建议将这 10 分钟的数字视为厂商官方宣称的能力。这并非要全盘否定它,而是在你围绕它重构自己的生产流水线之前先进行严格求证。对一项 AI 视频 宣传保持审慎不会带来任何损失;但围绕错误的预设立场搭建流程却会付出高昂代价。而一旦该 AI 视频 指标被实测坐实,整个中长视频赛道的规则将被彻底重写。
这对创作者意味着什么
对于任何从事 AI 视频 制作的创作者,有三个清晰的实战启示:
- 镜头连贯性是全新的竞技前沿 — 下一个分水岭不再是单段时长,而是跨镜头的时空稳定性。
- 系统编排远胜于单次生成 — Agent、外部工具与多层参考,才是产出高质量长篇 AI 视频 的工业化路径。
- 官方数据务必亲自求证 — 在盲信宣传之前,务必先在自己的业务素材上实际测试。
- 中长视频格式迎来可行性契机 — 讲解视频、操作教程和培训课件是受该技术冲击最深的内容形态。
这项技术短期内的现实落地场景在于教学与解说类 AI 视频,而非院线电影。这依然是一个体量庞大且未被充分满足的高频市场,也是 AI 视频 在赢得艺术赞誉之前率先凭借商业效率取胜的阵地。
今天即可测试的提示词
画面的时空一致性始于清晰、可复现的视觉描述——这正是任何优质长篇 AI 视频 所赖以生存的基础功底。不妨在 Fanch AI 上尝试这个提示词:
复制并粘贴至 Fanch AI(模型选择:gpt_image_2):
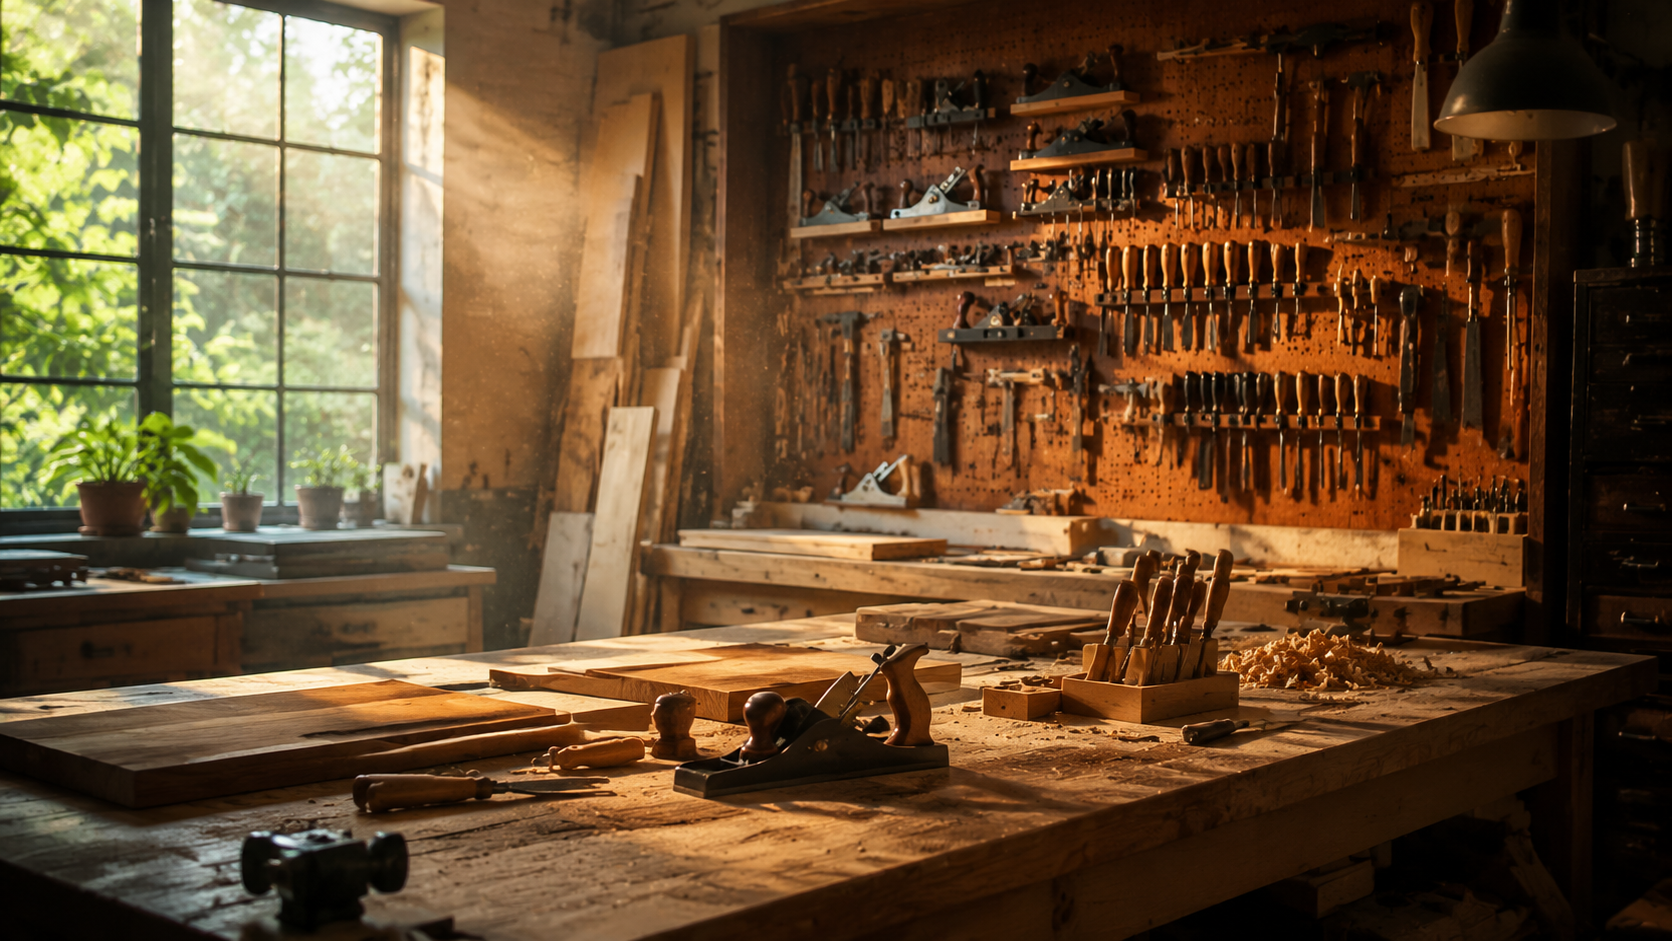
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
为什么 Fanch AI 契合长视频创作流
无论你是要打造一段长篇 AI 视频,还是单独打磨一张核心主视觉,视觉参考永远是第一位的。Fanch AI 为你提供专用的图像生成大模型,你可以通过精准的提示词进行控制——在生成任何一秒钟的 AI 视频 之前,先锁定精准的人物形象、服装风格与光影方案。优秀的时空连贯性始于一张经得起考验的静止参考帧,而一张完全由你自主掌控的参考图,正是一个 AI 视频 项目所能获得的最划算的保险。