
香港大学最新 AI 视频基准评测:画质与安全防线呈现两极分化 | Fanch AI
香港大学的一份最新 AI 视频基准评测(AI video benchmark) 得出了一个令各方都颇感微妙的结果。这份由香港大学经管学院发布的评估报告指出,中国视频大模型目前在视觉画质上处于领先地位——Seedance 2.0 Pro 在生成能力上力压 Veo 3.1 与 Sora 2 Pro 荣登榜首;然而,这些模型在安全防护机制上却相对落后。
这种两极分化的结论,正是该 AI 视频基准评测 值得深入探究的原因所在。这是首个在同一评价框架下同时衡量“生成画质”与“安全防护”的权威评测,而评测结果的两半却指向了截然相反的方向。
港大报告的核心发现
该 AI 视频基准评测 得出了三大核心结论:
画面生成质量格局逆转。 在本次 AI 视频基准评测 中,领跑的中国模型在视觉生成得分上全面超越了美国主流顶级模型。这一结果颠覆了大多数人迈入 2026 年时的固有认知——彼时 Veo 与 Sora 被广泛视为行业天花板,而该评测表明这一假设已不再成立。
安全防护能力并未同步领先。 同一份 AI 视频基准评测 发现,中国模型在安全对齐与防御性措施上表现较弱——正如香港媒体所引述的报告原话,这些模型普遍倾向于“重画质、轻防御”。
这种差距源于产品取舍,绝非技术偶然。 综合来看,评测数据勾勒出两类定位截然不同的模型:一类全力为生成效果优化,对潜在越狱的拦截相对宽松;另一类则将大量算力用于安全合规。这是根本性的产品路线抉择,而只有同时考量两者的 AI 视频基准评测 才能揭示这一点。
为什么是由商学院主导这项评测
评测的发起背景决定了其参考价值的分量。这并非计算机系实验室在合成数据集上比拼 PSNR 跑分的纯学术测试,而是来自港大经管学院。这一背景深刻影响了提问角度与答案走向:侧重考察实际商业生产力、产品级行为特征,以及企业客户真正关心的合规风控姿态。
因此,该 AI 视频基准评测 对企业采购决策者的参考价值远高于科研人员。它解答的是“哪个模型更好用、哪些指令会被拦截”,而非“哪种架构在损失函数收敛上更优”。
但这也确立了其局限性。单一机构依据自研标准产出的评测,只能算作一个强有力的参考数据点,而非盖棺定论的终极天梯。该 AI 视频基准评测 尚未经过同行评审,提示词测试集、打分权重分配以及所选模型版本均带有作者的主观考量。
视频模型的“安全防护机制”究竟意味着什么
在文本模型中,“安全”是一个相对非黑即白的判断:模型是否拒答了违规请求。但视频生成要复杂得多,而这正是 AI 视频基准评测 发挥价值的地方。
对于视频模型,评测的防御维度涵盖多重指标:是否能拒答明显违规的提示词;当违规诉求被包装在看似无辜的叙事语境中时,模型能否坚守防线;在触发敏感边界时是平滑降级处理,还是直接崩溃产出废片;针对公认的高风险类别(名人肖像侵权、暴力、成人内容)是具备确定性拦截能力,还是仅凭概率随机漏审。
一个在视觉保真度上表现惊艳、但在上述行为准则上得分垫底的模型,具备鲜明的工具属性:对于恪守边界的专业创作者而言,它是极其出色的生产力利器;但对于直接面向公众开放的平台而言,它则蕴含着不可忽视的运营风险。一份兼顾双维度的 AI 视频基准评测,能让你基于真实数据做决定,而非盲目猜测。
理性审视任何 AI 视频基准评测
在参考此类评测时,有四项保留意见需要铭记,这同样适用于此前厂商自己发布的宣传图表:
孤证难成定论。 单一机构的 AI 视频基准评测 是强有力的阶段性佐证,但绝非终极铁证。其评测方法论仍有待行业跨机构复现验证。
天梯榜单极易过时。 没有哪份 AI 视频基准评测 的时效性能完好维持一个季度。Veo 3.1、Sora 2 Pro 与 Seedance 2.0 Pro 皆为近期版本,下一代迭代模型早已箭在弦上。任何榜单都只是高速运动物体的一张静态瞬时切片。
“视觉质量”本身是一个主观建构。 评分高低完全取决于评测体系偏好什么——是运动连贯性、微观纹理、物理光影、提示词遵循度,还是人类评委的感官审美。两套同样合理的评测标准,完全可能给出一组截然相反的模型排名。
国别并非核心变量。 解读这份 AI 视频基准评测 的有效视角,不应流于“中美模型对决”的表面叙事,而应看到“偏向输出表现的模型”与“偏向拦截防御的模型”之间的博弈。国别标签是新闻热点,但底层取舍才是技术启示。
这对视频创作者意味着什么
如果你严肃对待这份 AI 视频基准评测 的结论,有三条务实的建议:
不必再默认美国模型是画质上限。 至少在画面生成表现上,差距已经被抹平甚至逆转——这是该评测最重磅的信号。如果你此前因画质顾虑而放弃过国产模型,现在值得重新评估。
在选定生产流前,先摸清模型的拒答边界。 一份显示某模型在安全防御上得分偏低的 AI 视频基准评测 能提供关键运营参考:在处理临界或边缘题材提示词时,你的沟通摩擦是更多还是更少。
因题择器,不迷信品牌光环。 在 AI 视频基准评测 中斩获总分第一的模型,放到你具体的镜头分镜表上依然可能会失灵。这三项认知构成了评测的真价值:将空洞的品牌信仰转化为理性的采购决策。
如何搭建你自己的微型基准测试
面对外界发布的各类 AI 视频基准评测,最有价值的回应是花上二十分钟跑一套属于你自己的微型测试:
1. 固定五条提示词。 覆盖你日常业务真实用到的场景:人物运动、运镜推进、材质微距特写、包含文字的表面、抽象概念表达。
2. 锁死生成参数。 统一画幅比例、统一输出时长,在支持的工具中尽可能固定随机种子(Seed)。否则你测出的只是参数差异,而非模型实力。
3. 严格限定三个打分维度。 提示词遵循度、运动时序连贯性、瑕疵伪影数量。切忌增加过多评价轴,以免失去评判焦点。
4. 坚持以正常速度回放验收。 拖动进度条预览会掩盖运动失真,而运动崩坏正是 AI 视频最容易露馅的地方。
5. 每季度重新横评一次。 所有公开的评测都会过时,你的个人基准库也是如此。
你自己跑出来的五条提示词结果,在数据规模上或许不如港大的大报告完备,但它对你而言会实用得多,因为它是精准对照你自己的业务产出衡量的。
今天即可测试的对比提示词
如果你想测试模型的运动连贯性,建议使用包含一个明确主体动作与一个明确运镜轨迹的镜头——元素再多就无法定位究竟是哪一部分出现了崩坏。这正是专业评测标准的标准框架:
复制并粘贴至 Fanch AI(模型选择:gpt_image_2):
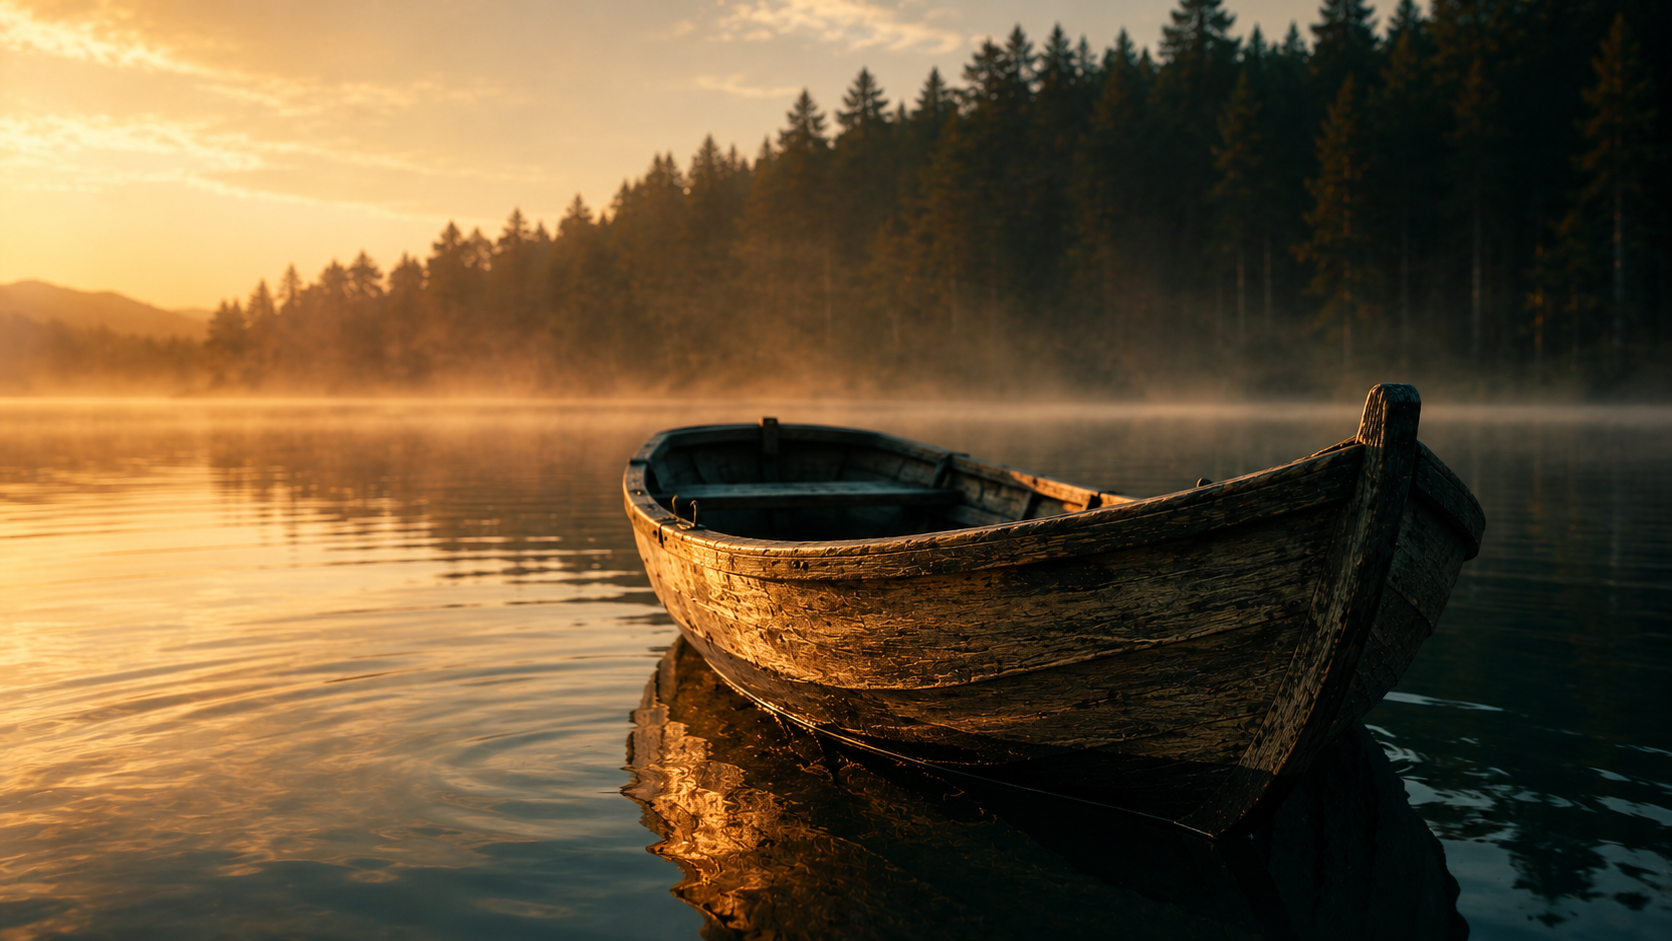
A cinematic still of a lone wooden rowboat drifting on a calm lake at golden hour, seen from a low angle just above the waterline: warm rim light along the hull, gentle ripples spreading outward, distant mist-covered pine treeline, soft haze in the air. Fine detail in the wet wood grain and water surface, shallow depth of field, warm amber and cool teal palette, 16:9 framing, 8K detail, no people, no text overlay.
先锁定这一基准静止帧,随后将其推入动态视频模型中,仔细观察画面中有哪些细节稳定幸存了下来。
为什么 Fanch AI 适合你的创作流
一份优秀的 AI 视频基准评测 揭示了一个事实:顶级模型之间的基础画质差距已经缩小到需要靠精细的提示词功底来决出胜负。Fanch AI 为你提供专用的精准图像大模型,让你在真正消耗昂贵视频算力之前,先用成本极低的静态图敲定构图与光影——在一个完全受控的基准帧之上,公平评判各个视频模型的真正实力。