
本地 AI 图像生成:你早已拥有的显卡究竟需要付出多少真实成本 | Fanch AI
本地 AI 图像生成(local AI image generation) 的吸引力几乎让人无法抗拒:你手里本来就有现成的显卡,因此单张图片的边际生成成本几乎为零。XDA 最近流传甚广的一篇深度评测就持有这一论调——作者用自己已有的单块 GPU 跑通了文献调研、代码编写和图像生成全流程,完全不需要承担任何按月订阅费用。
这种表述既符合事实,却又并不完整。本地 AI 图像生成 确实能做到单张图片边际成本趋近于零。但它依然有一张不可忽视的账单,而这张账单是由三个从不会出现在宣传头条里的货币来支付的:电费消耗、系统维护时间,以及最终的成片画质差距。
以下是这套自建方案的真实技术架构、实际隐性成本,以及 本地 AI 图像生成 能够取得压倒性优势的特定业务场景。
自建本地技术栈的真实面貌
在那篇评测中描述的部署方案并非零散脚本的简单堆砌,而是一个基于 Pixeltable 构建的统一应用,针对不同任务挂载了差异化模型:开源图像模型负责视觉生成,代码大模型负责编程辅助,混合专家(MoE)模型负责处理深度调研类工作。
目前在 本地 AI 图像生成 圈子里最受推崇的典型硬件配置是 16GB 显存的 RTX 4070 Ti Super,配合运行用于生图的 FLUX 和用于编程的 Qwen。这只是一张中端消费级家用显卡,而不是昂贵的数据中心工作站——这恰恰是整个论点的核心:本地 AI 图像生成 的准入门槛已经大幅降低到了“一块你可能早已持有的显卡”。
这套方案真正耐人寻味的地方在于“一体化整合”。多数折腾 本地 AI 图像生成 的创作者最终往往使用三套割裂的工具,彼此状态完全无法互通。而把图像生成、代码编写与背景调研打包进同一个工作流中,其本质是一次工作流效率的升级,而非纯粹的硬件堆砌。
为什么说“现成显卡零成本”只说对了一半
本地 AI 图像生成 的经济学逻辑建立在一个经典原则之上:沉没成本不是成本。如果你的机器里原本就为了玩大型游戏或剪辑 4K 视频插着一块高端 GPU,那么顺手用它来跑图的新增增量成本确实只有电费而已。
你可以自己算一笔账:查一下显卡满载运行时的功耗——中端卡按 300W 计算,运行一小时耗电 0.3 度。以每度电 0.20 美元(约合人民币 1.4 元)折算,连续满载生图一小时的成本大约只有 6 美分。根据所选模型与具体步数设定,跑满一小时 本地 AI 图像生成 产出的图片数量,甚至超过轻度用户一个月在商用 API 上的调用总量。
这确实是一笔非常划算的买卖,也正是 本地 AI 图像生成 持续吸引大量创作者投身其中的原因。但请注意,这仅仅是整个财务账本中唯一经常被拿出来公开宣传的一面。
从未出现在头条新闻里的三大隐性成本
你的时间成本。 运维一套 本地 AI 图像生成 环境是一项长期的维护负担。模型权重频繁更新、自定义节点莫名报错、显卡驱动更新后性能倒退、或者整条环境依赖链在周二早晨突然无法加载。如果你乐于折腾这些,这是一种能带来成就感的技术爱好;但如果你只想安稳产出成果,它就是一份没有任何报酬的兼职网管工作。
无法忽视的画质鸿沟。 这是评估 本地 AI 图像生成 时最客观的一点。顶级的云端闭源模型在微观纹理表现、极小字体排版渲染以及复杂人体解剖结构上依然稳居上风。在 16GB 显存卡上跑 本地 AI 图像生成 意味着必须采用量化模型(Quantized models),而模型量化所牺牲的恰恰就是这些极致的画面细节。
缺乏可用性保障(SLA)。 云端商业模型宕机时会有专门的工程师团队抢修恢复;而当你的本地显卡过热保护、或者底层依赖库版本冲突时,本地 AI 图像生成 就会直接瘫痪,排查修复完全由你一人承担。
难以兼顾团队协作。 一旦团队中有第二个人需要调用算力,本地单机部署就会被迫演变成局域网服务器,而服务器搭建意味着整套基础设施运维难题接踵而至,唯一的区别是这次值班待命的人变成了你自己。
本地 AI 图像生成完胜云端的四大场景
在这四种场景下,投入精力搭建本地环境的性价比极高:
极高频、大批量的出图需求。 一旦硬件采购到位,本地 AI 图像生成 的边际成本取决于你的耐心而非信用卡额度。挂机通宵批量跑几百张变体草图毫无资金压力。
严苛的数据隐私与保密要求。 生成素材与输入提示词物理层面完全禁止流出本机。对于签署了保密协议(NDA)的商业客户项目,本地 AI 图像生成 从根源上消除了合规争议。
专属风格资产沉淀(模型微调)。 使用你自己的原创作品对开源模型进行 LoRA 或微调训练,能沉淀出任何提示词工程都无法复刻的绝对一致画风。这是选择 本地 AI 图像生成 最强有力的商业理由,却往往被多数人低估。
摆脱审查风控的摇号机制。 如果你完全合法的提示词频繁被商业云端模型的安全策略误杀拦截,自己部署开源模型是最彻底的解决路径。本地 AI 图像生成 不存在预设的内容审查机制——这赋予你完全的创作自由,同时也意味着所有法律与合规责任需由你全权自负。
本地部署的劣势所在
对劣势同样需要有清醒认知:
如果你需要最顶级细腻的表皮纹理、精准的小字排版、或者一次成型的复杂手部动作,顶尖的云端前沿大模型依然胜出。如果你希望团队多人能随时通过浏览器异地协作且免去一切运维烦恼,你本质上需要的是成熟的 SaaS 云端产品。如果你一个月只零星生成几次,节省下来的电费永远无法弥补最初折腾 本地 AI 图像生成 所耗费的漫长时间。
一个客观的定位准则是:本地 AI 图像生成 服务于高吞吐量、绝对隐私与深度自定义控制;而云端托管平台则服务于即开即用、极限画质与省心免维护。
16GB 显存的现实局限
16GB 是一道硬性的物理分水岭,它严格限制了你的 本地 AI 图像生成 环境所能企及的上限。
运行经过合理量化的图像大模型毫无压力;但想在本地以全精度运行混合专家(MoE)文本模型则完全不切实际——你只能运行精简蒸馏版或深度量化版本,其推理质量损失肉眼可见。而在 16GB 显存上本地运行长篇 AI 视频生成,目前只能是一场极客实验,根本无法胜任高强度的日常生产管线。
因此,一张 16GB 显存的显卡是一台极其优秀的 本地 AI 图像生成 工作机,但在兼顾多模态其他高负载任务时则充满妥协。如果图像生成占据你日常业务的 80%,买这块卡完全合理;但如果生图只占 20%,你其实是在为剩下的 80% 妥协买单。
实用的落地推进路径
1. 先从纯图像生成起步。 在 本地 AI 图像生成 稳定出图之前,不要过早追求复杂的一体化工具链。先跑通单一模型、单一加载器、单个本地输出目录。
2. 审慎选择量化级别。 拿同一条提示词在两种不同精度下对比跑图。画面差异会直接告诉你你的硬件能够承载的真实生产级上限在哪里。
3. 记录你投入的第一个小时。 统计的不是纯渲染耗时,而是环境搭建与排错时间。这个数字才是你测算 本地 AI 图像生成 真正回本周期的核心投入,而绝大多数人从不计算这笔账。
4. 始终保留一套云端备份方案。 将 本地 AI 图像生成 用于大批量概念试错与发散探索,当客户需要一张毫无瑕疵的终稿高保真主图时切换至顶级云端模型。这是多数成熟团队采用的最优组合策略。
5. 每半年重新评估一次算力账本。 本地开源生态演进迅猛,画质代差也在快速收窄。半年后评估 本地 AI 图像生成 的收益公式,必然与你今天计算出的结果大不相同。
值得亲测的测试提示词
在决定搭上整个周末折腾本地环境之前,不妨先测试一下你相中的模型能否驾驭你真正需要的题材。静物题材能迅速暴露模型对光影物理分布与微观材质纹理的掌控力:
复制并粘贴至 Fanch AI(模型选择:gpt_image_2):
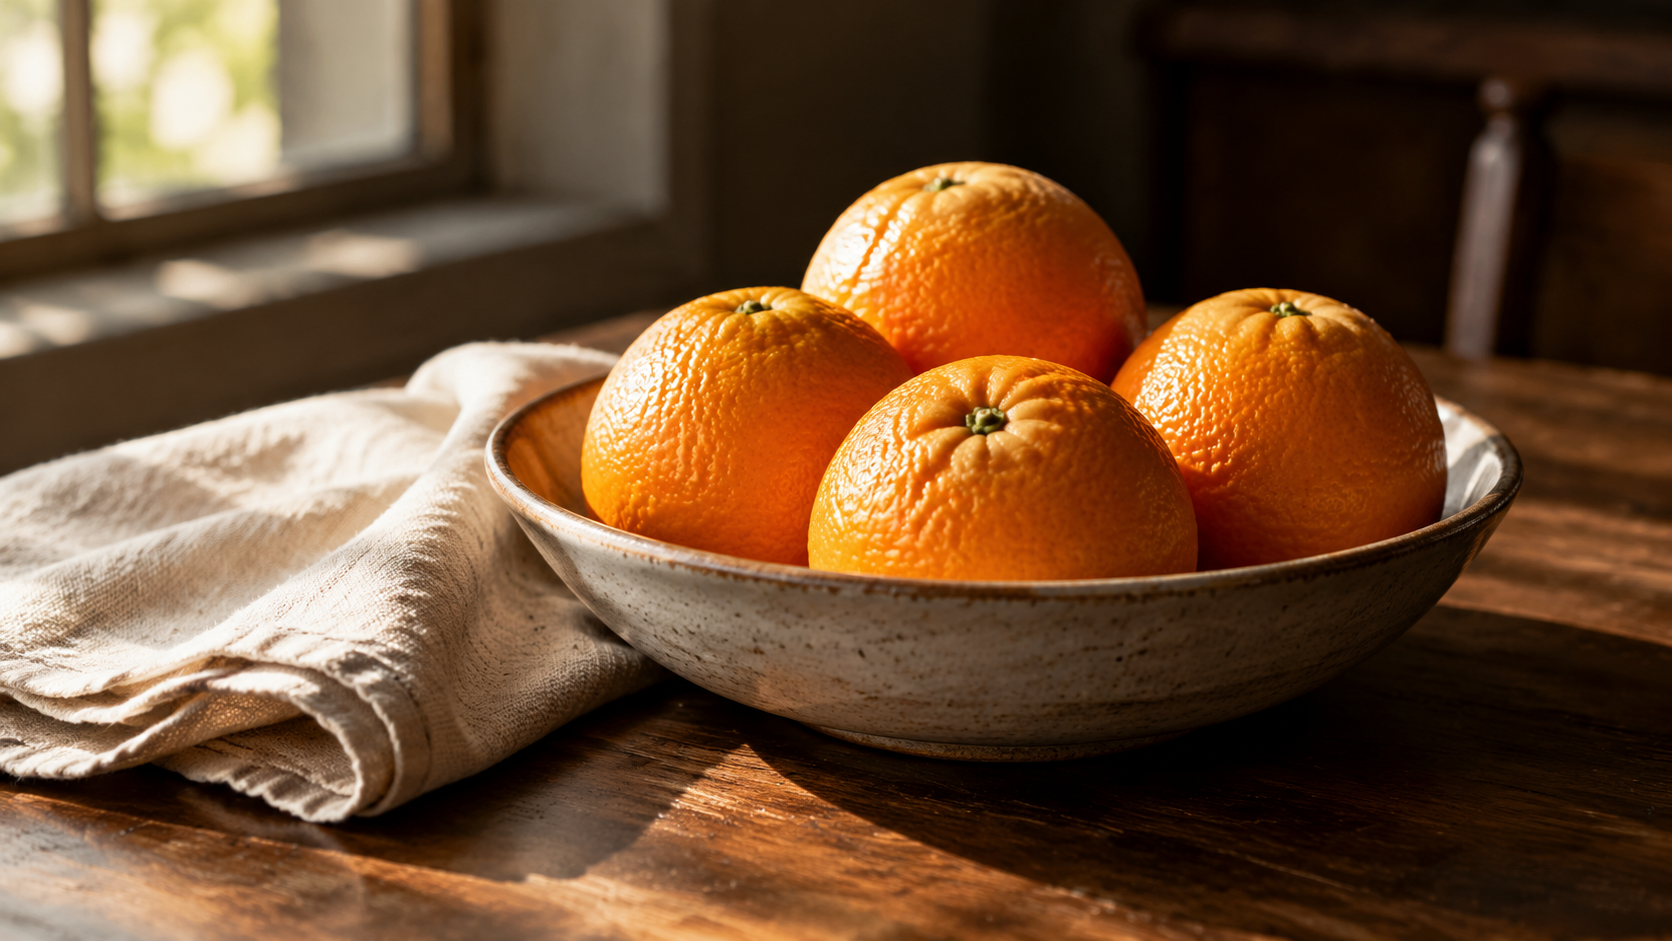
A moody editorial still life on a dark walnut table: a shallow ceramic bowl holding four ripe oranges, a folded linen napkin beside it, soft window light from the left falling across the fruit, deep shadows in the background. Visible texture in the orange peel and the ceramic glaze, muted warm palette, shallow depth of field, fine film grain, 16:9 framing, 8K detail, no people, no brand logos, no text overlay.
用完全相同的提示词在你自己的 本地 AI 图像生成 环境里跑一次。这种面对面的视觉对比,才是检验你本地硬件表现最具实战价值的基准测试。
为什么选择 Fanch AI 作为主力创作阵地
本地 AI 图像生成 能够很好地解决高吞吐量、隐私隔离与风格微调的问题;但在需要以最短时间交付顶级画质时,它并不是最优解。成熟团队的标准配置往往是本地与云端结合:先在开销极低的基准环境中确定画面构图与核心视觉。
Fanch AI 拥有专门优化的云端图像大模型,支持精准的提示词控制。你可以先在 Fanch AI 上低成本敲定精准的画幅构图、光影方案与色彩基调,筛选出满意的标杆帧之后,再在自己的本地硬件上批量派生更多变体。