
منصة Higgsfield ترفع مدة فيديو الذكاء الاصطناعي من دقيقة إلى أكثر من 10 دقائق | Fanch AI
ظلت المقاطع القصيرة تشكل العائق الهيكلي الأبرز أمام انتشار فيديو الذكاء الاصطناعي (AI video). إذ تتوقف معظم أدوات التوليد عند بضع ثوانٍ؛ وحتى الأدوات الأكثر طموحاً نادراً ما تتجاوز حدود الدقيقة الواحدة. غير أن منصة Higgsfield تؤكد أنها تمكنت من كسر هذا السقف — منتقلة بمدة التوليد المتواصل من دقيقة واحدة تقريباً إلى أكثر من 10 دقائق. وإذا ثبتت فاعلية هذا الإنجاز عملياً، فإنه سيمثل أكبر نقلة نوعية يشهدها مجال فيديو الذكاء الاصطناعي منذ عام كامل.
ينبثق هذا التحول من دراسة حالة نشرتها شركة OpenAI رسمياً هذا الأسبوع، وهي تقدم دليلاً عملياً مهماً لتوجهات المحتوى الطويل في مجال فيديو الذكاء الاصطناعي. كما تمثل إعلاناً يستوجب القراءة الموضوعية المتأنية — ذلك أن البيانات الصادرة عن الشركات المطورة لتقنيات فيديو الذكاء الاصطناعي غالباً ما تسبق نتائج الاختبارات المستقلة.
ما الذي غيرته Higgsfield عملياً؟
وفقاً لتقرير OpenAI، طورت Higgsfield سير عمل يعتمد على نموذج GPT-6 Astra لإنتاج مقاطع فيديو تعليمية تتجاوز مدتها 10 دقائق لقناتها على يوتيوب. وأوضح الشريك المؤسس والرئيس التنفيذي لـ Higgsfield، أليكس ماشاربوف (Alex Mashrabov)، أن أقصى مدة للتوليد في النظام السابق كانت تقف عند حدود دقيقة واحدة تقريباً لكل عملية.
إن التحول الجوهري يكمن في البعد التشغيلي: المخرجات الأطول تعني الاستغناء تماماً عن المونتاج والدمج اليدوي لإنتاج مقاطع الفيديو متوسطة الطول. فبدلاً من تجميع عشرات المقاطع القصيرة داخل برامج التحرير، بات بإمكان فريق العمل إخراج فيديو بالذكاء الاصطناعي متواصل في ملف واحد — على الأقل وفقاً لما تعلنه الشركتان.
يصف ماشاربوف هذا التطور بأنه يتيح لصانع محتوى فردي قيادة إنتاج احترافي متكامل من البداية حتى النهاية، بدلاً من الاعتماد على فريق كامل لجمع اللقطات المتفرقة. تلك هي الغاية الكبرى من فيديو الذكاء الاصطناعي الطويل: تقليص التدخل اليدوي، والتخلص من الفواصل المونتاجية الظاهرة.
البنية البرمجية والنماذج الداعمة
يجمع مسار عمل Higgsfield بين التوليد البصري والإدارة التنسيقية الذكية (Orchestration). وطبقاً لـ OpenAI، يقوم النظام على ركيزتين توضحان معاً كيفية بناء خطوط الإنتاج الحديثة لـ فيديو الذكاء الاصطناعي:
- GPT-6 Astra — يتولى مهمة توليد فيديو الذكاء الاصطناعي ويشغل الوكلاء البرمجيين (Creative Agents) المسؤولين عن أتمتة المهام الإنتاجية المتكررة، مثل توليد زوايا متعددة للمشاهد.
- استدعاء الأدوات الخارجية (Tool calling) — يتيح GPT-6 Astra لهؤلاء الوكلاء تشغيل برمجيات متخصصة لمعالجة العمليات اليدوية المعقدة، وفي مقدمتها النمذجة ثلاثية الأبعاد (3D modeling).
تفصيلة النمذجة ثلاثية الأبعاد هي المحور الأكثر أهمية هنا. إذ يربط ماشاربوف بين استدعاء الأدوات وبين الاتساق البصري بصورة مباشرة: فحينما يستند النظام إلى نموذج هندسي مكاني ثابت يمكن الرجوع إليه مراراً، يمتلك النموذج مرجعاً بصرياً مستقراً بدلاً من إعادة اختراع أبعاد المشهد والبيئة المحيطة مع كل لقطة جديدة. هذا هو الأساس الهندسي الذي يتطلبه توليد فيديو بالذكاء الاصطناعي طويل ومترابط.
وتفيد التقارير بوجود نموذج ثانٍ، هو GPT-Image-2.5، يتولى التحكم البصري الدقيق — وهي الطبقة المسؤولة عن منع تشوه ملامح الشخصيات وتبدل الأنماط الفنية عبر المشاهد المتعاقبة لـ فيديو الذكاء الاصطناعي. يشكل هذان النموذجان معاً منظومة تقنية متكاملة وليست مجرد أداة توليد مفردة، وهو ما يميز هذا المسار عن أدوات المقاطع القصيرة المعتادة.
لماذا ظل الاتساق البصري هو التحدي الحقيقي؟
لم تكن المدة الزمنية المجردة هي العقدة التقنية الأساسية، بل كان الاتساق الزمني (Continuity). فمقطع فيديو بالذكاء الاصطناعي مدته 10 ثوانٍ يمكنه إخفاء معظم العيوب؛ لكن مقطعاً مدته 10 دقائق يفضح أدنى تفاوت.
تتغير ملامح الوجوه، وتتبدل أقمشة الملابس، ويعاد ترتيب الغرف تلقائياً، وتضطرب زوايا الإضاءة بين اللقطات. قد يتسامح الجمهور مع هذه الأخطاء في المقاطع الترفيهية السريعة، لكنهم يغادرون فوراً إذا ظهرت في مقطع تعليمي أو مهني. لهذا السبب تأخر تطوير فيديو الذكاء الاصطناعي الطويل عن المقاطع القصيرة رغم القفزة الهائلة في جودة اللقطة الواحدة. وكل خطة عمل احترافية في هذا المجال اصطدمت بالجدار ذاته.
إن منهجية Higgsfield — بدمج الوكلاء، والأدوات الخارجية، وطبقات التحكم المرجعي — تمثل محاولة للحفاظ على استقرار العالم البصري عبر أجيال متتالية من التوليد. وإذا أثبتت نجاحها، فإن التحول لن يقتصر على زمن التشغيل، بل سيغير بنية تنسيقات المحتوى برمتها.
لماذا ينبغي قراءة هذه الأرقام بتأنٍ وموضوعية؟
هنا تكمن الجزئية التي تتجاهلها معظم التغطيات الإعلامية السريعة: الأرقام الصادرة عن Higgsfield منسوبة بالكامل إلى OpenAI وHiggsfield نفسيهما. وكما لفت تحليل منصة Data Phoenix المتخصصة، لا يتضمن التقرير أي اختبارات قياسية محايدة تقيم جودة المخرجات، أو زمن المعالجة، أو تكلفة التشغيل، أو حجم التدخل البشري المطلوب لإتمام الفيديو.
كما لا يوضح الإعلان الرسمي ما إذا كان فيديو الذكاء الاصطناعي النهائي الذي تبلغ مدته 10 دقائق قد نتج عن معالجة فردية متصلة من النموذج أم عن تجميع آلي لمقاطع أصغر تم دمجها عبر برمجيات مساعدة. يمثل هذان المساران واقعين تقنيين مختلفين جذرياً، وتفريقهما ضروري لأي فريق عمل يخطط لبناء إنتاجه على فيديو الذكاء الاصطناعي.
لذا، من الحكمة التعامل مع مدة الـ 10 دقائق باعتبارها إمكانية معلنة من الشركة المطورة حتى تؤكدها الاختبارات المستقلة. والهدف هنا ليس التشكيك، بل التيقن قبل إعادة هيكلة خطوط الإنتاج. فالتريث تجاه بيانات فيديو الذكاء الاصطناعي لا يكلف شيئاً؛ بينما بناء بنية عمل على افتراضات غير دقيقة يكلف الكثير. وإن صحت هذه الأرقام، فإن فئة مقاطع الفيديو متوسطة الطول ستشهد تغييراً غير مسبوق.
ماذا يعني ذلك لصناع المحتوى؟
تبرز أربع حقائق أساسية لكل من يعمل في مجال فيديو الذكاء الاصطناعي:
- الاتساق الزمني هو خط المنافسة الحقيقي — معيار التفوق القادم لن يقاس بطول المقطع، بل بثبات العناصر عبر المشاهد المتعاقبة.
- التنسيق البرمجي يتفوق على أدوات التوليد المفردة — الاستعانة بالوكلاء، والأدوات الخارجية، وطبقات التحكم هي السبيل الوحيد لإنتاج فيديو ذكاء اصطناعي طويل ومترابط.
- الأرقام الرسمية تحتاج لاختبار ميداني — احرص دائماً على تجربة الميزات المعلنة على محتواك وبياناتك الخاصة قبل اعتمادها.
- المحتوى متوسط الطول أصبح هدفاً ممكناً — مقاطع الشرح، والدروس التعليمية، والمحتوى التدريبي هي المجالات الأكثر استفادة من هذه التقنية.
إن الأثر الملموس في المدى القريب سيظهر في مقاطع فيديو الذكاء الاصطناعي التعليمية والإرشادية، وليس في الإنتاج السينمائي. وهو قطاع ضخم يشهد طلباً متزايداً، ويستطيع فيه فيديو الذكاء الاصطناعي أن يحسم المنافسة بمزاياه الاقتصادية وسرعة تنفيذه قبل أن يحسمها بمعايير الإبهار الفني.
موجه مقترح يمكنك تجربته اليوم
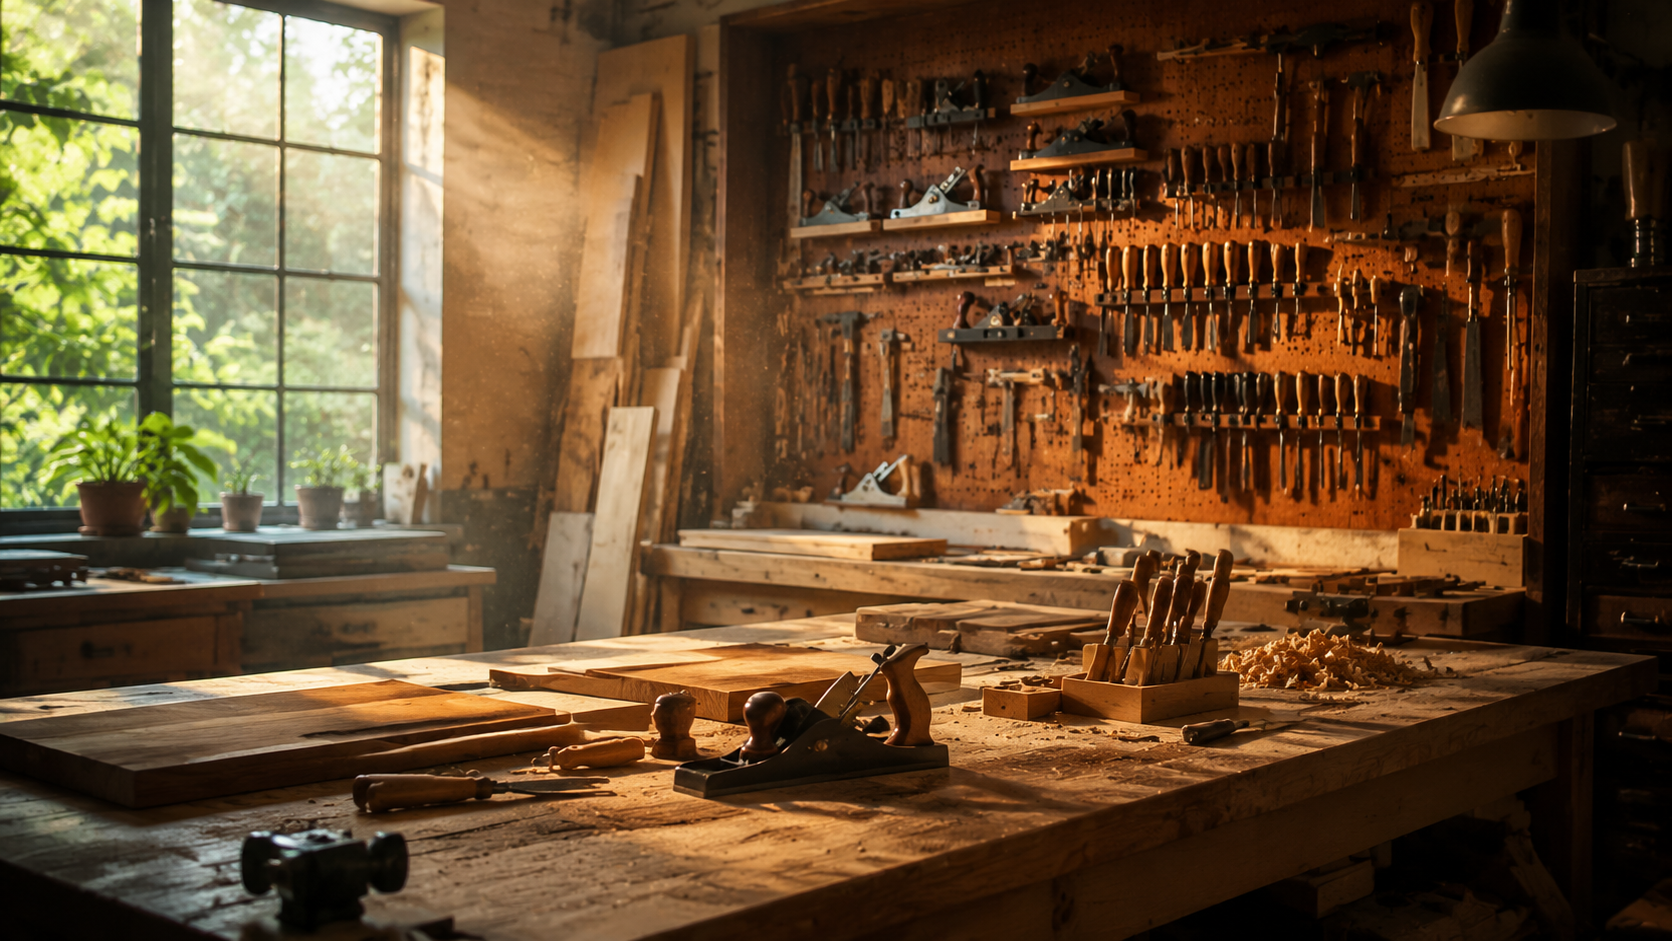
يبدأ الاتساق البصري من وصف المشهد بصياغة واضحة وقابلة للتكرار — وهي الركيزة التي يقوم عليها أي فيديو ذكاء اصطناعي متماسك. جرب هذا الموجه على Fanch AI:
انسخ والصق هذا الموجه في Fanch AI (النموذج: gpt_image_2):
Create a cinematic establishing shot of a modern woodworking workshop interior, with a large window on the left casting warm afternoon light across a workbench, neatly arranged hand tools on a pegboard wall, and fine sawdust drifting in the light beams. Wide-angle composition with clear foreground-to-background depth, natural color grading, editorial cinematography style, 16:9 framing, 8K detail, no text.
لماذا توفر منصة Fanch AI الأساس الأمثل لهذا المسار؟
سواء كنت تخطط لإنتاج فيديو ذكاء اصطناعي طويل أو تصميم لقطة رئيسية مفردة، فإن الصورة المرجعية هي الأساس الذي تبنى عليه كافة التفاصيل اللاحقة. توفر لك منصة Fanch AI نموذج صور متخصصاً تديره بموجهات دقيقة — مما يتيح لك تثبيت هوية الشخصية، وملامح أزيائها، ونمط إضاءتها بدقة متناهية قبل توليد ثانية واحدة من فيديو الذكاء الاصطناعي. إن الاتساق الحركي المتقن ينبع دائماً من صور ثابتة محكمة، وامتلاكك لإطار مرجعي تتحكم في عناصره هو أفضل ضمان لنجاح أي مشروع لـ فيديو الذكاء الاصطناعي.