
Erstes und letztes Frame: Die Einstellung, die KI-Videos vor dem Verziehen schützt | Fanch AI
Die Steuerung über erstes und letztes Frame (first and last frame) ist die am meisten unterschätzte Funktion bei der Erstellung von KI-Videos. Die meisten Kreativen formulieren einen präzisen Prompt, generieren acht Sekunden Videomaterial und müssen feststellen, dass die Szene schleichend abdriftet: Gesichtszüge verformen sich, der Raum baut sich unbemerkt um und Lichtquellen springen willkürlich.
Das geschieht, weil Videomodelle über kein dauerhaftes Gedächtnis verfügen. Jedes Einzelbild ist eine neue Schätzung, die lediglich auf dem unmittelbar vorangegangenen Frame basiert. Kleinste Berechnungsfehler potenzieren sich, und nach acht Sekunden betrachtet man eine völlig andere Szenerie.
Die Kontrolle über erstes und letztes Frame löst dieses Problem an der Wurzel. Indem Sie festlegen, wo die Einstellung beginnt und wo sie enden muss, wird die Aufgabe des Modells von unberechenbarer Erfindung auf mathematische Bewegungsinterpolation umgestellt. Dies ist ein Leitfaden für den gezielten Einsatz von erstem und letztem Frame: technische Parameter, Kompositionsregeln, fünf praxiserprobte Rezepte und typische Fehlerquellen.
Warum KI-Videos abdriften und mutieren
Bevor wir zur Lösung kommen, muss die Fehlerursache verstanden werden.
Frames sind Schätzungen, keine dauerhaft gespeicherten Räume. Ein Text-to-Video-Modell hält keine dreidimensionale Welt im Gedächtnis. Es erzeugt jedes Einzelbild unter der weichen Bedingung, dass es logisch an das vorherige Bild anschließen sollte. Über mehrere Sekunden hinweg weicht diese weiche Bedingung unweigerlich ab.
Identitätsmerkmale zerfallen am schnellsten. Gesichter und feine Oberflächenstrukturen sind zuerst betroffen, weil sie die höchste Informationsdichte pro Pixel aufweisen – und genau hier zahlt sich ein abgestimmtes Paar aus erstem und letztem Frame am meisten aus. Ein Detailverlust von 20 Prozent an einer Betonwand fällt kaum auf; derselbe Verlust in einem Gesicht führt unmittelbar in den Uncanny-Valley-Effekt.
Kamerabewegungen verstärken das Problem. Sehr langsame Fahrten geben dem Modell Zeit, Abweichungen anzuhäufen; sehr schnelle Bewegungen zerstören Feinheiten. Ohne erstes und letztes Frame ist der visuelle Qualitätsverlust unausweichlich.
Sie können dieses Problem nicht allein durch detailliertere Prompts lösen: Der Prompt ist ein statischer Textbefehl, der Berechnungsfehler hingegen wächst dynamisch mit jedem Frame. Was Sie jedoch tun können, ist die beiden Endpunkte festzuzurren. Genau das leistet die Steuerung über erstes und letztes Frame.
Was die Steuerung über erstes und letztes Frame bewirkt
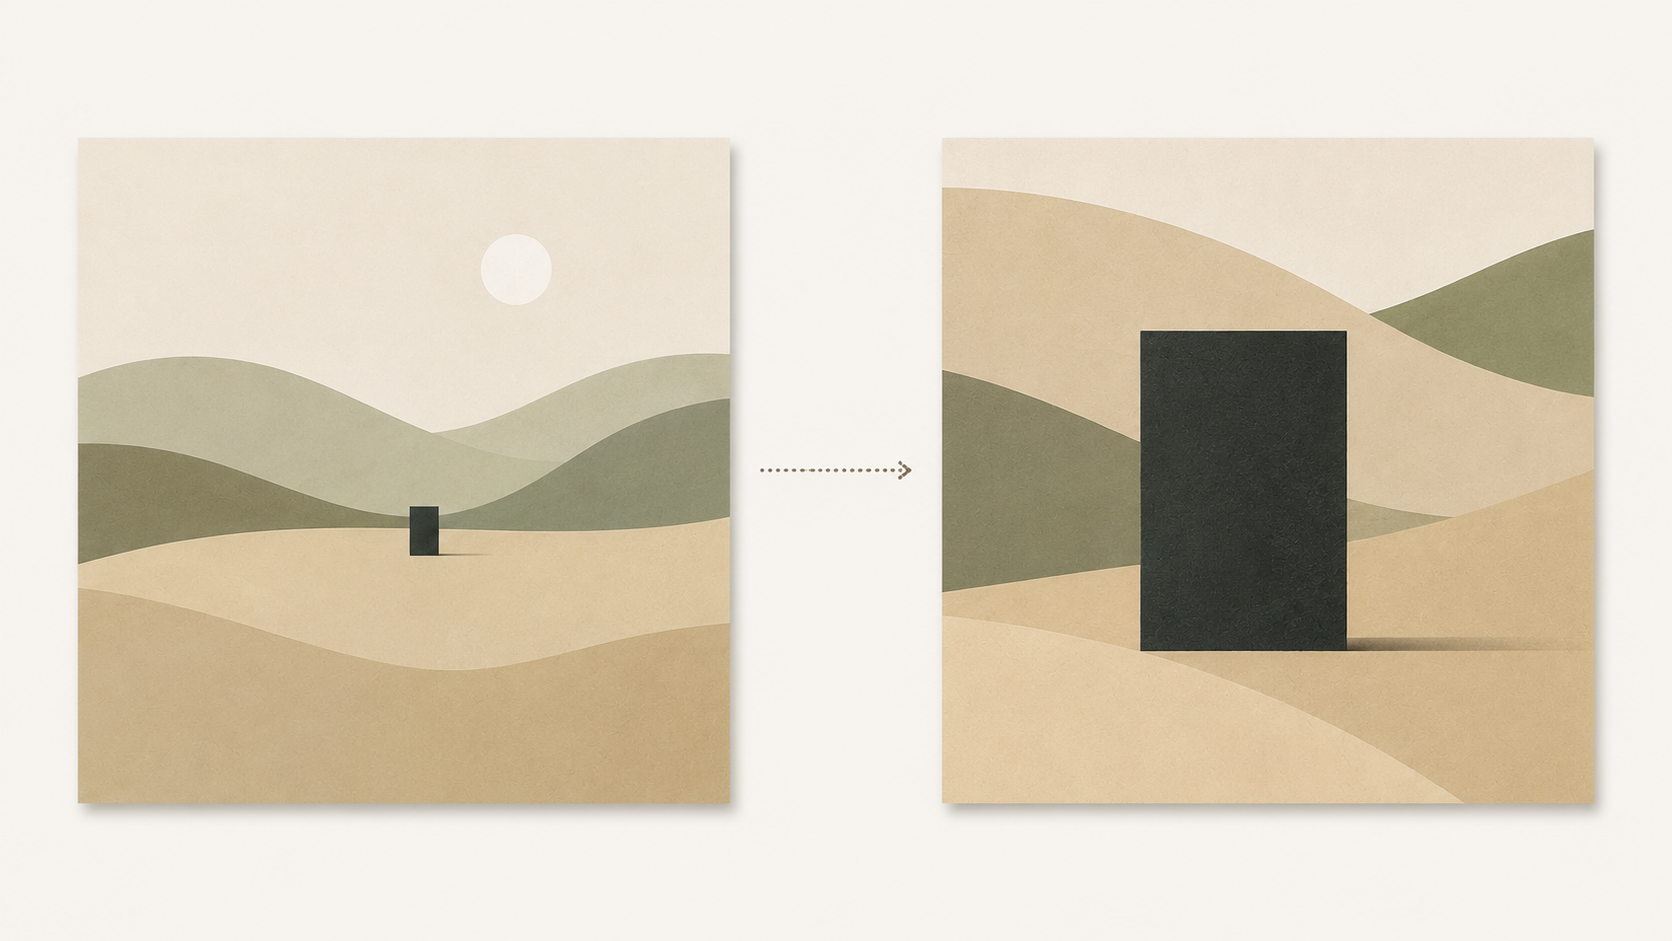
Diese Funktion nimmt zwei Referenzbilder entgegen – das Eröffnungsbild und das Abschlussbild – und errechnet den kontinuierlichen Bewegungsablauf dazwischen.
Daraus ergeben sich drei entscheidende Vorteile für die Produktionspraxis:
Sie verwandelt Erfindung in gezielte Interpolation. Ohne Endbild fragt sich das Modell kontinuierlich: „Was soll als Nächstes geschehen?“. Mit Endbild lautet die Berechnungsaufgabe: „Wie gelange ich physikalisch schlüssig von Bild A zu Bild B?“. Die zweite Frage besitzt einen klar eingegrenzten Lösungsraum, weshalb die Ergebnisse stabil bleiben.
Sie erhalten zwei feste Anker statt nur einem. Bei einem reinen Startbild laufen Fehler unbegrenzt weiter. Ein verbindliches Schlussbild zwingt das Modell zur visuellen Konvergenz: Jede zwischenzeitliche Ungenauigkeit muss rechtzeitig korrigiert werden, um das Endbild exakt zu treffen.
Sie liefert verlässliche Ergebnisse für Kundenprojekte. Kunden verlangen bestimmte Produktperspektiven zu festen Zeitpunkten. Die Vorgabe von erstem und letztem Frame garantiert diesen Zielzustand.
Was die Funktion nicht leisten kann: Sie garantiert nicht automatisch die Perfektion jedes Zwischenschritts. Sie legt die Eckpunkte fest, der genaue Bewegungspfad dazwischen wird weiterhin vom Modell berechnet.
Welche Modelle diese Funktion unterstützen
Die Unterstützung unterscheidet sich je nach Plattform und Modellversion:
Kling 4.0 unterstützt mehrere Keyframes entlang der Timeline und nimmt im Image-to-Video-Modus explizite Start- und Endbilder entgegen, ideal für komplexere Kamerafahrten.
Veo 3.1 stellt Parameter für Start- und End-Frames über die Gemini API bereit.
Seedance 2.5 unterstützt die Steuerung über erstes und letztes Frame in Kombination mit umfangreichen Referenzbildern.
Wan sowie die Videowerkzeuge von Alibabas Model Studio verarbeiten bildkonditionierte Frame-Vorgaben zuverlässig.
Versionsnummern ändern sich schnell. Das Grundprinzip bleibt: Sobald ein Werkzeug zwei Bilder für einen Clip akzeptiert, lässt sich der Workflow für erstes und letztes Frame anwenden.
Fünf Regeln für verlässliche Ausgangsbilder
Die meisten Fehlversuche scheitern lange vor dem Klick auf Generieren – nämlich bei der Wahl der beiden Referenzbilder.
1. Identische Lichtstimmung und Tageszeit. Ist das Startbild diffuses Mittagslicht und das Endbild ein dramatischer Sonnenuntergang, versucht das Modell eine unnatürliche Überblendung mitten im Clip. Stimmen Sie das Licht ab.
2. Gleiche Brennweiten-Charakteristik. Ein weiter Start und eine extreme Nahaufnahme am Ende sind absolut legitim – vorausgesetzt, Ihr Prompt gibt eine kontinuierliche Kamerafahrt (Push-in) vor. Fehlt diese Anweisung, erzeugt das Modell eine unsaubere Morphing-Verzerrung.
3. Realistische Bewegungsdistanzen einhalten. In acht Sekunden kann eine Person durch ein Zimmer gehen, aber keinen Stadtteil durchqueren. Paare aus erstem und letztem Frame mit überzogenen Distanzen quittiert das Modell mit Beschleunigungsfehlern.
4. Raum für Bewegung lassen. Nahezu identische Bilder hochzuladen ist ein typischer Anfängerfehler: Das Modell findet keinen Bewegungsraum und erzeugt ein starres, zitterndes Standbild. Beide Frames brauchen einen sichtbaren, logischen Unterschied.
5. Hochwertige Ausgangsbilder generieren. Ihre Referenzbilder müssen saubere, hochauflösende Renderings sein. Komprimierte Bildschirmfotos führen zwangsläufig zu verwaschenem Videomaterial.
5 praxiserprobte Rezepte für Keyframe-Paare
Jedes Rezept besteht aus zwei Bildern und dem dazugehörigen Bewegungsprompt. Der Prompt beschreibt ausschließlich die Dynamik, nicht die Szene – die Szenerie ist bereits durch Ihre Bilder vorgegeben.
1. Verstreichende Zeit (Time-lapse)
Bilder: Dieselbe Landschaft zur Mittagszeit und zur blauen Stunde.
Slow, steady time-lapse transition: the light across the valley shifts from warm midday to cool blue dusk, shadows lengthening and stretching as the sun drops, thin clouds drifting slowly overhead. Camera locked off, no subject movement, gentle exposure change.
2. Nahtloser Outfit-Wechsel
Bilder: Dieselbe erwachsene Person, identische Pose, zwei verschiedene Kleidungssets.
A seamless in-camera transition: the subject stands still as warm light sweeps across the frame from left to right, and the clothing resolves into the second outfit without any cut. Camera locked, only the light and the fabric change.
3. Die Kamerafahrt ins Detail (The push in)
Bilder: Totale eines Raumes, gefolgt von einer Nahaufnahme eines Objekts auf dem Tisch.
A slow, smooth dolly push from the wide position toward the detail, maintaining the same focal length, moving in a single continuous take. No zoom, no reframing, no cuts.
4. Produktpräsentation / Unboxing
Bilder: Geschlossene Verpackung, gefolgt von der geöffneten Verpackung mit sichtbarem Produkt.
A continuous product shot: the lid lifts and swings back on its hinge in one smooth motion, warm key light following the opening, soft shadow shifting across the surface. Camera slowly orbits a few degrees.
5. Die belebte Straße
Bilder: Eine leere Straße, gefolgt von derselben Straße mit einer Figur im Hintergrund.
A locked-off shot: a lone figure in a long coat walks slowly in from the far end of the street, growing from a small silhouetted shape into a clear figure, mist drifting across the frame throughout. No camera movement.
Warum Fehler trotzdem auftreten – und wie Sie gegensteuern
Wenn ein Clip trotz erstem und letztem Frame misslingt, liegt es meist an vier Ursachen:
Bilder zu ähnlich → Keine Dynamik. Weichen die Bilder kaum voneinander ab, erzeugt das Modell ein zitterndes Standbild. Lösung: Erhöhen Sie den räumlichen oder zeitlichen Abstand zwischen den Frames.
Bilder zu verschieden → Unsauberes Morphing. Fehlt den Bildern jede visuelle Schnittmenge, greift das Modell zur Überblendung, bei der sich Flächen auflösen. Lösung: Gleichen Sie Bildausschnitt und Beleuchtung an.
Der Prompt beschreibt eine dritte Szene. Der häufigste Fehler. Beschreiben Sie im Prompt keine Möbel oder Personen erneut; diese Informationen sind bereits in den Bildern vorhanden. Lösung: Beschreiben Sie ausschließlich die Veränderung.
Clip-Dauer zu kurz für die Bewegung. Große räumliche Distanzen in vier Sekunden zu quetschen, wirkt wie ein harter Bildsprung. Lösung: Geben Sie der Bewegung mindestens acht bis zehn Sekunden Zeit.
Die Schreibregel für den Zwischenprompt
Die Grundregel lautet: Verben beschreiben, nicht Substantive.
Wenn Sie erstes und letztes Frame einsetzen, definieren Ihre beiden Bilder bereits das Wer, Was, Wo und Wann. Ihr Textprompt muss lediglich das Wie klären: Kamerabewegung, Richtung und Geschwindigkeit der Veränderung sowie ruhende Elemente.
Deshalb sind die obigen Rezepte nur halb so lang wie gewöhnliche Prompts. Die Bildpaare übernehmen die Strukturarbeit; überladene Textprompts arbeiten gegen die optischen Vorgaben.
Ein Prompt zur Vorbereitung Ihrer Ausgangsbilder
Ausgangsbilder mit sauberer Lichtführung machen jede Generierung verlässlicher. Erzeugen Sie Ihre Frames mit einem präzise steuerbaren Modell:
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
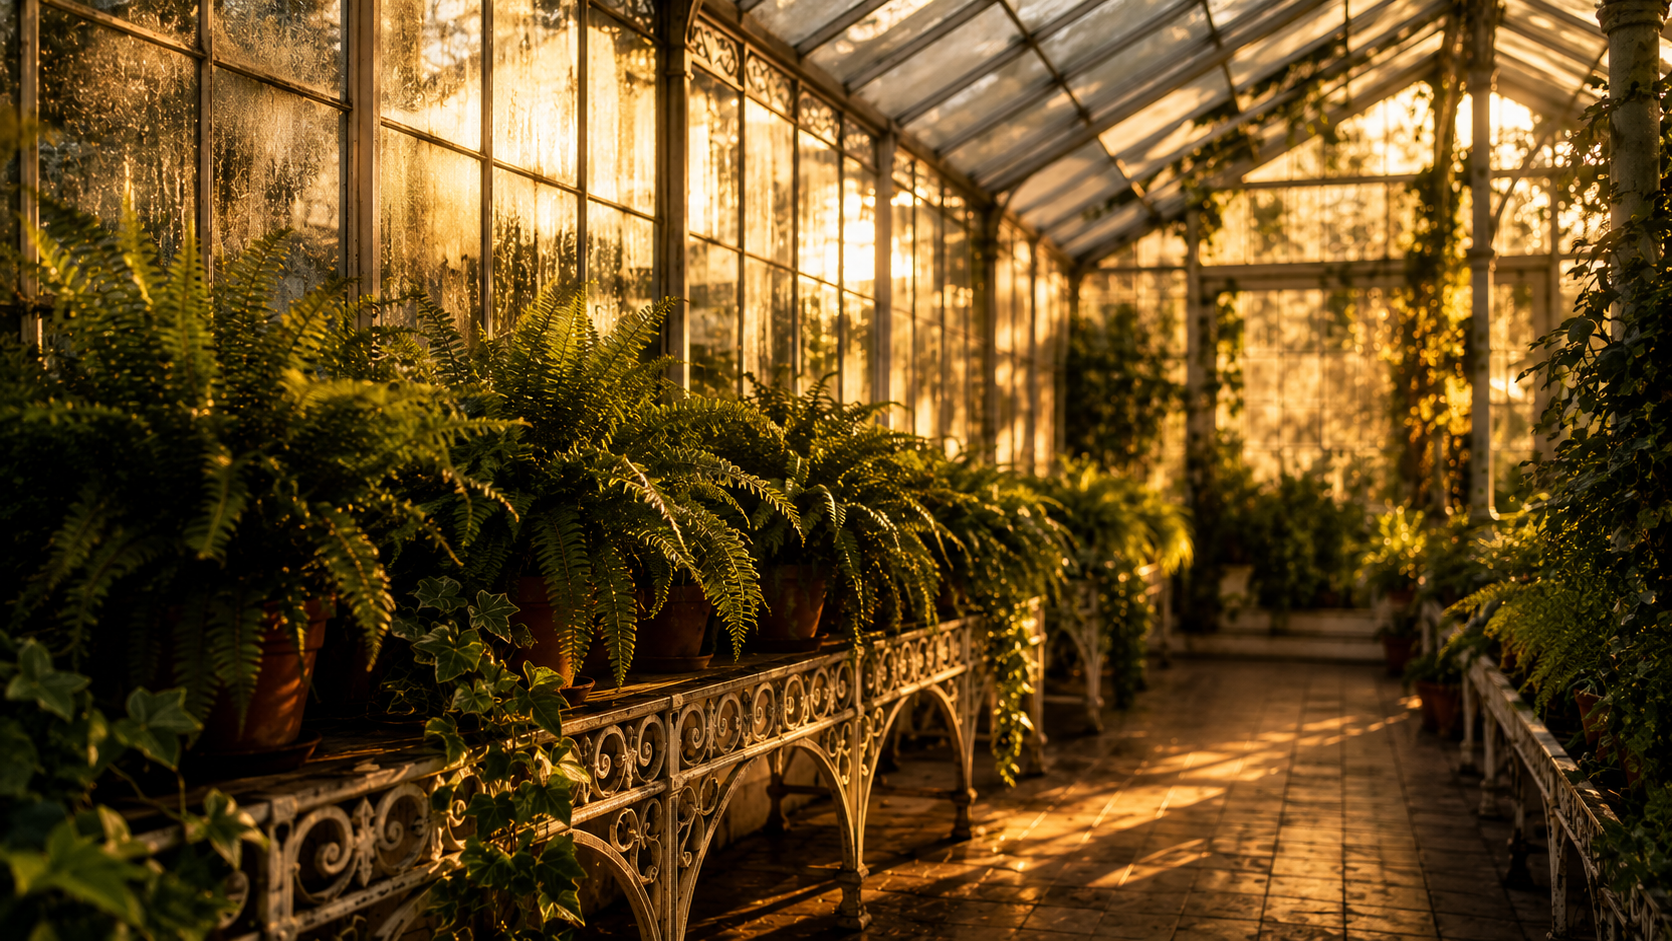
A cinematic still of a glass greenhouse interior at golden hour: long rows of potted ferns and trailing ivy on white iron benches, warm sunlight streaming through dusty glass panes and casting long diagonal shadows across a tiled floor, faint condensation on the windows. Rich green foliage against warm amber light, fine texture in the leaves and glass, shallow depth of field, 16:9 framing, 8K detail, no text overlay.
Generieren Sie dieses Bild zweimal auf Fanch AI: einmal im warmen Spätnachmittagslicht („golden hour“) und einmal mit angepasstem Prompt in der Abenddämmerung („dusk“). Damit haben Sie das ideale Bildpaar für Rezept 1 zur Hand.
Warum Fanch AI Ihren Workflow vereinfacht
Ein Video mit erstem und letztem Frame ist nur so stabil wie die beiden Ausgangsbilder, mit denen Sie arbeiten. Fanch AI bietet Ihnen ein spezialisiertes Bildmodell, das detaillierte Vorgaben präzise umsetzt. So generieren Sie konsistente Bildpaare – gleiche Optik, abgestimmtes Licht, eine gezielte Veränderung – und übergeben diese als verlässliche Basis an Ihr bevorzugtes Videomodell.
👉 Jetzt starten: Erstellen Sie Ihr Video mit Veo 3.1 auf Fanch AI.