
FLUX 3 Klein auf Blackwell: Was die 4,45-fache Geschwindigkeit wirklich bedeutet | Fanch AI
Im Entwickler-Blog von NVIDIA ist ein Beitrag mit dem Titel „Speed Up Image Generation with FLUX 3 Image Klein on NVIDIA Blackwell GPUs“ erschienen. Die Zahl, die seither die Runde macht, lautet: bis zu 4,45-mal schneller. Ein genauer Blick auf die Benchmark-Daten zeigt jedoch, dass diese Messung auf einer einzelnen B200-GPU und spezifisch bei der Bildbearbeitung (Inpainting/Editing) erzielt wurde.
Diese beiden Randbedingungen wiegen schwerer als der reine Multiplikator. NVFP4 ist der technische Hebel hinter diesem Geschwindigkeitssprung. Wer versteht, wie dieses Format aufgebaut ist, erkennt schnell, warum der Spitzenwert zwar auf Rechenzentrumshardware gemessen wurde, die zugrunde liegende Methode aber direkte Relevanz für den eigenen Arbeitsplatz hat.
Was NVIDIA tatsächlich gemessen hat
Drei Fakten zur Einordnung der Benchmark-Werte:
Es handelt sich um einen herstellereigenen Benchmark. Der Test lief auf der Blackwell-Architektur mit einem von NVIDIA für Blackwell maßgeschneiderten Quantisierungsformat und auf einem von NVIDIA optimierten Modell. Das macht die Ergebnisse nicht falsch – es kennzeichnet sie als Best-Case-Szenario unter vollständiger Kontrolle aller Systemparameter durch den Hersteller.
Getestet wurde auf einer B200. Das ist eine GPU für Rechenzentren. Es handelt sich weder um eine RTX 4070 noch um eine 5080 und auch nicht um eine Grafikkarte, wie man sie in einer Desktop-Workstation vorfindet.
Gemessen wurde Bildbearbeitung, nicht Neuerstellung. Der Wert 4,45x bezieht sich auf den Bearbeitungspfad von FLUX 3. Das Editieren von Bildteilen und die vollständige Text-zu-Bild-Generierung beanspruchen Rechenressourcen unterschiedlich; derselbe Faktor lässt sich nicht pauschal auf beide Workflows übertragen.
Die nüchterne Quintessenz lautet: NVFP4 beschleunigt die Bildbearbeitung mit FLUX 3 Klein auf NVIDIAs Spitzenhardware drastisch. Was dieser Fortschritt für professionelle Anwender bedeutet, analysiert dieser Beitrag.
Was NVFP4 technisch ausmacht
NVFP4 bezeichnet NVIDIAs 4-Bit-Gleitkommaformat für die Blackwell-Generation. Die Namensgebung ist technisch präzise: FP4 steht für vier Bit Speicherplatz pro Modellgewicht, während das Präfix NV die herstellerspezifische Implementierung kennzeichnet.
Vier Bit pro Gewicht bedeuten eine massive Kompression. Ein Standardmodell in bf16 beansprucht 16 Bit pro Gewicht. NVFP4 senkt den Speicherbedarf somit bereits vor jeder weiteren Optimierung auf ein Viertel. Hier liegt der Ursprung des Geschwindigkeitsgewinns.
Zwei architektonische Details machen NVFP4 in der Praxis überhaupt erst nutzbar, statt bloß Daten einzusparen:
Blockweises Skalieren (Block-wise scaling). Wer Gewichte schlicht auf 4 Bit staucht, zerstört die logische Struktur des Modells, da ein einzelner Skalierungsfaktor über einen gesamten Tensor hinweg Werteunterschiede über mehrere Größenordnungen nicht abbilden kann. NVFP4 speichert Skalierungsfaktoren pro Gewichtsblock ab. Jeder kleine Teilbereich erhält seine eigene Skala. Das markiert den Unterschied zwischen funktionierender 4-Bit-Präzision und unbrauchbarem Bildrauschen.
Native Hardware-Unterstützung. NVFP4 ist tief in den Rechenkernen von Blackwell verankert. Das dämpft zugleich verfrühte Erwartungen: Das Format arbeitet nur deshalb so schnell, weil der Chip über dedizierte physische Recheneinheiten dafür verfügt – Einheiten, die älteren GPU-Generationen fehlen.
Die Quantisierungs-Leiter (The Quantization Ladder)
NVFP4 steht nicht für sich allein, sondern markiert die unterste Sprosse einer methodischen Leiter. In der Open-Source-Community existieren bereits etliche Builds von FLUX 3 Klein: von NVFP4 über FP8 bis hin zu Mischkonfigurationen wie W4A16 und W4A4.
Das leistet und kostet jede einzelne Stufe:
bf16 — Volle Präzision. Der Referenzstandard, an dem sich alle NVFP4-Varianten messen lassen müssen. Bietet jedes Detail, das das Modell errechnen kann, bei maximalem VRAM-Bedarf und geringster Geschwindigkeit.
FP8 — 8-Bit. Belegt rund die Hälfte des VRAMs von bf16 bei Qualitätsverlusten, die im normalen Betrachtungsabstand praktisch unsichtbar bleiben. Die verlässlichste Zwischenstufe und der empfohlene Standard vor jedem Schritt in Richtung NVFP4.
NVFP4 — 4-Bit. Rund ein Viertel des Speicherbedarfs von bf16. Hier entstehen die massiven Durchsatz- und Speichergewinne, hier wird aber auch eine sorgfältige Qualitätsprüfung unumgänglich.
W4A16 — 4-Bit-Gewichte, 16-Bit-Aktivierungen. Die Gewichte sind stark komprimiert, die Aktivierungsdaten bleiben weitgehend unangetastet. Ein praxiserprobter Kompromiss, der Bilddetails oft deutlich besser bewahrt als eine vollständige 4-Bit-Kompression.
W4A4 — Durchgehend 4-Bit. Maximale Kompression bei höchstem Fehlerrisiko. Nur dann sinnvoll, wenn der verfügbare Grafikspeicher keinen anderen Weg erlaubt.
Das Grundprinzip lautet: Kompression ist keine Alles-oder-Nichts-Entscheidung. Die Präzision der Modellgewichte und die der Aktivierungen sind getrennte Stellschrauben. Mischformate existieren genau deshalb, weil die Reduzierung der einen Achse die Bildqualität weit weniger beschädigt als die Reduzierung beider Achsen gleichzeitig.
Warum diese Leiter existiert
Diesen Aspekt klammern viele Erklärungen zur Modellquantisierung aus, obwohl er begründet, warum NVFP4 einen Durchbruch um den Faktor 4 liefert statt nur marginale Prozentpunkte:
Diffusionsmodelle zur Bildgenerierung sind in der Regel durch die Speicherbandbreite limitiert (Memory-bandwidth bound), nicht durch die reine Rechenleistung (Compute bound). Ein Bild zu berechnen bedeutet, gigantische Gewichtstensoren dutzende Male während der Denoising-Schritte durch die Recheneinheiten zu schleusen. Nicht das Addieren und Multiplizieren bremst das System, sondern das permanente Hin- und Hertransportieren der Daten.
Das rückt Optimierung in ein anderes Licht: Wer ständig auf den Speichertransfer wartet, profitiert unmittelbar davon, wenn NVFP4 die Datenmenge auf ein Viertel eindampft. Der Grafikchip rechnet nicht plötzlich schneller – er verbringt schlicht deutlich weniger Zeit mit dem Warten auf Eingabedaten.
Aus diesem Grund schlägt Quantisierung bei der lokalen Bildgenerierung oft jede Code-Optimierung: Sie greift genau dort an, wo der eigentliche Engpass liegt.
Die qualitativen Einbußen von NVFP4
NVFP4 arbeitet verlustbehaftet, und diese Einbußen verteilen sich nicht gleichmäßig über das Bild, sondern treten an klar definierbaren Stellen zutage:
Feine Hochfrequenz-Texturen. Stoffmaschen, Haarsträhnen, feines Filmkorn, Hautporen. Hier zeigt sich 4-Bit-Kompression zuerst, da Nuancen mit geringer Signalamplitude bei der Rundung mathematisch verloren gehen.
Kleine Schriften. Buchstaben in kleinen Schriftgraden erfordern exakte Kantenpräzision. Was unter FP8 noch lesbar bleibt, neigt unter NVFP4 zum Verschwimmen.
Subtile Farbverläufe. Weiche Übergänge am Himmel oder sanfte Schattierungen auf der Haut können Tonwertabrisse (Banding) zeigen, wenn der Dynamikumfang beschnitten wird.
Was stabil erhalten bleibt. Bildkomposition, Farbwelten, markante Umrisse und die Gesamtausleuchtung. Das grobe Bildgerüst benötigt keine 16-Bit-Präzision; feinste Texturen schon. Ein mit NVFP4 generiertes Bild wirkt daher auf den ersten Blick oft makellos, offenbart seine Kompressionsspuren aber bei 100-Prozent-Ansicht.
Die Diskrepanz zwischen Datacenter und Schreibtisch
Der wichtigste Vorbehalt gegenüber dem Multiplikator 4,45x: Er lässt sich nicht eins zu eins auf Standard-PCs übertragen.
Blackwell ist Hardware-Voraussetzung. NVFP4 ist tief in der Hardware verwurzelt. Auf älteren GPU-Generationen wie Ada Lovelace (RTX 40er-Serie) lassen sich zwar quantisierte Modelle betreiben, der volle Performancegewinn bleibt jedoch aus, weil die physischen Rechenwerke dafür im Chip fehlen.
Die Messung erfolgte auf einer B200. Eine Rechenzentrums-GPU verfügt über Speicherbandbreiten, die Consumer-Karten bei weitem übersteigen. Die technische Wirkungsrichtung ist dieselbe, das Ausmaß der Beschleunigung nicht.
Consumer-Setups folgen anderen Gesetzen. Berichte über FLUX 3 Klein auf 8-GB-Grafikkarten beziehen sich auf das Basismodell mit reduzierter Bitbreite – das ist eine beachtliche Leistung der Community, aber etwas fundamental anderes als der 4,45-fache Durchsatz auf einer B200.
Sehen Sie diesen Benchmark als klaren Fingerzeig auf künftige Architekturen, nicht als Leistungsgarantie für Ihren heutigen PC.
So wählen Sie die passende Präzisionsstufe
Gehen Sie pragmatisch von Ihrem dominierenden Hardware-Engpass aus:
Wenn der VRAM limitiert (das Modell passt nicht in den Speicher): Gehen Sie auf NVFP4 oder ein W4A16-Build herunter und akzeptieren Sie minimale Textureinbußen. Ein lauffähiges Modell schlägt jedes Speicherüberlauf-Problem (OOM).
Wenn VRAM vorhanden ist, aber Tempo fehlt: Starten Sie mit FP8. Es bietet auf den meisten aktuellen Karten den besten Kompromiss aus Renderqualität und Durchsatz bei minimalem Ausfallrisiko.
Wenn kompromisslose Bildqualität geliefert werden muss: Rendern Sie finale Ergebnisse in bf16 und nutzen Sie NVFP4 zum schnellen Ausprobieren von Bildideen. Diese Aufteilung ist der wirtschaftlichste Einsatz von Quantisierung: günstiges Testen, makelloses Finalisieren.
Auf GPUs vor der Blackwell-Generation: Setzen Sie auf FP8 oder GGUF-Versionen. Die hardwareseitigen Effizienzvorteile von NVFP4 lassen sich auf älteren Karten nicht per Software herbeizaubern.
Vier Tests vor dem Produktiveinsatz
Prüfen Sie quantisierte Modelle an Ihren eigenen Motiven:
Ein Motiv mit dichter Oberflächentextur. Strickstoff, dichtes Laub oder offenes Haar machen Detailverluste von NVFP4 wesentlich schneller sichtbar als ein Porträt.
Ein Bild mit kleiner Typografie. Nutzen Sie Beschriftungen auf Etiketten statt plakativer Headlines.
Ein Bild mit weichen Tonwertverläufen. Prüfen Sie Himmelsansichten oder neutrale Studiohintergründe auf sichtbare Stufenbildung.
Vergleich bei gleichem Prompt und Seed. Vergleichen Sie die Ausgaben von bf16 und der quantisierten Stufe bei 100 Prozent und anschließend in der tatsächlichen Zielauflösung. Erkennen Sie im Zielformat keinen Unterschied mehr, ist die gewählte Präzision für Ihren Einsatzzweck freigegeben.
Ein Prompt für den Härtetest
Um die Grenzen der Quantisierung sichtbar zu machen, fordern Sie das Modell bei feinen Gewebestrukturen heraus:
Kopieren und bei Fanch AI einfügen (Modell: gpt_image_2):
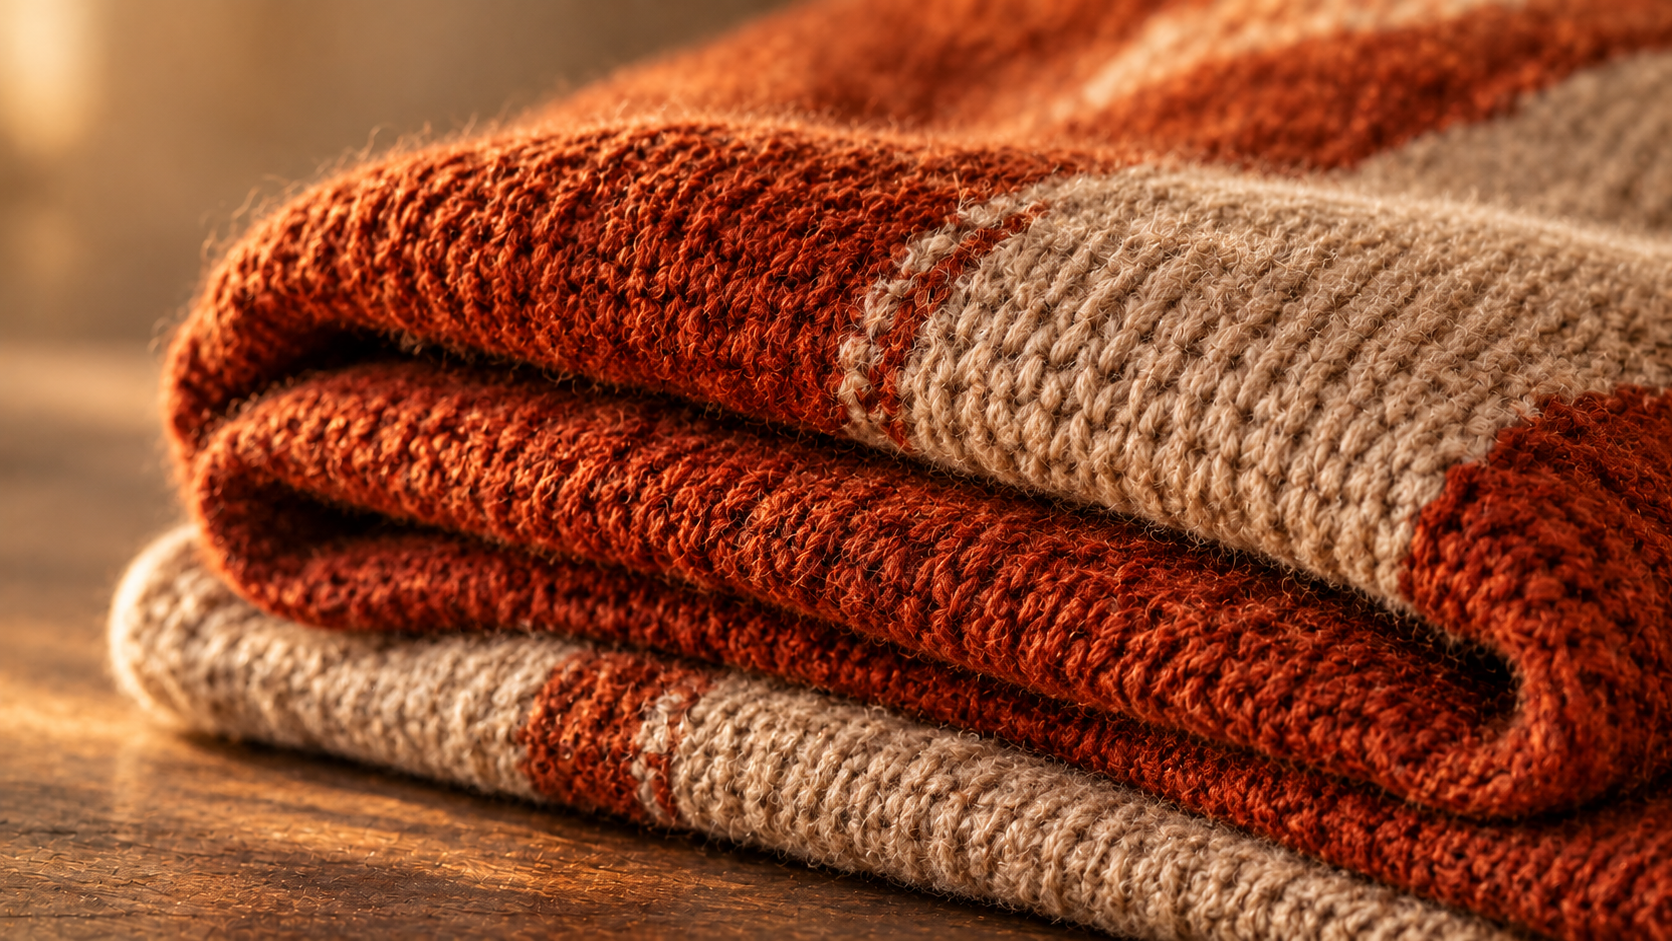
A macro editorial photograph of a folded hand-knit woollen blanket in deep rust and oatmeal tones, stacked in soft uneven layers: individual yarn fibres and small stitches clearly resolved, a few loose fibres catching a low warm side light, subtle fuzz along the folded edges. Extremely fine detail in the knit structure, warm muted palette, shallow depth of field falling off at the frame edges, 16:9 framing, 8K detail, no people, no text overlay.
Rendern Sie dieses Motiv mit der gewünschten Präzision und begutachten Sie die Maschen. Verschwimmen die Wollfäden zu matschigen Flächen, haben Sie die Belastungsgrenze Ihres Setups erreicht.
Warum Fanch AI Ihren Workflow unterstützt
Sowohl NVFP4 als auch die verschiedenen Quantisierungsstufen verfolgen ein Ziel: Bildgenerierung effizienter und günstiger zu machen – bezogen auf VRAM, Renderzeit und Kosten pro Iteration. Dahinter steht das Grundbedürfnis jedes Kreativen: Entwürfe ohne finanzielle Hürden auszuprobieren, bis die perfekte Komposition steht.
Fanch AI stellt Ihnen ein spezialisiertes Bildmodell bereit, das Sie über präzise Prompts steuern können. So erarbeiten Sie Bildaufbau, Licht und Farbwelt ohne eigene Hardware-Zwänge – und nutzen das fertige Referenzbild anschließend in der Rendering-Pipeline Ihrer Wahl.
👉 Jetzt starten: Erstellen Sie Bilder mit FLUX-Modellen auf Fanch AI.