
FLUX 3 Klein en Blackwell: Qué significa realmente la aceleración de 4,45x | Fanch AI
El blog para desarrolladores de NVIDIA publicó un artículo titulado "Acelera la generación de imágenes con FLUX 3 Image Klein en GPU NVIDIA Blackwell", acompañado de una cifra que no ha tardado en viralizarse: hasta 4,45 veces más rápido. Al revisar los detalles del benchmark, se observa que la medición se realizó en una única GPU B200 y, específicamente, sobre tareas de edición de imagen.
Ambos condicionantes son mucho más reveladores que el multiplicador en sí. NVFP4 es el mecanismo técnico detrás de esta aceleración, y comprender su funcionamiento explica por qué la cifra titular pertenece a centros de datos empresariales, mientras que la técnica que representa terminará llegando a tu propio escritorio.
Qué midió NVIDIA en realidad
Antes de extraer conclusiones, conviene fijar tres hechos objetivos sobre la prueba:
Es una comparativa de NVIDIA sobre hardware de NVIDIA. El test se ejecuta en Blackwell, utiliza un formato de cuantización diseñado por NVIDIA para Blackwell y corre sobre un modelo optimizado directamente por la compañía. Esto no invalida el dato, pero lo sitúa en el escenario más favorable posible (best case), medido por quien tiene el control absoluto de la configuración.
Se midió en una única B200. Hablamos de una GPU de centro de datos. No es una RTX 4070, ni una 5080, ni la tarjeta instalada en una estación de trabajo bajo un escritorio.
Se midió en tareas de edición, no de generación desde cero. La cifra de 4,45x se registró en el pipeline de edición (inpainting) de FLUX 3. La edición y la generación pura poseen perfiles de cómputo distintos; no hay base para asumir que un mismo multiplicador sirva para ambos procesos.
Por tanto, el resumen objetivo es este: NVFP4 permite que la arquitectura Blackwell acelere de forma drástica la edición con FLUX 3 Klein en la cúspide de la gama de hardware de NVIDIA. Todo lo que sigue analiza qué implica esto para el usuario profesional convencional.
Qué es exactamente NVFP4
NVFP4 es el formato de punto flotante de 4 bits de NVIDIA para la generación Blackwell. La nomenclatura es transparente: FP4 indica que cada peso se almacena en cuatro bits, y el prefijo NV señala que se trata de la variante propietaria de NVIDIA.
Cuatro bits por peso supone una compresión agresiva. Un modelo en precisión estándar bf16 emplea dieciséis bits por peso, de modo que NVFP4 reduce la huella de memoria a una cuarta parte antes de aplicar cualquier otra optimización. Ahí nace la ganancia de velocidad y esa es la razón de ser del formato.
Dos decisiones de diseño hacen que NVFP4 sea utilizable y no un mero archivo comprimido inservible:
Escalado por bloques (Block-wise scaling). Reducir ingenuamente cada peso a 4 bits destruye la capacidad del modelo, ya que un factor de escala único por tensor no puede representar valores que varían en varios órdenes de magnitud. NVFP4 aplica factores de escala por bloques de pesos, asignando a cada pequeño grupo su propia escala. Esa es la diferencia entre un formato de 4 bits funcional y uno que solo genera ruido visual.
Soporte de silicio nativo. NVFP4 está integrado directamente en la microarquitectura de Blackwell. Aquí reside la limitación técnica: el formato es eficiente porque el silicio lo procesa por hardware, algo que las generaciones anteriores de GPU no pueden hacer.
La escalera de la cuantización (The Quantization Ladder)
NVFP4 no es una opción aislada, sino el peldaño inferior de una escalera técnica. La comunidad de código abierto ya ha publicado múltiples variantes de FLUX 3 Klein a lo largo de este espectro: existen repositorios para NVFP4, FP8 y esquemas híbridos etiquetados como W4A16 y W4A4.
Esto es lo que ofrece y cuesta cada peldaño:
bf16 — Precisión completa. La referencia absoluta frente a la que se evalúan las versiones NVFP4. Mantiene intacto cada detalle que el modelo es capaz de renderizar. Presenta el mayor consumo de VRAM y la menor velocidad.
FP8 — 8 bits. Ocupa aproximadamente la mitad de memoria que bf16, con una pérdida de calidad que suele resultar imperceptible a simple vista. Es el paso descendente más seguro y el valor por defecto recomendado antes de saltar a NVFP4.
NVFP4 — 4 bits. Reduce la huella a una cuarta parte respecto a bf16. Aquí residen los saltos drásticos de velocidad y memoria, pero exige una verificación visual exhaustiva.
W4A16 — Pesos en 4 bits, activaciones en 16 bits. Comprime al máximo los pesos mientras preserva la precisión de las activaciones. Es un compromiso muy habitual que suele retener la calidad mejor que comprimir toda la red por igual.
W4A4 — Ambos parámetros en 4 bits. Máxima compresión y máximo riesgo de degradación visual. Solo merece la pena si la memoria VRAM es un obstáculo insalvable; no es el punto de partida ideal.
El principio operativo es claro: la compresión no es una decisión binaria. La precisión de los pesos y la de las activaciones son ejes independientes, y los formatos híbridos existen precisamente porque comprimir una parte penaliza menos la calidad que comprimir ambas a la vez.
Por qué existe esta escalera técnica
Este es el aspecto técnico que la mayoría de análisis omite, y es la razón por la que NVFP4 ofrece un salto cercano a 4x en lugar de una mejora testimonial.
Los modelos de difusión de imagen suelen estar limitados por el ancho de banda de memoria (Memory-bandwidth bound), no por la capacidad bruta de cómputo. Generar una imagen implica transferir tensores gigantescos a través del procesador decenas de veces a lo largo de los pasos de denoising. La aritmética en sí no es el cuello de botella; mover los pesos de un lado a otro sí lo es.
Esto redefine el concepto de optimización: si la GPU pasa gran parte del tiempo esperando la llegada de datos desde la memoria, la reducción a una cuarta parte que aporta NVFP4 ataca directamente el cuello de botella real. La GPU no realiza los cálculos mágicamente más rápido: simplemente pasa mucho menos tiempo inactiva esperando datos.
Por eso, en la generación local de imágenes, la cuantización supera a los cambios de arquitectura: resuelve la limitación física que realmente frena el proceso.
El coste de NVFP4 en la calidad visual
NVFP4 conlleva pérdidas de información, y esa degradación no se distribuye de manera uniforme por la imagen, sino que se concentra en áreas muy concretas:
Texturas finas de alta frecuencia. Tramas de tejidos, cabello, grano analógico y poros de la piel. La compresión a 4 bits se hace visible primero en las microtexturas, ya que los detalles de baja amplitud quedan eliminados en el redondeo matemático.
Texto en cuerpos pequeños. La renderización de letras a escala reducida exige una precisión matemática milimétrica. Es habitual perder legibilidad en NVFP4 en situaciones donde FP8 conserva la tipografía nítida.
Gradientes sutiles. Las transiciones tonales suaves en cielos o pieles pueden mostrar ligeras bandas (banding) cuando el rango dinámico se comprime en exceso.
Lo que se conserva intacto. Composición, paleta cromática, grandes volúmenes y la iluminación global. La estructura no necesita tanta precisión; el detalle fino sí. Por ello, una imagen generada con NVFP4 puede parecer impecable a primera vista y revelar sus costuras en cuanto se aplica zoom al 100%.
La distancia entre el centro de datos y el escritorio
La advertencia indispensable sobre la cifra de 4,45x es que no es directamente extrapolable a tu equipo personal:
Exige hardware Blackwell. NVFP4 es un formato soportado de forma nativa en silicio. En arquitecturas anteriores como Ada Lovelace (RTX serie 40) es posible ejecutar modelos cuantizados, pero no se obtendrán estos rendimientos porque la GPU carece de los núcleos físicos diseñados para procesar esta instrucción.
Se midió en una B200. Una tarjeta de centro de datos ofrece un ancho de banda y una memoria que no existen en el mercado de consumo. La tendencia tecnológica se mantiene; la magnitud numérica, no.
El ecosistema de consumo tiene otros tiempos. Ya existen implementaciones comunitarias para ejecutar FLUX 3 Klein en tarjetas de 8GB reduciendo la precisión, lo que representa un logro notable, pero responde a un escenario técnico muy diferente al 4,45x de una B200.
Interpreta este benchmark como una confirmación de hacia dónde se dirige la industria, no como una promesa literal para tu ordenador actual.
Cómo elegir la precisión adecuada
Toma la decisión partiendo de la limitación física que condicione tu flujo de trabajo:
Si tu cuello de botella es la VRAM (el modelo no cabe en memoria), baja a NVFP4 o a una compilación W4A16 y asume la pérdida de microtextura. Un modelo funcional siempre es preferible a un error de memoria (OOM).
Si tienes memoria de sobra pero buscas acelerar el proceso, empieza en FP8. Ofrece la mejor relación calidad-velocidad en la mayoría de tarjetas y es la opción más segura.
Si el objetivo es la entrega final a un cliente, genera en bf16 para el arte definitivo y recurre a NVFP4 para la fase previa de bocetado e iteración. Esta división es el uso más rentable de la cuantización: iteración barata, acabado de máxima resolución.
Si utilizas hardware anterior a Blackwell, tu camino realista pasa por FP8 o formatos GGUF. El soporte nativo de NVFP4 no es una opción de software que se pueda activar mediante un parche.
Cuatro comprobaciones antes de adoptar un modelo cuantizado
Evalúa estos cuatro aspectos con tus propias imágenes de prueba:
Un sujeto con textura dominante. Un tejido de punto, follaje denso o cabello suelto. Esto revela los artefactos de NVFP4 mucho antes que un retrato estándar.
Una imagen con tipografía pequeña. Texto secundario o etiquetas, no un titular grande.
Un degradado suave. Un cielo limpio o un fondo de estudio liso, buscando posibles bandas de color.
Mismo prompt y misma semilla (seed) frente a frente. Compara la salida bf16 contra la versión cuantizada al 100% de escala. Luego compáralas al tamaño real en el que publicarás la imagen. Si a ese tamaño final no aprecias diferencias, la precisión elegida es perfectamente válida para tu producción.
Un prompt para poner a prueba la cuantización
Si vas a comprobar el impacto de la cuantización, hazlo sobre texturas complejas: es ahí donde se marcan las diferencias técnicas.
Copia y pega esto en Fanch AI (Modelo: gpt_image_2):
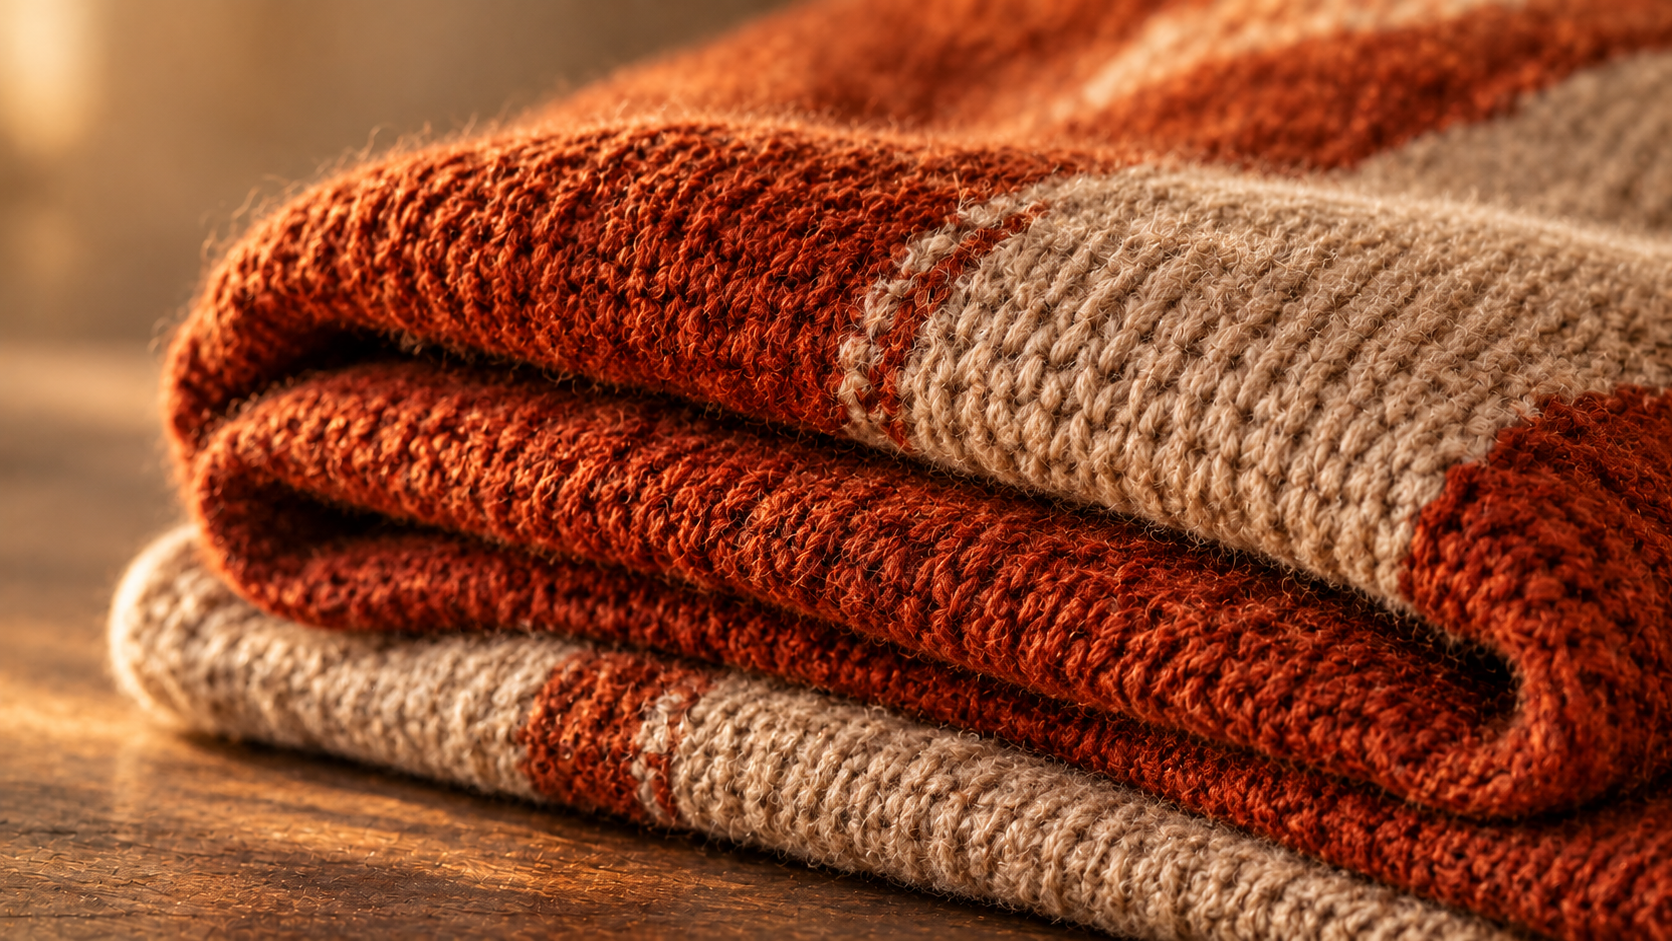
A macro editorial photograph of a folded hand-knit woollen blanket in deep rust and oatmeal tones, stacked in soft uneven layers: individual yarn fibres and small stitches clearly resolved, a few loose fibres catching a low warm side light, subtle fuzz along the folded edges. Extremely fine detail in the knit structure, warm muted palette, shallow depth of field falling off at the frame edges, 16:9 framing, 8K detail, no people, no text overlay.
Renderiza este encuadre en la precisión elegida y comprueba la definición de las puntadas. Si el tejido pierde definición y se empasta, habrás localizado el límite operativo de NVFP4.
Por qué Fanch AI encaja en tu flujo de trabajo
Tanto NVFP4 como la escalera de cuantización persiguen el mismo objetivo: hacer que generar imágenes sea más accesible y económico en memoria, tiempo y coste por intento. Se trata, en el fondo, de permitirte explorar tantas opciones como necesites hasta dar con el fotograma perfecto.
Fanch AI pone a tu alcance modelos de imagen avanzados que puedes dirigir con prompts de alta precisión, resolviendo la composición, la luz y el color sin necesidad de gestionar la infraestructura de hardware, para luego trasladar ese marco de referencia a cualquier flujo de producción local o en la nube que decidas utilizar.