
Première et dernière image : Le réglage indispensable pour stabiliser vos vidéos IA | Fanch AI
Le contrôle de la première et dernière image (first and last frame) est sans conteste le réglage le plus sous-exploité de toute la vidéo générative par IA. La plupart des créateurs rédigent un prompt soigné, lancent une génération de huit secondes, et constatent avec dépit que le plan dérive insidieusement : les traits du visage se déforment, la pièce change de configuration et la lumière bouge sans aucune cohérence physique.
Cette dérive s'explique simplement : un modèle vidéo ne possède aucune mémoire à long terme. Chaque image intermédiaire n'est qu'une déduction probabiliste conditionnée uniquement par l'image précédente. Les micro-erreurs s'additionnent, et dès la huitième seconde, vous contemplez un décor radicalement différent du point de départ.
Le réglage de première et dernière image résout ce problème à la racine. En imposant précisément le point de départ et le point d'arrivée de la prise de vue, vous contraignez le modèle à un travail d'interpolation de mouvement plutôt que d'invention pure. Voici le guide pratique pour maîtriser ce contrôle : principes de cadrage, cinq recettes prêtes à l'emploi et analyse des pièges à éviter.
Pourquoi la vidéo IA dérive-t-elle inévitablement ?
Avant de corriger le problème, il convient de comprendre la mécanique de rupture.
Les images sont des suppositions, pas des souvenirs stockés. Un modèle text-to-video ne conserve aucun espace tridimensionnel en mémoire. Il synthétise chaque image en respectant la contrainte souple selon laquelle elle doit s'enchaîner avec la précédente. Sur un plan de plusieurs secondes, cette contrainte trop lâche finit par dériver.
L'identité graphique se désagrège en premier. Les visages et les textures complexes sont les premières victimes de cette dérive, car ils concentrent la densité d'information par pixel la plus élevée. Une perte de fidélité de 20 % sur un mur en béton passe inaperçue ; cette même altération sur un visage humain bascule instantanément dans l'étrange et l'inutilisable.
Le mouvement de caméra peut masquer ou amplifier le phénomène. Un travelling trop lent laisse le temps aux artefacts de s'accumuler ; un mouvement trop violent détruit les détails. Dans les deux cas, le plan dérive dès lors que vous ne cadrez pas les deux extrémités.
Aucune astuce de prompt ne permet de contourner totalement cette réalité : le prompt est une consigne fixe, tandis que l'erreur algorithmique est cumulative. En revanche, vous pouvez verrouiller les deux bornes temporelles de la séquence : c'est la raison d'être de la première et dernière image.
Ce que réalise concrètement le contrôle des deux images clés
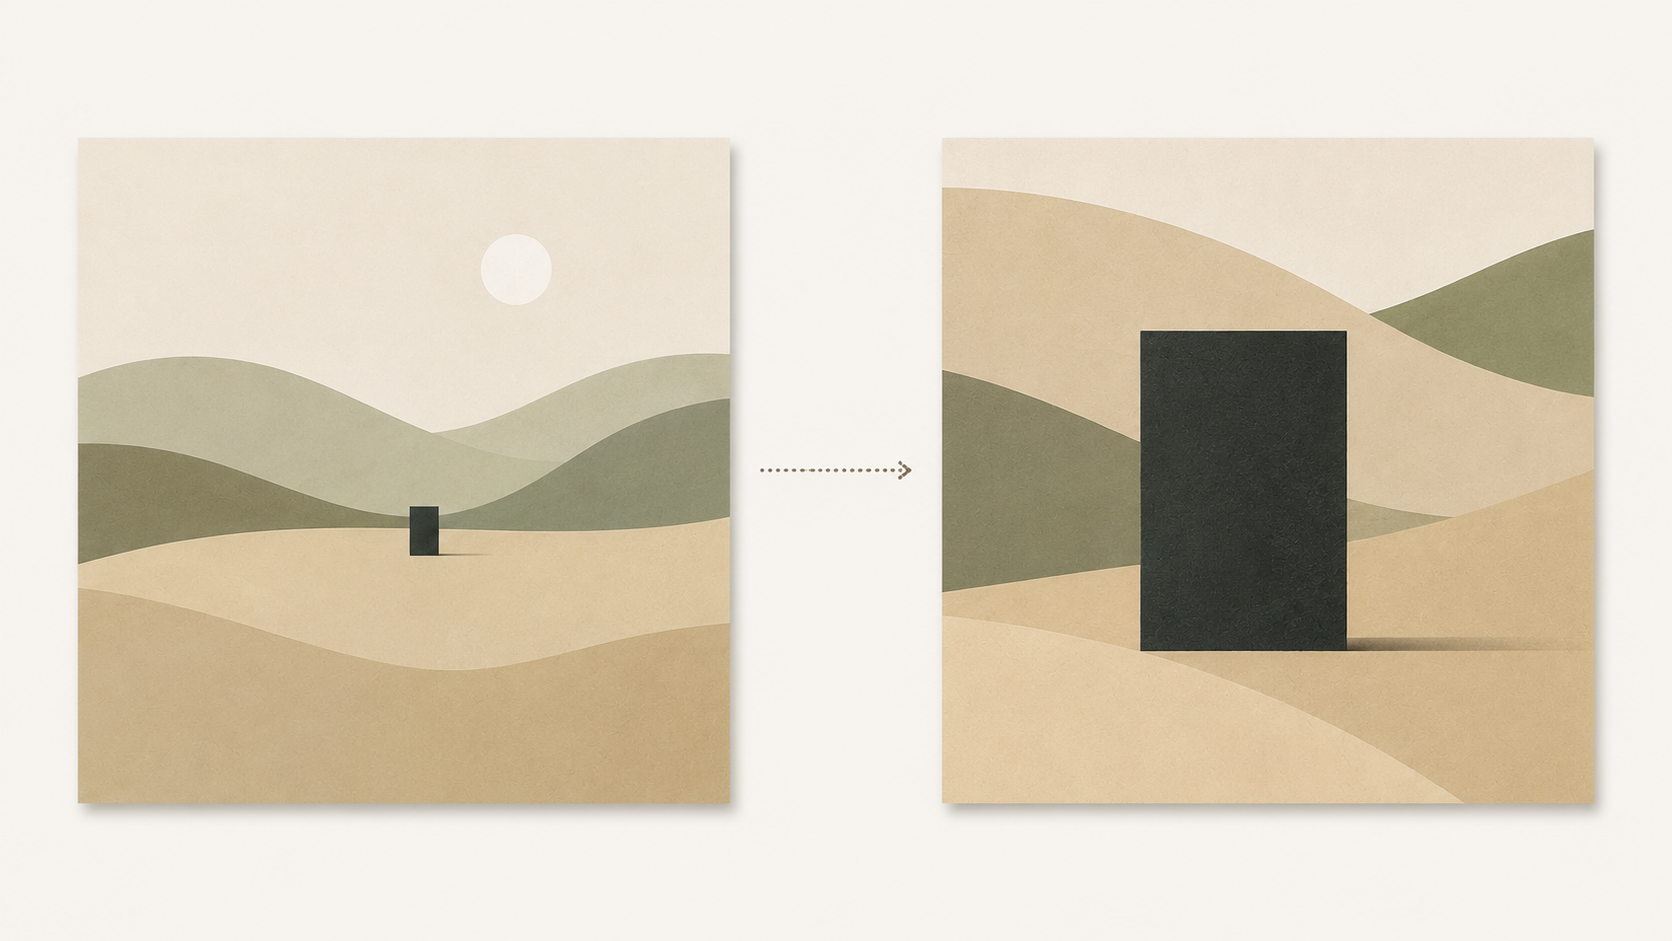
Le contrôle de première et dernière image prend deux fichiers distincts — l'image d'ouverture et l'image de fermeture — et génère la cinématique fluide qui les relie.
Ce processus change fondamentalement la donne pour trois raisons :
Il substitue l'interpolation à l'invention aveugle. Sans ce double repère, le modèle se demande continuellement : « que doit-il se passer ensuite ? ». Avec lui, il résout une équation fermée : « quelle trajectoire logique permet d'aller d'ici à là ? ». Cette seconde question admet un nombre fini de solutions visuelles stables.
Il offre deux ancrages au lieu d'un seul. Partir d'une seule image initiale laisse les erreurs de calcul diverger librement. Imposer l'image d'arrivée oblige le réseau neuronal à converger vers la cible, forçant le système à résorber les éventuels écarts avant la fin du plan.
Il garantit la conformité aux exigences de production. Dans le cadre de projets clients, un plan doit souvent aboutir à un cadrage précis à un instant T. Ce réglage est l'unique moyen d'assurer que ce cadrage sera scrupuleusement respecté.
Ce que le système ne fait pas : il ne garantit pas la perfection absolue de chaque seconde intermédiaire. Il impose les bornes, mais la trajectoire cinétique exacte reste calculée par le modèle.
Quels sont les modèles qui prennent en charge ce réglage ?
Le support évolue rapidement selon les versions déployées ; vérifiez toujours vos accès :
Kling 4.0 gère plusieurs images clés réparties sur la durée et accepte explicitement des images d'entrée dans son mode image-to-video, ce qui convient parfaitement aux plans à plusieurs temps.
Veo 3.1 permet d'injecter nativement la première et la dernière image via l'API Gemini.
Seedance 2.5 prend en charge ce double verrouillage en complément de son système d'images de référence.
Wan ainsi que la suite vidéo de Model Studio (Alibaba) gèrent les flux conditionnés par images d'entrée et de sortie.
Les numéros de versions changent tous les mois, mais le principe reste identique : dès lors qu'un outil accepte deux images de référence pour un même clip, cette méthode s'applique immédiatement.
Cinq règles d'or pour concevoir vos images de départ
La majorité des échecs surviennent avant même la génération, au stade de la création des deux images de référence.
1. Respectez rigoureusement la même lumière. Si votre image de départ baigne dans une lumière diffuse de ciel voilé et que votre image finale présente un contre-jour de coucher de soleil, le modèle tentera un fondu enchaîné discordant au beau milieu du plan. Harmonisez la lumière.
2. Conservez la même focale optique. Débuter sur un plan large et terminer sur un plan serré est tout à fait valable, mais uniquement si vous demandez un travelling avant régulier. Sans consigne de caméra adaptée, le modèle tentera une métamorphose déformante.
3. Restez dans des distances physiques plausibles. En huit secondes, un personnage peut traverser une pièce, pas traverser un quartier. Les paires d'images imposant des déplacements disproportionnés créent des artefacts d'accélération violents.
4. Laissez un écart visuel suffisant pour le mouvement. Fournir deux images quasi identiques est une erreur classique : n'ayant rien à interpoler, le modèle produit une image figée qui vibre sans dynamique réelle. Il faut un différentiel d'action clair.
5. Générez vous-même des images sources impeccables. Vos deux images clés doivent être des rendus haute définition parfaitement nets. Partir de captures d'écran compressées donnera invariablement une vidéo floue.
5 recettes de production prêtes à l'emploi
Chaque formule associe un duo d'images et le prompt de mouvement à insérer entre elles. Le prompt décrit le mouvement cinétique, et non le décor (déjà explicité par vos images).
1. L'écoulement du temps (Time-lapse)
Images : Le même paysage à midi puis à l'heure bleue.
Slow, steady time-lapse transition: the light across the valley shifts from warm midday to cool blue dusk, shadows lengthening and stretching as the sun drops, thin clouds drifting slowly overhead. Camera locked off, no subject movement, gentle exposure change.
2. Le changement de tenue vestimentaire
Images : Le même sujet adulte, même posture, avec deux tenues différentes.
A seamless in-camera transition: the subject stands still as warm light sweeps across the frame from left to right, and the clothing resolves into the second outfit without any cut. Camera locked, only the light and the fabric change.
3. Le travelling avant d'approche (The push in)
Images : Un plan large d'un salon, suivi d'un plan rapproché sur un objet précis posé sur une table.
A slow, smooth dolly push from the wide position toward the detail, maintaining the same focal length, moving in a single continuous take. No zoom, no reframing, no cuts.
4. La révélation de produit
Images : Un coffret fermé, suivi du même coffret ouvert laissant voir le flacon intérieur.
A continuous product shot: the lid lifts and swings back on its hinge in one smooth motion, warm key light following the opening, soft shadow shifting across the surface. Camera slowly orbits a few degrees.
5. La silhouette dans la rue déserte
Images : Une ruelle vide, suivie de la même ruelle occupée au loin par une silhouette.
A locked-off shot: a lone figure in a long coat walks slowly in from the far end of the street, growing from a small silhouetted shape into a clear figure, mist drifting across the frame throughout. No camera movement.
Les causes résiduelles d'échec et leurs solutions
Si votre rendu présente des anomalies, le problème provient presque toujours de l'un de ces quatre facteurs :
Images trop proches → Aucun mouvement. Si vos deux images sont quasi superposables, le résultat sera un plan fixe vibrant. Solution : augmentez le décalage de posture ou d'échelle.
Images trop dissemblables → Déformation morphing. Si les deux images n'ont aucun repère spatial commun, le modèle renonce à la continuité spatiale et fond l'ensemble dans une bouillie de pixels. Solution : rapprochez vos cadrages et uniformisez la colorimétrie.
Le prompt décrit une troisième scène. C'est l'erreur la plus fréquente. Ne redécrivez pas les vêtements ou le mobilier dans le prompt textuel ; vos images s'en chargent déjà. Solution : décrivez uniquement l'action de transition.
Durée trop courte pour la distance à parcourir. Vouloir franchir un espace immense en quatre secondes produit une impression de saccade. Solution : allongez la durée du clip à huit ou dix secondes.
La règle d'écriture du prompt intermédiaire
Le principe d'or : décrivez des verbes, pas des noms.
Grâce au contrôle de première et dernière image, vos fichiers visuels ont déjà réglé les questions de sujet, de décor, de style et d'éclairage. Votre prompt textuel doit exclusivement expliciter le comment : le comportement de la caméra, le sens de rotation, la vitesse du changement et les éléments qui doivent rester parfaitement immobiles.
C'est pourquoi nos recettes sont deux fois plus concises qu'un prompt vidéo ordinaire. Les images clés portent la structure ; surcharger le prompt textuel revient à parasiter le calcul des repères.
Un prompt pour concevoir vos images de départ
La réussite de l'exercice dépend de la qualité de vos images fixes : commencez toujours par un rendu propre et équilibré.
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
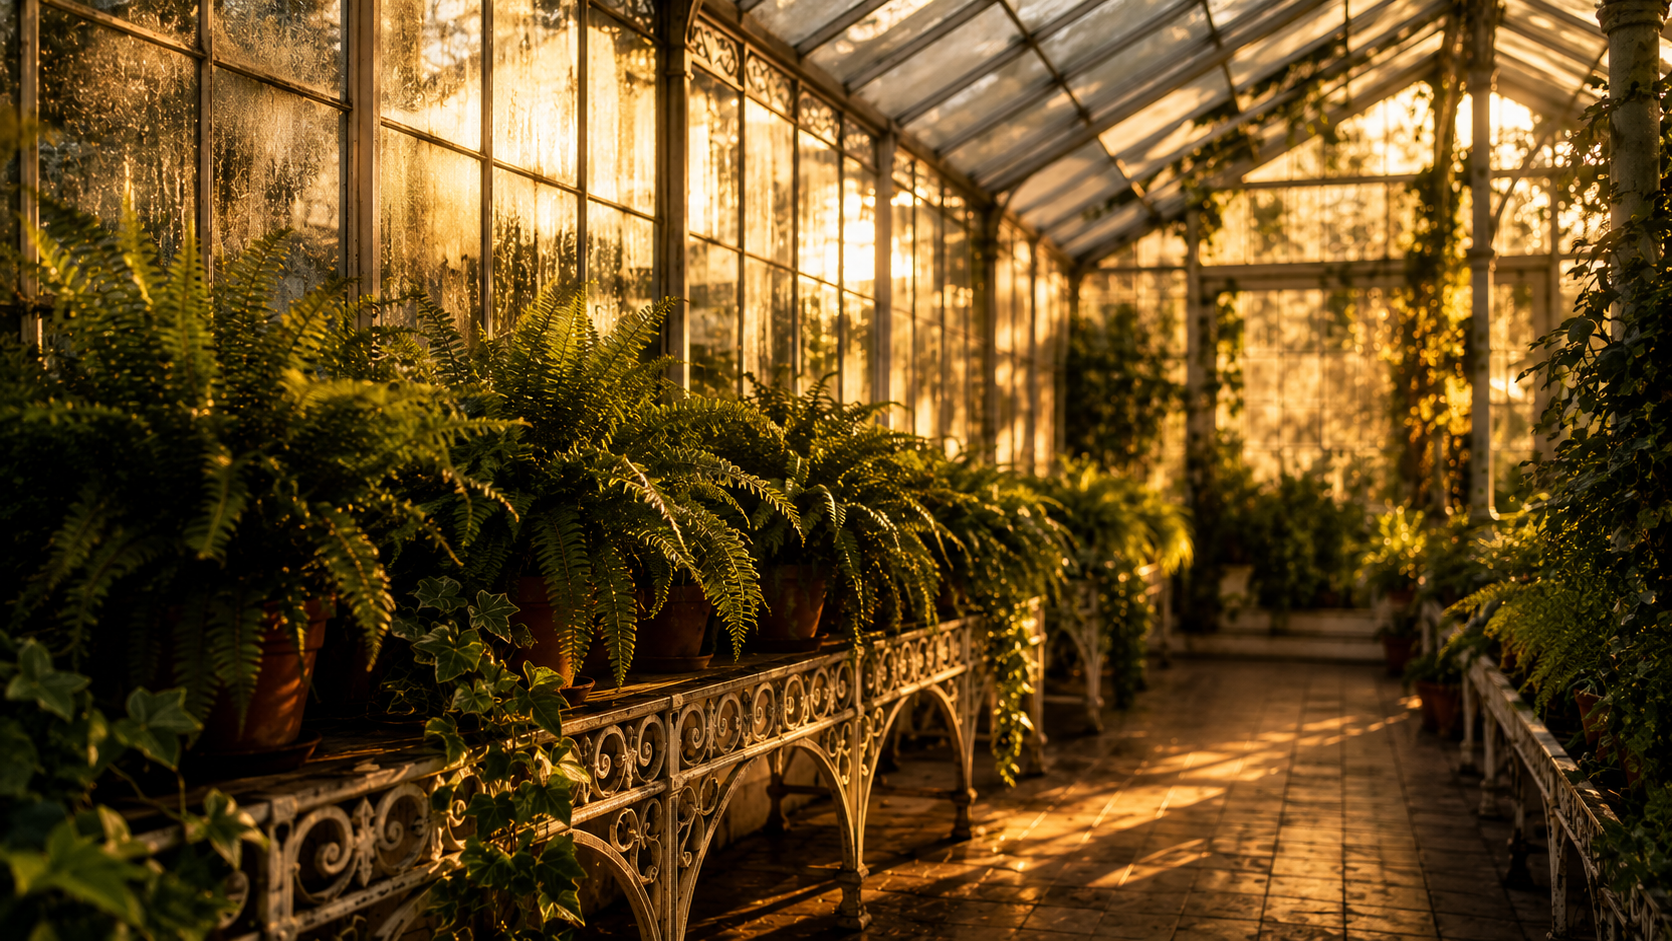
A cinematic still of a glass greenhouse interior at golden hour: long rows of potted ferns and trailing ivy on white iron benches, warm sunlight streaming through dusty glass panes and casting long diagonal shadows across a tiled floor, faint condensation on the windows. Rich green foliage against warm amber light, fine texture in the leaves and glass, shallow depth of field, 16:9 framing, 8K detail, no text overlay.
Générez ce visuel deux fois sur Fanch AI : une première fois en lumière dorée (« golden hour »), puis une seconde en ajustant le prompt pour le crépuscule (« dusk »). Vous disposerez immédiatement du duo parfait pour expérimenter la recette de transition temporelle.
Pourquoi Fanch AI fiabilise vos projets vidéo
Une animation par première et dernière image ne vaut que par la qualité des deux visuels sources que vous lui fournissez, et ces images fixes constituent l'étape que vous maîtrisez de bout en bout. Fanch AI vous propose un modèle dédié piloté par des prompts précis, vous permettant d'obtenir des paires de départ et d'arrivée rigoureusement calibrées — même focale, même lumière, une seule variation maîtrisée — prêtes à être animées sans mauvaise surprise sur vos outils vidéo favoris.
👉 Commencez ici : créez votre vidéo avec Veo 3.1 sur Fanch AI.