
FLUX 3 Klein sur Blackwell : Ce que mesure réellement l'accélération de 4,45x | Fanch AI
Le blog développeur de NVIDIA a récemment publié un article intitulé « Accélérez la génération d'images avec FLUX 3 Image Klein sur les GPU NVIDIA Blackwell », accompagné d'un chiffre spectaculaire : une vitesse multipliée jusqu'à 4,45 fois. En y regardant de plus près, on constate que ce benchmark a été mesuré sur un unique GPU B200, et spécifiquement sur des tâches de retouche (editing) d'images.
Ces deux précisions sont bien plus déterminantes que le multiplicateur lui-même. Le format NVFP4 constitue le levier technologique de ce gain de performance. Comprendre ses mécanismes permet d'expliquer pourquoi ce chiffre record concerne d'abord les cartes pour centres de données, tout en préfigurant l'avenir des stations de travail individuelles.
Ce que NVIDIA a réellement mesuré
Avant toute extrapolation, trois constats techniques s'imposent :
Il s'agit d'un test constructeur exécuté sur son propre matériel. Le banc d'essai tourne sur l'architecture Blackwell, exploite un format de quantification développé par NVIDIA pour Blackwell et repose sur un modèle optimisé par NVIDIA. Cela n'invalide en rien la mesure, mais correspond au scénario le plus favorable possible (best case), établi par l'acteur qui maîtrise l'intégralité de la chaîne logicielle et matérielle.
Le test a été conduit sur un GPU B200. C'est une carte pour serveurs d'entreprise. Il ne s'agit ni d'une RTX 4070, ni d'une 5080, ni d'un composant présent dans une tour de bureau standard.
La mesure concerne la retouche, non la génération brute. Le chiffre de 4,45x a été relevé sur le pipeline d'édition d'image de FLUX 3. La retouche locale (inpainting) et la génération text-to-image présentent des profils de calcul dissemblables ; rien ne permet d'extrapoler ce multiplicateur à l'ensemble des cas d'usage.
Le bilan objectif est donc le suivant : NVFP4 accélère spectaculairement la retouche avec FLUX 3 Klein sur l'équipement le plus haut de gamme de NVIDIA. Reste à déterminer ce que cette avancée apporte concrètement aux créateurs et aux équipes de production.
Ce qu'est concrètement NVFP4
Le format NVFP4 désigne la quantification en virgule flottante sur 4 bits introduite par NVIDIA avec l'architecture Blackwell. La décomposition du nom est explicite : FP4 indique que chaque poids du réseau de neurones est encodé sur 4 bits, tandis que le préfixe NV signale la déclinaison propriétaire conçue par NVIDIA.
Réduire chaque paramètre à 4 bits représente une compression drastique. Un modèle en précision standard bf16 utilise 16 bits par poids ; NVFP4 divise ainsi l'empreinte mémoire par quatre, avant même toute autre optimisation logicielle. C'est là que réside le gain de vitesse initial, et la raison d'être de ce format.
Deux choix d'ingénierie rendent le NVFP4 véritablement exploitable sur le plan qualitatif :
La mise à l'échelle par blocs (Block-wise scaling). Convertir brutalement chaque poids sur 4 bits dégrade irrémédiablement un modèle, car un facteur d'échelle unique par tenseur ne peut pas restituer des valeurs variant sur plusieurs ordres de grandeur. NVFP4 intègre des facteurs d'échelle par blocs de paramètres : chaque petit groupe de poids bénéficie ainsi de sa propre calibration. C'est ce qui sépare une quantification 4 bits fonctionnelle d'un modèle qui ne produit que du bruit visuel.
La prise en charge matérielle native. NVFP4 est câblé au cœur même du silicium de Blackwell. Cela marque aussi la limite actuelle de son déploiement : ce format n'est ultra-rapide que parce que les puces Blackwell intègrent des unités de calcul dédiées, absentes des générations précédentes de GPU.
L'échelle de la quantification (The Quantization Ladder)
Le format NVFP4 ne constitue pas une solution isolée, mais le dernier barreau d'une échelle technique. La communauté open-source a d'ailleurs déjà mis en ligne plusieurs déclinaisons de FLUX 3 Klein : il existe des dépôts pour NVFP4, pour le FP8, ainsi que des approches hybrides nommées W4A16 et W4A4.
Voici le bilan avantages-inconvénients de chaque échelon :
bf16 — Pleine précision. L'étalon de référence absolu par rapport auquel sont jaugées les déclinaisons NVFP4. Il restitue l'intégralité des micro-détails du modèle, au prix d'une empreinte VRAM maximale et d'une exécution plus lente.
FP8 — 8 bits. Réduit l'empreinte mémoire de moitié par rapport au bf16, avec une perte de fidélité quasiment indécelable à l'œil nu. C'est l'étape de compression la plus sûre et l'option par défaut recommandée avant d'envisager le NVFP4.
NVFP4 — 4 bits. Réduit la consommation de VRAM à environ un quart du bf16. C'est là que se matérialisent les gains majeurs de débit et d'espace, mais cela impose des vérifications visuelles systématiques.
W4A16 — Poids en 4 bits, activations en 16 bits. Les poids sont fortement compressés tandis que les activations conservent leur précision d'origine. C'est un compromis classique qui préserve souvent mieux le rendu global qu'une compression intégrale.
W4A4 — Poids et activations en 4 bits. Compression maximale, niveau de risque maximal. À réserver aux configurations sévèrement limitées par la mémoire ; ce n'est pas un point de départ adapté à la production courante.
La règle d'or : la compression n'est pas un choix binaire. La précision des poids et celle des activations constituent deux axes indépendants, et les formats mixtes existent précisément parce que la dégradation de l'un pénalise moins l'image finale que la dégradation simultanée des deux.
Pourquoi cette échelle technique s'impose
C'est l'élément que la plupart des synthèses techniques omettent, et qui explique pourquoi le format NVFP4 apporte un gain proche de 4x plutôt qu'une amélioration marginale.
Les modèles de diffusion d'images sont généralement limités par la bande passante mémoire (Memory-bandwidth bound), et non par la puissance de calcul brute (Compute bound). Générer une image impose de faire transiter des matrices de poids colossales à travers les cœurs de calcul plusieurs dizaines de fois lors des étapes d'échantillonnage (denoising). L'arithmétique n'est pas le facteur limitant ; le déplacement des données l'est.
Cette réalité redéfinit l'optimisation : si le processeur passe son temps à attendre l'arrivée des données en provenance de la VRAM, la division par quatre de la taille des poids offerte par le NVFP4 supprime directement le goulot d'étranglement. La puce ne calcule pas magiquement plus vite : elle passe simplement beaucoup moins de temps inactive.
Voilà pourquoi, pour la génération locale, la quantification surpasse les retouches d'architecture : elle résout la contrainte physique qui bride réellement l'exécution.
L'impact du NVFP4 sur la qualité d'image
La compression NVFP4 opère avec perte, et cette dégradation ne s'applique pas uniformément à l'image. Elle affecte des registres visuels très identifiables :
Les micro-textures haute fréquence. Le tissage des étoffes, les mèches de cheveux, le grain de pellicule, les pores de la peau. C'est sur ces textures que la compression 4 bits se trahit en premier, car les micro-variations de faible amplitude sont éliminées lors de l'arrondi mathématique.
Les textes de petite taille. Le rendu de typographies fines réclame une grande précision vectorielle. Attendez-vous à perdre en lisibilité sous NVFP4 sur des inscriptions qui restent parfaitement nettes en FP8.
Les dégradés subtils. Les transitions d'un ciel limpide ou les nuances d'un teint peuvent présenter de légères bandes (banding) lorsque la dynamique tonale est compressée.
Ce qui reste parfaitement préservé. La composition générale, la justesse de la palette, les grands aplats et l'éclairage global. La structure spatiale ne réclame pas une précision chirurgicale ; le micro-détail, si. Une image issue de NVFP4 peut ainsi paraître irréprochable au premier coup d'œil, mais révéler ses faiblesses dès qu'on l'examine à 100 %.
Le fossé entre centre de données et station de travail
La réserve essentielle à formuler au sujet de ce gain de 4,45x est qu'il ne se transpose pas directement sur votre configuration personnelle :
L'architecture Blackwell est requise. Le format NVFP4 s'appuie sur des instructions matérielles spécifiques. Sur des générations antérieures comme Ada Lovelace (RTX série 40), vous pouvez exécuter des modèles quantifiés, mais sans bénéficier des mêmes gains d'efficacité car les unités de calcul dédiées n'existent pas sur la puce.
Le benchmark repose sur une puce B200. Une carte de data center dispose d'une bande passante et d'une quantité de mémoire sans commune mesure avec le matériel grand public. La trajectoire technologique est bien réelle, mais l'ampleur du multiplicateur ne s'applique pas telle quelle.
L'écosystème grand public suit une autre dynamique. Faire tourner FLUX 3 Klein sur des cartes à 8 Go de VRAM relève de la compression du modèle de base à précision réduite — une prouesse technique incontestable, mais très différente d'un gain de 4,45x mesuré sur une B200.
Considérez ce benchmark comme un indicateur clair des orientations futures de l'industrie, et non comme une promesse immédiate pour votre équipement actuel.
Comment choisir votre niveau de précision
Partez de votre contrainte opérationnelle pour déterminer le bon arbitrage :
Si vous manquez de mémoire VRAM (le modèle refuse de se charger), basculez sur le NVFP4 ou une version W4A16 et acceptez une légère perte de texture. Une image générée avec des micro-défauts vaut toujours mieux qu'une erreur de saturation mémoire (OOM).
Si votre VRAM suffit mais que vous cherchez la vitesse, commencez par le FP8. Il offre le meilleur ratio qualité/vitesse sur la majorité des cartes actuelles sans risque visible sur le rendu.
Si la qualité finale est votre critère absolu, effectuez vos rendus définitifs en bf16 et réservez le NVFP4 au prototypage rapide. Cette double approche est l'application la plus rentable de la quantification : tester à bas coût, finaliser en pleine résolution.
Si vous disposez d'un matériel antérieur à Blackwell, orientez-vous vers des versions FP8 ou GGUF. Les gains d'exécution natifs du NVFP4 ne peuvent pas être activés par une simple mise à jour logicielle.
Quatre étapes de contrôle avant d'adopter un modèle
Évaluez ces aspects sur vos propres flux de travail :
Testez une scène à forte densité de textures. Un tissu tricoté, un feuillage fourni ou une chevelure détachée révèlent les limites du NVFP4 bien plus vite qu'un portrait classique.
Testez une image intégrant des textes de petite taille. Des mentions secondaires sur un packaging, plutôt qu'un gros titre.
Testez un aplat avec dégradé doux. Un ciel d'aurore ou un fond de studio neutre, pour repérer d'éventuelles cassures de tons.
Comparez à prompt et seed identiques. Confrontez le rendu bf16 avec votre version quantifiée à 100 % d'échelle. Répétez ensuite l'examen à la taille réelle de diffusion. Si aucune différence n'est perceptible au format final, le niveau de quantification est validé pour cet usage.
Un prompt d'étalonnage à essayer
Pour tester l'impact réel de la quantification, concentrez votre attention sur les matières complexes : c'est là que les compromis algorithmiques apparaissent au grand jour.
Copiez et collez ceci dans Fanch AI (Modèle : gpt_image_2) :
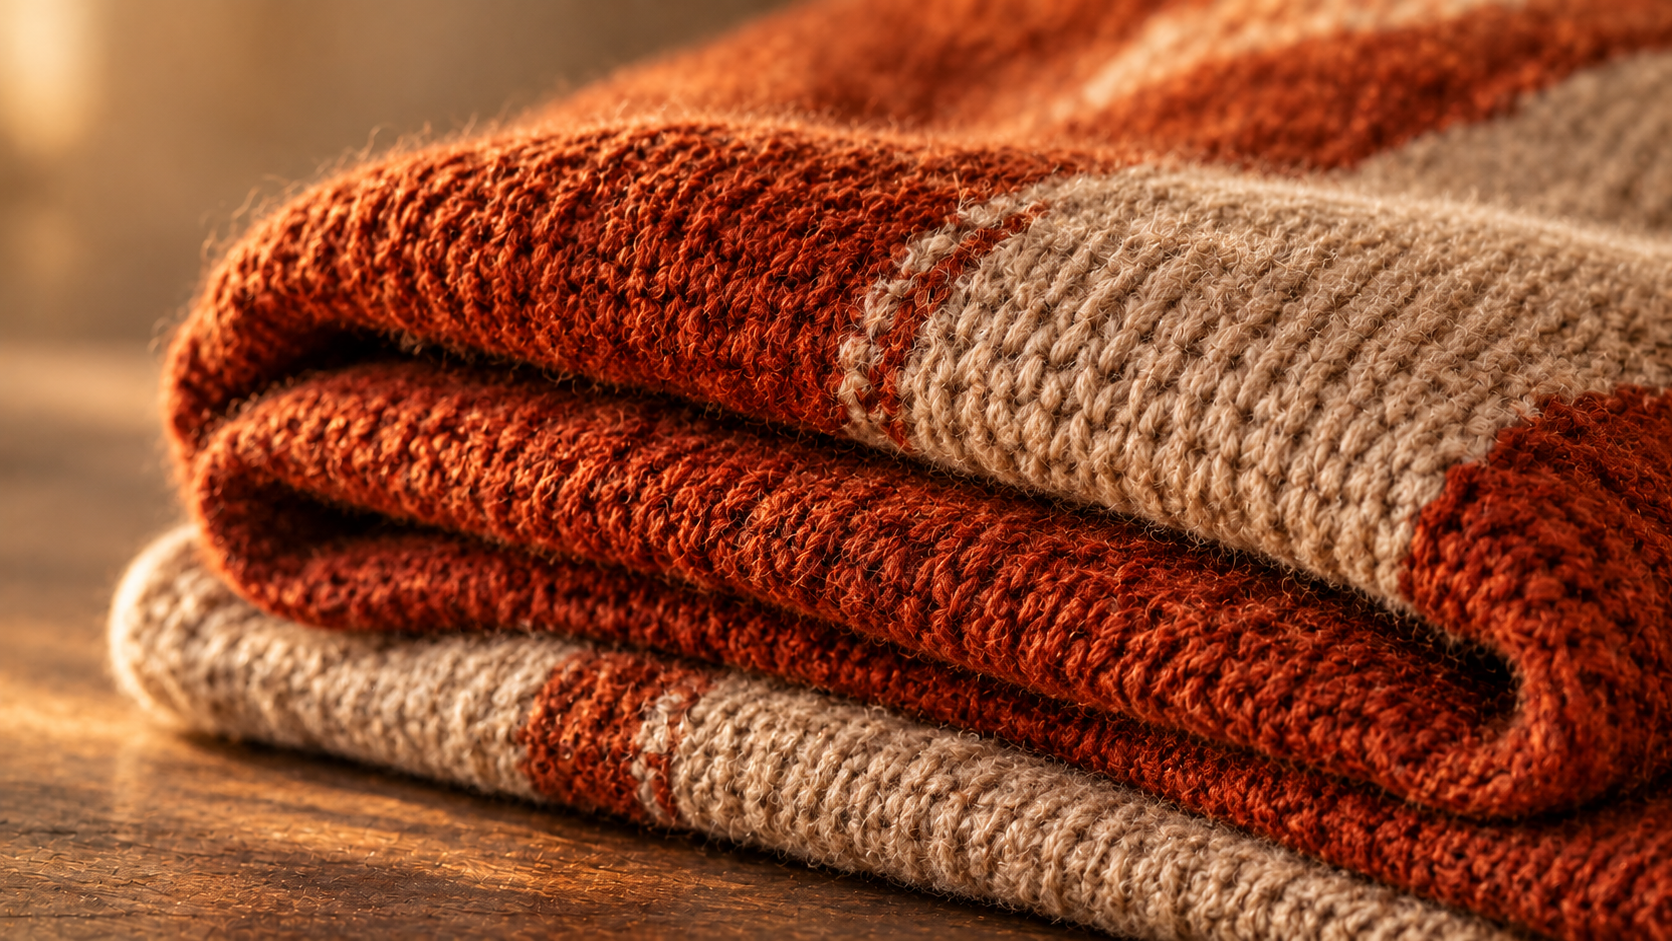
A macro editorial photograph of a folded hand-knit woollen blanket in deep rust and oatmeal tones, stacked in soft uneven layers: individual yarn fibres and small stitches clearly resolved, a few loose fibres catching a low warm side light, subtle fuzz along the folded edges. Extremely fine detail in the knit structure, warm muted palette, shallow depth of field falling off at the frame edges, 16:9 framing, 8K detail, no people, no text overlay.
Générez ce visuel avec votre niveau de quantification cible et examinez la netteté du point de tricot. Si les mailles perdent leur relief pour former une surface lisse, vous avez identifié le seuil critique d'altération du NVFP4.
Pourquoi Fanch AI s'intègre dans ce flux de production
Le NVFP4 et l'échelle de quantification poursuivent un objectif fondamental : rendre l'exploration visuelle plus accessible, plus rapide et moins coûteuse. Cela rejoint directement la préoccupation de tout créateur : disposer de la marge de manœuvre nécessaire pour multiplier les essais jusqu'à trouver l'image parfaite.
Fanch AI met à votre disposition un modèle d'image dédié que vous dirigez à l'aide de prompts minutieux, vous permettant d'arrêter la composition, l'éclairage et la palette de couleurs sans vous heurter aux limites de votre matériel local — avant d'exporter ce cadre de référence vers le pipeline de rendu de votre choix.