
ファースト&ラストフレーム:AI 動画の崩れとドリフトを抑え込む必須設定 | Fanch AI
最初と最後のフレーム(first and last frame / 首尾フレーム) の制御は、AI 動画制作において最も見落とされがちな強力な設定です。多くのクリエイターが美しいプロンプトを入力して 8 秒の動画を生成した結果、ショットが静かに崩れていく現実に直面します——顔の造形が崩れ、部屋の配置が勝手に変わり、光源が不自然に移動してしまうのです。
これは動画生成モデルに「長期的な記憶」が存在しないために起こります。各フレームは、直前のフレームのみを手がかりにした新たな推測の積み重ねに過ぎません。微細な誤差が連鎖的に増幅し、8 秒後には全く別のシーンが生成されてしまいます。
ファースト&ラストフレーム 制御は、この構造的な問題を根本から解決します。ショットの開始点と到達点をあらかじめ固定することで、モデルの役割を「あてずっぽうの創造」から「2 点間の物理的な補間(Interpolation)」へと変換するのです。ここでは、設定の仕組み、構図ルール、5 つの即戦力レシピ、そして失敗パターンの回避法を網羅した実践ガイドをお届けします。
なぜ AI 動画は破綻し、形が崩れるのか
解決策を導入する前に、まずは失敗が生じるメカニズムを理解する必要があります。
フレームは推測であり、記憶ではありません。 テキストから動画を生成するモデルは、頭の中に 3 次元の世界を保持していません。「直前のフレームに続くはずだ」という緩やかな制約のもとで 1 コマずつ出力しているだけです。長い動画になるほど、この緩い制約は簡単に逸脱(ドリフト)を引き起こします。
アイデンティティ(固有の特徴)が最も早く崩れます。 人物の顔や微細なテクスチャは、ピクセルあたりに保持する情報量が最も多いため、ドリフトの最初の犠牲になります。壁のテクスチャが 20% 劣化しても気づかれませんが、顔立ちが 20% 崩れれば即座に不気味の谷に落ち込みます。
カメラワークが破綻を加速させます。 ゆったりとしたカメラ移動は誤差を蓄積させ、急激なカメラ移動はディテールを押し潰します。いずれにせよ、両端を固定しない限りドリフトは避けられません。
プロンプトは静的な指示であるのに対し、生成誤差は動的に蓄積されるため、プロンプトの工夫だけでこの問題を完全に防ぐことは不可能です。しかし、両端の終着点を拘束することは可能です。これこそが 首尾フレーム制御 が存在する理由です。
首尾フレーム制御が実際に行っていること
ファースト&ラストフレーム 制御は、開始フレームと終了フレームという 2 枚の画像を受け取り、その間を埋めるモーションを生成します。
この設定が結果を劇的に変える理由は 3 つあります:
「推測」を「補間」へと転換する。 首尾フレームを指定しない場合、モデルは「次に何が起きるか?」を考えます。両端を指定した場合、モデルは「ここからあそこへどうやって遷移するか?」を考えます。後者の問いには明確な限界値が存在するため、破綻のない一貫した結果が得られます。
1 つではなく 2 つのアンカー(固定点)を得られる。 開始画像だけでは、時間の経過とともに誤差が無制限に広がります。終了フレームを加えることで、モデルは最終的に元の整合性へと収束せざるを得なくなり、途中のブレは最終フレームに向けて強制的に修正されます。
クライアントワークで納品可能な精度を保証できる。 商業案件では、特定の秒数で特定のビジュアルを見せることが求められます。ファースト&ラストフレーム は、その決定的な瞬間を確実に着地させる唯一の手法です。
注意点:この設定は中間フレームのクオリティを無条件で保証するものではありません。あくまで両端を固定するだけであり、その間をどう移動するかはモデルの計算に委ねられます。
対応している主要モデル
各ツールの対応状況はアップデートごとに変化するため、常に最新の仕様を確認してください:
Kling 4.0 は 2 フレームだけでなくマルチキーフレームに対応しており、画像から動画への生成(Image-to-Video)でフレームを明示的に指定可能です。複数のビートを持つカットに極めて有効です。
Veo 3.1 は Gemini API 経由で最初と最後のフレームの指定に対応しています。
Seedance 2.5 は豊富な参照画像スロットとともに、首尾フレームの制御をサポートしています。
Wan およびアリババの Model Studio 動画ツール群も、フレーム条件付き生成を幅広くサポートしています。
バージョン番号は常に変わりますが、根本的な原則は同じです。2 枚の画像を入力できるツールであれば、この手法はすべて機能します。
成功率を劇的に高める 5 つの画像準備ルール
失敗する試みの多くは、動画生成ボタンを押す前、すなわち「画像の準備段階」で間違っています。
1. ライティングと時間帯を完全に一致させる。 開始フレームが曇り空の昼間で、終了フレームが夕暮れ時である場合、モデルはそのギャップを埋めるために動画の途中で無理やり夕日をフェードインさせます。光の条件は必ず揃えてください。
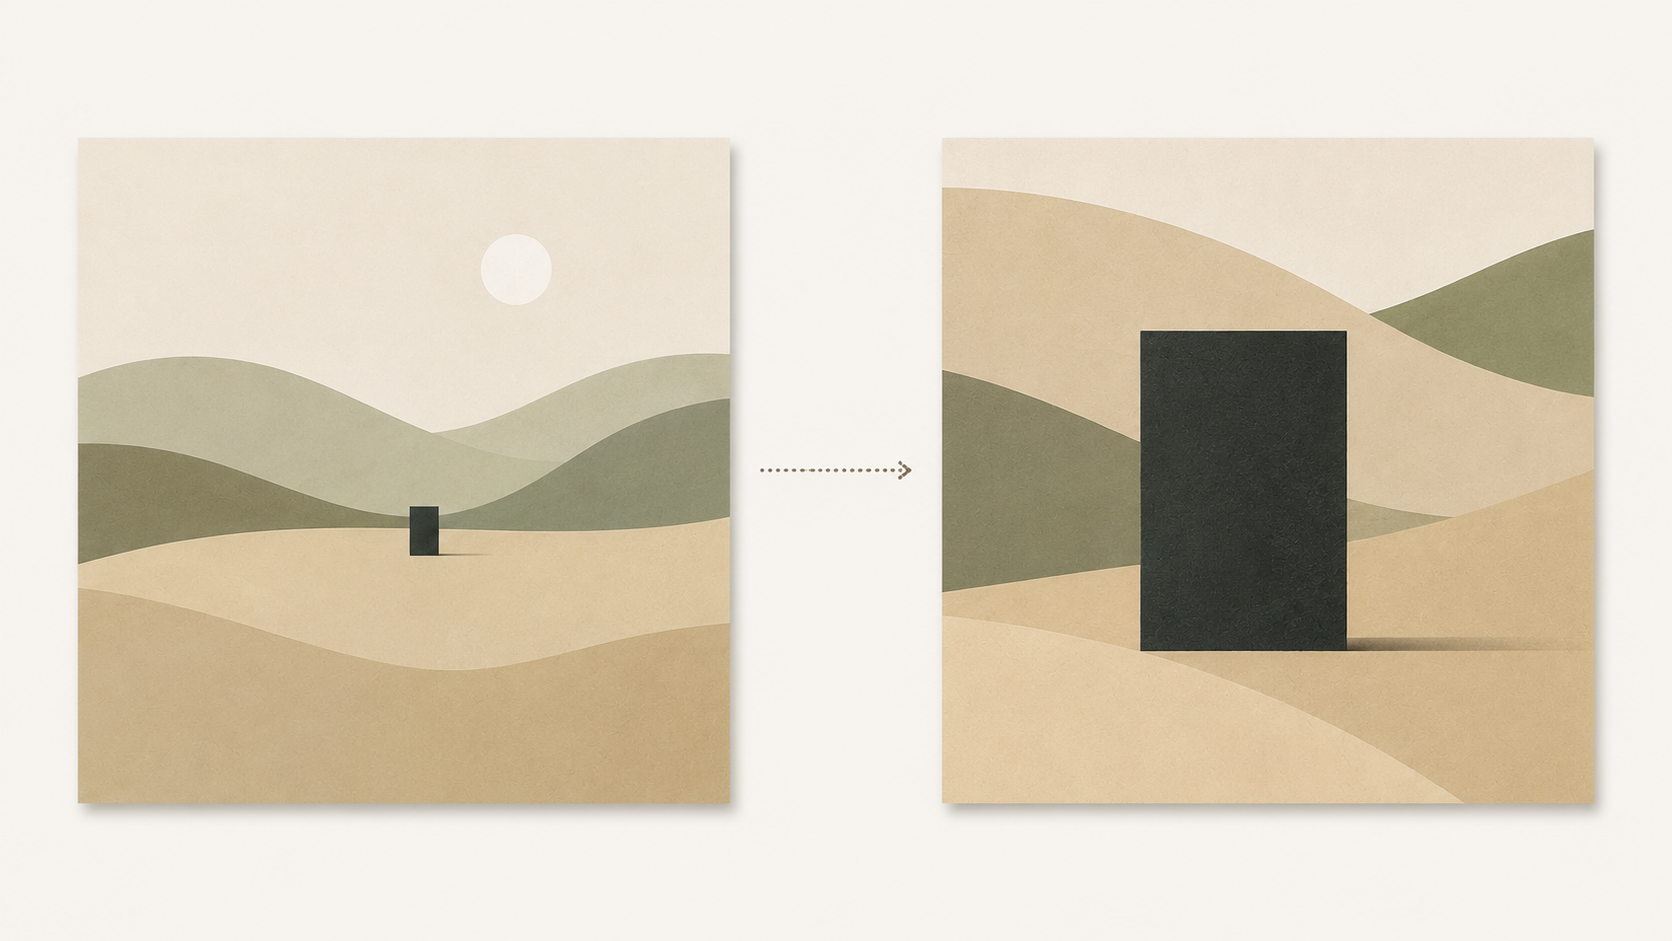
2. レンズの焦点距離と画角のトーンを統一する。 広角で始まり超クローズアップで終わる組み合わせは、徐々にカメラが寄る指示(ドリーイン)を与える場合のみ有効です。指示がないまま極端な画角差を与えると、不気味なモーフィング変形が発生します。
3. 移動距離を物理的に現実的な範囲に収める。 8 秒間で人物が移動できるのは部屋の端から端までであり、街の反対側まで歩くことはできません。移動距離が大きすぎるペアは、不自然な高速移動のアーティファクトを引き起こします。
4. 動きのための適切な「差分」を残す。 ほぼ同一の画像を 2 枚配置してしまうのは初心者にありがちなミスです。モデルは補間すべき動きを見つけられず、ただ震えるだけの静止画を出力してしまいます。意味のある適度な変化が必要です。
5. 高精細な基準静止画を用意する。 開始・終了画像には、ノイズのない完成された高解像度スチールを使用してください。圧縮された低品質なスクリーンショットからは、低品質な動画しか生まれません。
すぐに使える 5 つの首尾フレーム実践レシピ
各レシピは、2 枚のフレーム画像と、その間をつなぐために記述するプロンプトで構成されます。プロンプトには「シーンの説明」ではなく「動き(変化)」のみを記述します。シーンの情報はすでに画像に含まれているからです。
1. 時間の推移(タイムラプス)
フレーム:同じ風景の「正午」と「ブルーアワー(夕暮れ)」。
Slow, steady time-lapse transition: the light across the valley shifts from warm midday to cool blue dusk, shadows lengthening and stretching as the sun drops, thin clouds drifting slowly overhead. Camera locked off, no subject movement, gentle exposure change.
2. シームレスな衣装チェンジ
フレーム:同じ成人モデル、同じ立ち位置、2 種類の異なるコーディネート。
A seamless in-camera transition: the subject stands still as warm light sweeps across the frame from left to right, and the clothing resolves into the second outfit without any cut. Camera locked, only the light and the fabric change.
3. ディテールへのカメラ寄り(プッシュイン)
フレーム:部屋全体の広角ショットと、その部屋にある特定の小物の接写ショット。
A slow, smooth dolly push from the wide position toward the detail, maintaining the same focal length, moving in a single continuous take. No zoom, no reframing, no cuts.
4. プロダクトの開箱・展開
フレーム:閉じた状態の化粧箱と、蓋が開いて製品が現れている状態。
A continuous product shot: the lid lifts and swings back on its hinge in one smooth motion, warm key light following the opening, soft shadow shifting across the surface. Camera slowly orbits a few degrees.
5. 人影が現れるストリート
フレーム:誰もいない通りと、遠くにコートを着た人物が立っている同じ通り。
A locked-off shot: a lone figure in a long coat walks slowly in from the far end of the street, growing from a small silhouetted shape into a clear figure, mist drifting across the frame throughout. No camera movement.
首尾フレームがそれでも失敗する 4 つの理由
画像が似すぎている → 動きが起きない。 2 枚の差が少なすぎると、出力は単に振動する静止画になります。構図やポーズに適度な差分を設けてください。
画像が乖離しすぎている → モーフィングになる。 共通する視覚的文脈がなさすぎると、モデルは物理的な補間を諦めてディゾルブ(全体が溶け合うような不自然な遷移)を起こします。画角や光を近づけてください。
プロンプトに第 3 のシーンを記述している。 最も多いミスです。動きのプロンプトで被写体や背景を長々と再説明しないでください。モデルはすでに画像からそれらを読み取っています。変化する内容だけを書いてください。
秒数に対して移動距離が長すぎる。 4 秒のクリップで大きな空間移動をさせようとすると、映像がコマ飛びします。動きに必要な時間を与えてください。
フレーム間をつなぐプロンプトの記述原則
要約すると:名詞ではなく、動詞を書く。
ファースト&ラストフレーム を使う場合、2 枚の画像が「誰が、何を、どこで、いつ」という情報をすでに完璧に定義しています。プロンプトが答えるべきは「どのように(How)」だけです。カメラの挙動、変化の方向とスピード、そして静止していなければならない要素を記述します。
上記のレシピが通常の動画プロンプトの半分の長さで済んでいるのはそのためです。首尾フレームが仕様の大半を担っているため、プロンプトを過剰に書きすぎると画像との間で競合が発生してしまいます。
今すぐ試せる画像生成プロンプト
まずは高品質な基準フレームを用意することが成功の鍵です。精緻な指示に従う画像モデルで作成しましょう:
以下をコピーして Fanch AI に貼り付け(モデル選択:gpt_image_2):
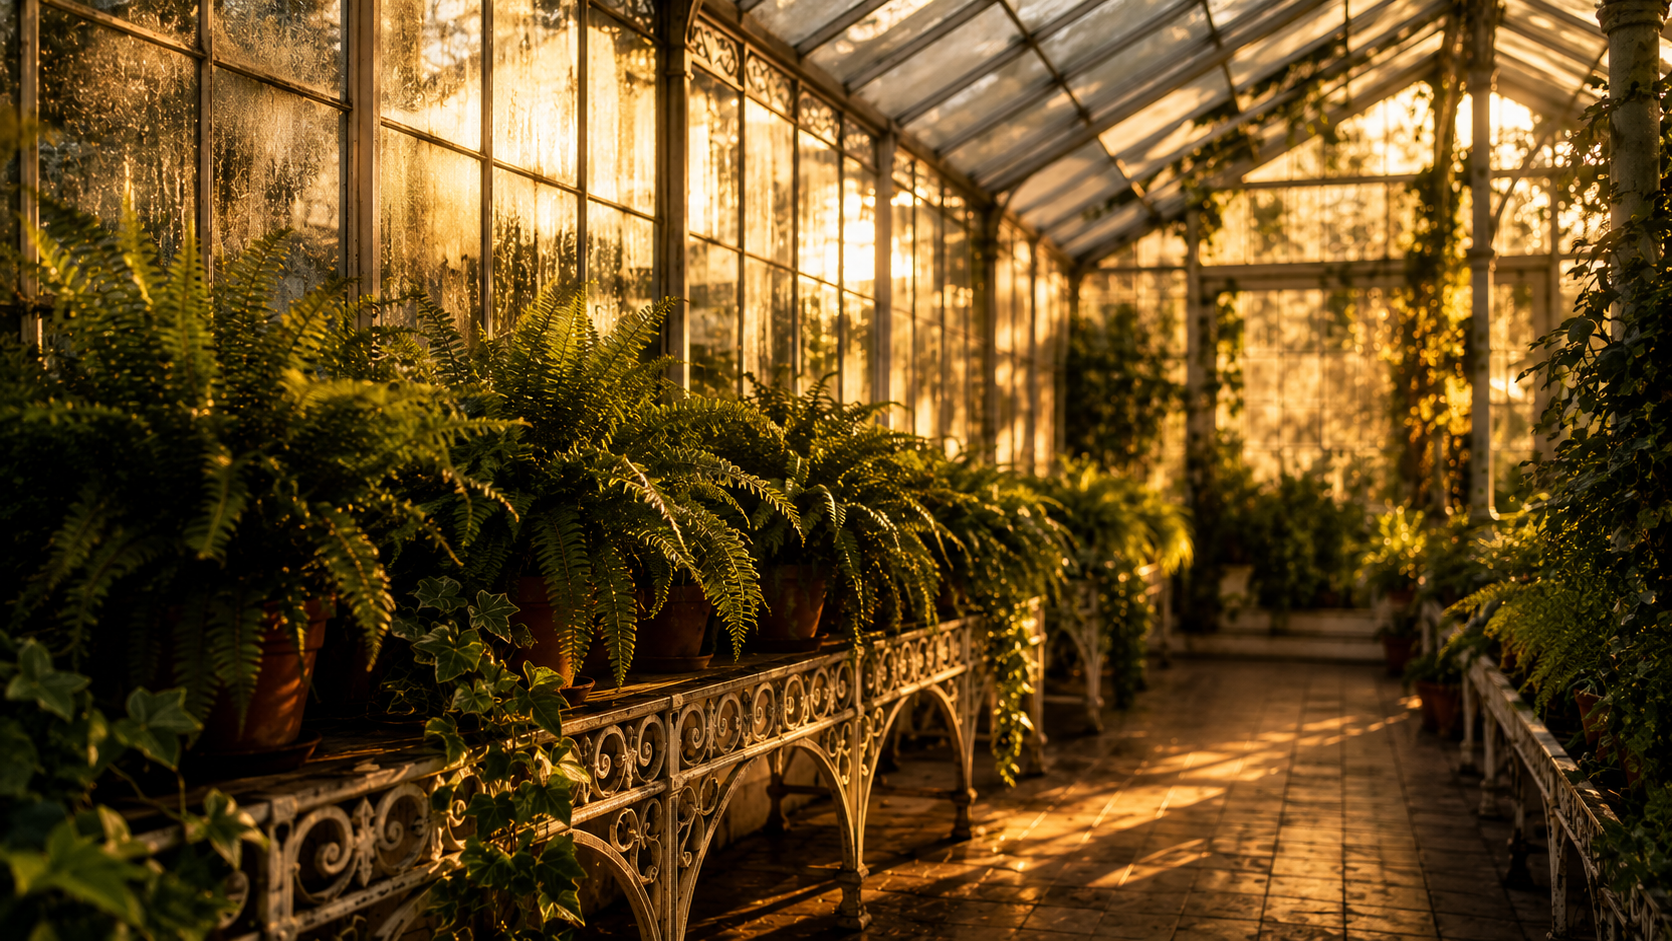
A cinematic still of a glass greenhouse interior at golden hour: long rows of potted ferns and trailing ivy on white iron benches, warm sunlight streaming through dusty glass panes and casting long diagonal shadows across a tiled floor, faint condensation on the windows. Rich green foliage against warm amber light, fine texture in the leaves and glass, shallow depth of field, 16:9 framing, 8K detail, no people, no text overlay.
このプロンプトを「ゴールデンアワー(夕景の暖色光)」で 1 回生成し、さらに「夕暮れ(dusk)」に微調整してもう 1 回生成すれば、レシピ 1 のための完璧な首尾フレーム画像ペアが手に入ります。
なぜ Fanch AI がこのワークフローに適しているのか
ファースト&ラストフレーム 制御の成否は、入力する 2 枚の画像の完成度にかかっており、画像こそがクリエイターが 100% コントロールできる領域です。Fanch AI はプロンプトに忠実な専用画像モデルを提供しているため、同一のレンズ設定、同一のライティング、単一の明確な差分を備えた理想的な開始・終了フレームを低コストで自在に生成し、お好みの動画モデルへとスムーズに受け渡すことができます。