
Blackwell 기반 FLUX 3 Klein: 4.45배 가속 수치에 담긴 진짜 의미 | Fanch AI
NVIDIA 개발자 블로그에 "NVIDIA Blackwell GPU에서 FLUX 3 Image Klein으로 이미지 생성 속도 가속화하기"라는 제목의 글이 게시되었으며, 이를 소개하는 기사들마다 최대 4.45배 가속이라는 수치가 빠지지 않고 등장하고 있습니다. 그러나 벤치마크 원문을 살펴보면 이 측정치는 단일 B200 GPU에서, 그것도 이미지 편집(Inpainting/Editing) 작업을 기준으로 기록된 것입니다.
이 두 가지 전제 조건은 4.45배라는 숫자 자체보다 훨씬 본질적인 의미를 지닙니다. NVFP4는 이러한 가속을 가능하게 한 핵심 기술 메커니즘이며, 그 작동 원리를 이해하면 왜 이 수치가 데이터센터용 장비의 결과물인 동시에 개인용 작업 환경의 미래를 가리키고 있는지 알 수 있습니다.
NVIDIA가 실제로 측정한 것의 실체
해석에 앞서 이번 벤치마크에 대한 세 가지 사실을 명확히 정리할 필요가 있습니다:
NVIDIA가 자사 하드웨어 환경에서 직접 테스트한 결과입니다. 이 테스트는 Blackwell 아키텍처 위에서, NVIDIA가 Blackwell용으로 자체 설계한 양자화 규격을 사용해, NVIDIA가 최적화한 모델을 대상으로 진행되었습니다. 이것이 데이터 조작을 뜻하지는 않지만, 모든 환경 제어권을 가진 주체가 도출해 낸 최상의 시나리오(Best case)라는 점을 감안해야 합니다.
테스트 장비는 단일 B200이었습니다. B200은 데이터센터 전용 가속기입니다. RTX 4070도, 5080도 아니며, 책상 아래 놓인 워크스테이션용 그래픽 카드와는 차원이 다릅니다.
신규 생성이 아닌 '이미지 편집' 작업이었습니다. 4.45배라는 수치는 FLUX 3의 부분 수정 및 편집 파이프라인에서 측정된 값입니다. 이미지 편집과 완전한 텍스트 기반 신규 생성(Text-to-Image)은 연산 요구 프로파일이 다르므로, 단일 배수가 두 작업 모두에 똑같이 적용된다고 단정할 수 없습니다.
따라서 객관적인 사실은 다음과 같습니다: NVFP4 포맷은 NVIDIA의 최고급 엔터프라이즈 하드웨어에서 FLUX 3 Klein의 편집 처리 속도를 비약적으로 끌어올렸습니다. 아래에서는 이 기술이 일반 창작자와 실무진에게 어떤 실질적 의미를 갖는지 살펴봅니다.
NVFP4란 무엇인가
NVFP4는 NVIDIA가 Blackwell 세대를 위해 도입한 4비트 부동소수점(4-bit floating-point) 포맷입니다. 명칭 구조는 직관적입니다. FP4는 모델의 가중치 하나를 4비트로 표현함을 뜻하고, 접두사 NV는 NVIDIA 고유의 독자 변형 규격임을 나타냅니다.
가중치당 4비트라는 수치는 매우 공격적인 압축입니다. 표준 bf16 모델이 가중치당 16비트를 사용하므로, NVFP4는 별도의 추가 기법 없이도 메모리 사용량을 단숨에 4분의 1로 줄여버립니다. 속도 향상은 바로 이 지점에서 출발하며, 이 포맷이 개발된 근본적인 이유이기도 합니다.
단순히 용량을 줄이는 데 그치지 않고 NVFP4를 실무에서 쓸 수 있게 만든 핵심 설계는 다음 두 가지입니다:
블록 단위 스케일링(Block-wise scaling). 가중치를 무작정 4비트로 깎아내리면 텐서 전반에 걸친 큰 편차를 표현할 수 없어 모델 성능이 완전히 붕괴합니다. NVFP4는 가중치를 작은 블록(Block) 단위로 쪼개어 각각 독립적인 스케일링 팩터를 부여합니다. 이것이 바로 '실제로 작동하는 4비트'와 '노이즈 덩어리만 뱉어내는 4비트'를 가르는 결정적 차이입니다.
하드웨어 레벨의 네이티브 연산 지원. NVFP4는 Blackwell 아키텍처의 물리적 실리콘 칩에 네이티브로 각인되어 있습니다. 바로 이 점 때문에 구형 GPU에서는 같은 효과를 낼 수 없습니다. 이 포맷이 빠른 이유는 칩 내부의 연산 유닛이 이를 직접 지원하기 때문이며, 이전 세대 GPU에는 이 물리적 하드웨어가 없습니다.
양자화 계층 사다리 (The Quantization Ladder)
NVFP4는 단독으로 존재하는 규격이 아니라, 모델 압축이라는 사다리의 가장 아래쪽에 위치한 단계입니다. 오픈소스 커뮤니티는 이미 FLUX 3 Klein을 대상으로 다양한 변형 빌드를 배포하고 있으며, NVFP4, FP8, 그리고 W4A16이나 W4A4로 불리는 혼합 양자화 방식들이 공존하고 있습니다.
사다리의 각 단계별 득실은 다음과 같습니다:
bf16 — 완전 정밀도(Full precision). 모든 NVFP4 빌드의 품질을 평가할 때 기준이 되는 마스터 규격입니다. 모델이 낼 수 있는 모든 디테일을 보존하지만, VRAM 점유율이 가장 크고 속도가 가장 느립니다.
FP8 — 8비트. bf16 대비 절반 수준의 메모리만 차지하면서도 통상적인 시각 환경에서는 품질 손실을 거의 감지하기 어렵습니다. 가장 안전하게 성능을 확보할 수 있는 기본 선택지입니다.
NVFP4 — 4비트. bf16 대비 약 25% 수준의 메모리만 사용합니다. 압도적인 속도와 VRAM 절약 효과를 얻을 수 있지만, 결과물의 시각적 결함을 꼼꼼히 점검해야 하는 단계입니다.
W4A16 — 가중치는 4비트, 활성화 값은 16비트. 모델 가중치는 강하게 압축하되 연산 과정의 활성화 값 정밀도는 상대적으로 보존하는 방식입니다. 모든 것을 4비트로 깎는 것보다 품질을 훨씬 안정적으로 지켜냅니다.
W4A4 — 둘 다 4비트. 극한의 압축률을 자랑하지만 품질 저하 위험도 가장 큽니다. VRAM 한계에 부딪힌 특수한 환경이 아니라면 기본 작업용으로는 권장되지 않습니다.
핵심 원리는 분명합니다. 양자화는 단순한 이분법적 선택이 아닙니다. 가중치 정밀도와 활성화 값 정밀도는 서로 다른 축이며, 혼합 포맷이 존재하는 이유는 한쪽을 압축하는 것이 양쪽을 동시에 깎아내는 것보다 화질 손상을 훨씬 덜 유발하기 때문입니다.
양자화 사다리가 존재하는 근본적인 이유
대다수 기술 해설에서 간과하는 지점이자, NVFP4가 미미한 수준을 넘어 약 4배에 달하는 성능 도약을 이끌어낸 진짜 이유가 여기에 있습니다:
확산 기반 이미지 모델은 대개 순수 연산 속도(Compute-bound)가 아니라 **메모리 대역폭(Memory-bandwidth bound)**에 의해 성능이 제한됩니다. 이미지를 하나 생성하려면 수십 번의 디노이징 스텝 동안 거대한 가중치 텐서를 칩 안팎으로 끊임없이 이동시켜야 합니다. 발목을 잡는 것은 연산 처리 자체가 아니라, 메모리에서 연산 유닛으로 데이터를 나르는 병목입니다.
이 사실은 최적화의 정의를 바꿉니다. 시스템이 메모리 데이터 전송을 기다리느라 멈춰 있는 상태라면, 가중치 크기를 4분의 1로 줄여버리는 NVFP4는 병목의 핵심을 정확히 타격합니다. 칩 자체가 마법처럼 빨라진 것이 아니라, 필요한 데이터를 가져오기 위해 멍하니 대기하는 유휴 시간이 극적으로 줄어든 것입니다.
로컬 환경에서 모델 아키텍처를 조금 튜닝하는 것보다 양자화가 훨씬 압도적인 성능 향상을 이끌어내는 이유가 바로 이 물리적 한계 때문입니다.
NVFP4가 유발하는 시각적 품질 손실
NVFP4는 손실 압축이며, 그 품질 저하는 화면 전체에 고르게 퍼지지 않고 특정 시각 영역에 집중됩니다:
미세한 고주파 텍스처. 옷감의 올과 결, 머리카락 한 올, 필름 입자, 피부 모공 등이 해당됩니다. 4비트 압축의 한계는 텍스처에서 가장 먼저 드러나는데, 크기가 작은 미세 신호들이 반올림 연산 과정에서 가장 먼저 날아가기 때문입니다.
작은 크기의 텍스트. 폰트 크기가 작은 글자를 화면 안에 렌더링하려면 높은 정밀도가 필수적입니다. FP8에서는 또렷하게 유지되던 작은 텍스트가 NVFP4에서는 뭉개지거나 판독이 어려워질 수 있습니다.
부드러운 계조 그라데이션. 다이내믹 레인지가 압축되면서 하늘의 미세한 노을 변화나 피부 표면의 부드러운 음영에 계단 현상(Banding)이 관찰될 수 있습니다.
안정적으로 유지되는 요소들. 화면의 전체 구도, 컬러 팔레트, 굵직한 형태, 조명 분위기 등은 정밀도에 크게 좌우되지 않습니다. 따라서 NVFP4 기반 이미지는 언뜻 보았을 때는 완벽해 보이지만, 100% 크기로 확대했을 때 디테일의 차이가 드러납니다.
데이터센터와 데스크톱 PC 사이의 현실적 격차
4.45배라는 수치와 관련해 가장 주의해야 할 점은 그 성능이 내 개인 PC로 그대로 이어지지 않는다는 사실입니다:
Blackwell 칩이 필수적입니다. NVFP4는 하드웨어 네이티브 포맷입니다. Ada Lovelace(RTX 40 시리즈)나 이전 아키텍처에서도 커뮤니티가 변환한 양자화 모델을 돌릴 수는 있지만, 실리콘 수준의 가속 유닛이 없기 때문에 동일한 수준의 가속을 얻을 수 없습니다.
측정 환경이 B200이었습니다. 데이터센터 전용 GPU는 일반 소비자용 그래픽 카드와는 비교할 수 없는 메모리 대역폭을 지니고 있습니다. 기술의 방향성은 공유되지만 배수 수치는 그대로 적용되지 않습니다.
개인용 환경의 목표점은 다릅니다. 커뮤니티에서 FLUX 3 Klein을 8GB VRAM 카드에서 구동했다는 소식은 저정밀도 경량화 모델을 통한 구동 성공을 뜻하며, B200에서의 4.45배 속도 향상과는 완전히 다른 층위의 이야기입니다.
이 벤치마크는 내 컴퓨터의 내일이라기보다 산업 전체가 나아가는 거대한 방향타로 읽는 것이 정확합니다.
내 환경에 맞는 최적의 정밀도 선택법
자신이 처한 물리적 제약 조건으로부터 역산하여 결정하세요:
VRAM이 부족해 모델이 로드조차 되지 않는 경우: NVFP4나 W4A16 빌드로 내려가고 약간의 질감 손실을 수용하세요. 아예 튕기는 것보다는 출력이 나오는 것이 우선입니다.
VRAM은 충분하지만 생성 속도를 높이고 싶은 경우: FP8로 시작하세요. 현존하는 대부분의 하드웨어에서 화질 저하 없이 속도를 챙길 수 있는 가장 안전한 선택지입니다.
최종 상업 납품용 완성도가 필요한 경우: 최종본은 bf16으로 렌더링하고, 초기 구도 탐색과 대량 시안 작업에 NVFP4를 활용하세요. 이러한 2단계 분리 운용이 양자화 기술의 가장 경제적인 활용법입니다.
Blackwell 이전 세대 그래픽 카드를 사용하는 경우: FP8이나 GGUF 빌드가 현실적인 대안입니다. NVFP4의 네이티브 가속은 소프트웨어 패치만으로 해결되지 않습니다.
프로덕션 도입 전 확인해야 할 4가지 검증
실제 작업물로 다음 4가지 포인트를 사전에 점검하세요:
질감 정보가 빽빽한 피사체 테스트. 니트 직물, 무성한 나뭇잎, 흩날리는 머리카락 등은 인물 얼굴보다 NVFP4의 디테일 뭉개짐을 훨씬 빠르게 드러냅니다.
작은 텍스트가 포함된 이미지 테스트. 큼직한 타이틀이 아니라 라벨이나 표지판의 작은 글씨를 확인하세요.
완만한 그라데이션 테스트. 맑은 하늘이나 단색 스튜디오 배경에서 색상 밴딩(줄 생김)이 발생하는지 점검하세요.
동일 프롬프트, 동일 시드(Seed) 기반 1:1 비교. bf16 원본과 테스트할 양자화 버전을 100% 배율에서 비교한 뒤, 최종 배포할 실제 크기로 줄여서 다시 비교해 보세요. 배포 사이즈에서 차이를 구분할 수 없다면 해당 정밀도는 실무에 적합한 것입니다.
직접 확인해보는 테스트 프롬프트
양자화의 한계를 테스트할 때는 질감 표현력을 검증하는 것이 가장 확실합니다:
Fanch AI에 복사하여 붙여넣기 (모델 선택: gpt_image_2):
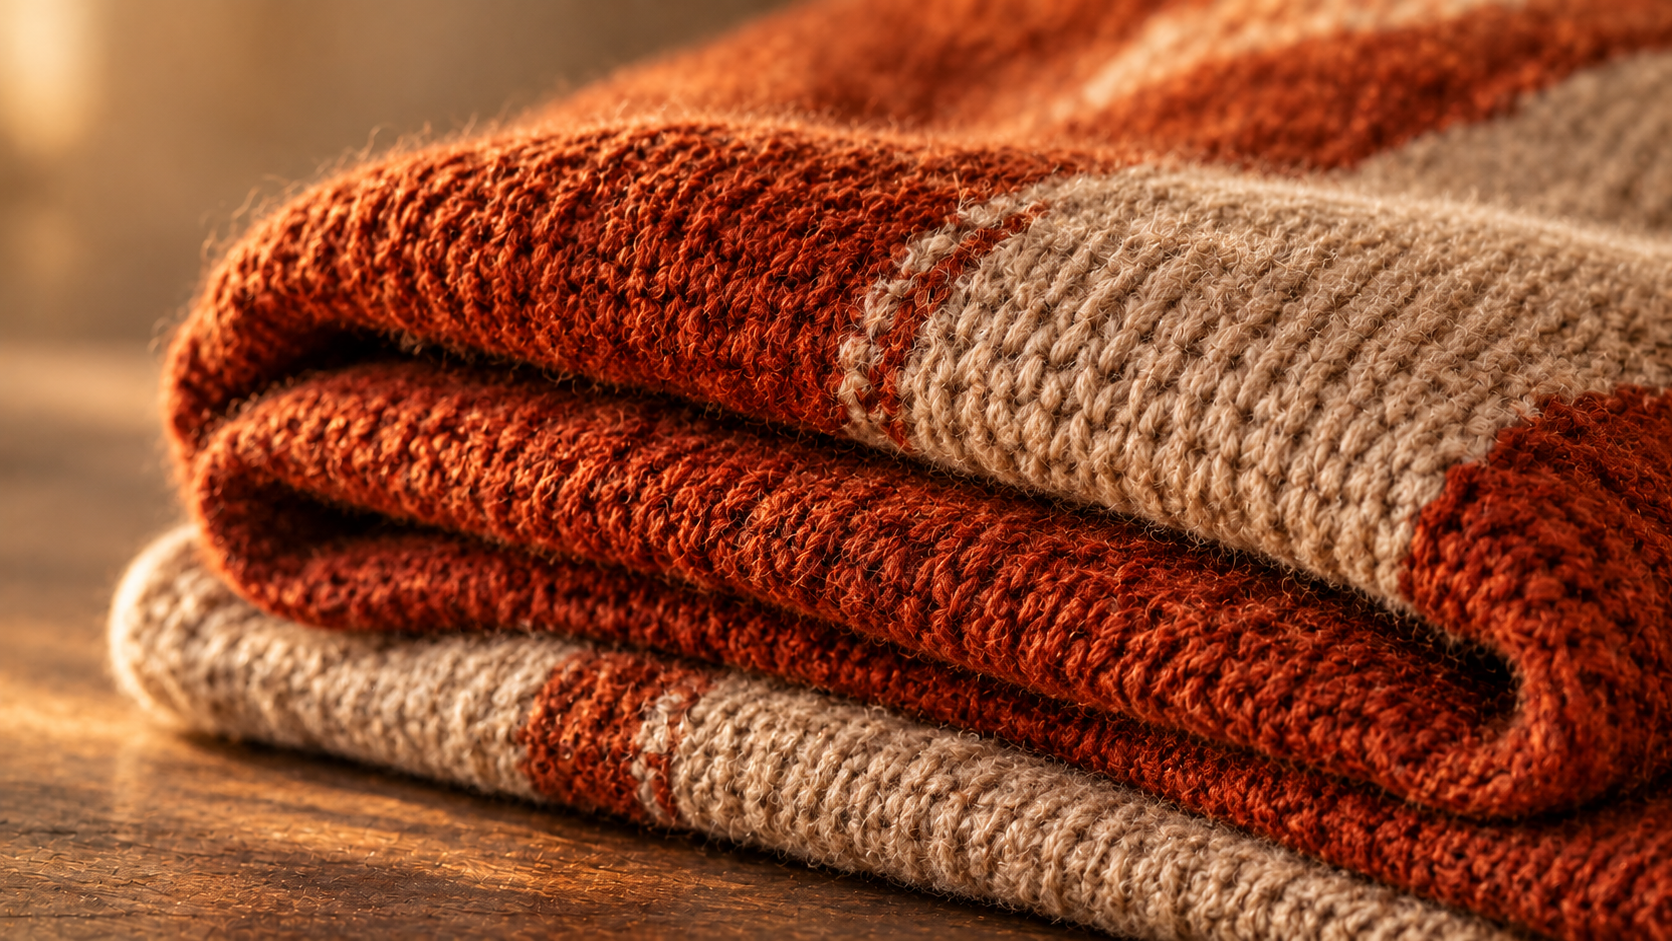
A macro editorial photograph of a folded hand-knit woollen blanket in deep rust and oatmeal tones, stacked in soft uneven layers: individual yarn fibres and small stitches clearly resolved, a few loose fibres catching a low warm side light, subtle fuzz along the folded edges. Extremely fine detail in the knit structure, warm muted palette, shallow depth of field falling off at the frame edges, 16:9 framing, 8K detail, no people, no text overlay.
이 프롬프트를 목표로 하는 정밀도에서 렌더링하고 털실의 올과 짜임새가 선명하게 분리되는지 확인하세요. 뜨개질 코가 뭉개져 페인트처럼 번진다면 그곳이 바로 해당 NVFP4 환경의 품질 한계선입니다.
Fanch AI가 이 워크플로우에 최적인 이유
NVFP4와 양자화 사다리의 본질은 이미지 생성에 드는 전반적인 비용(메모리, 시간, 시도당 비용)을 낮추는 것입니다. 이는 창작자가 마주하는 궁극적인 질문, 즉 "어떻게 하면 부담 없는 비용으로 충분한 시안을 탐색해 완벽한 한 컷을 찾아낼 것인가"에 대한 기술적 응답이기도 합니다.
Fanch AI는 정밀한 프롬프트 제어가 가능한 고성능 이미지 모델 환경을 제공하므로, 로컬 하드웨어 구축이나 메모리 부족에 시달리지 않고도 완벽한 구도, 조명, 색감을 손쉽게 완성할 수 있습니다. 여기서 통제된 레퍼런스 프레임을 먼저 확립한 뒤, 최종 납품을 위한 최적의 파이프라인으로 연결해 보세요.