
7.095 fotos: O número que define o futuro do processo sobre imagens da ByteDance | Fanch AI
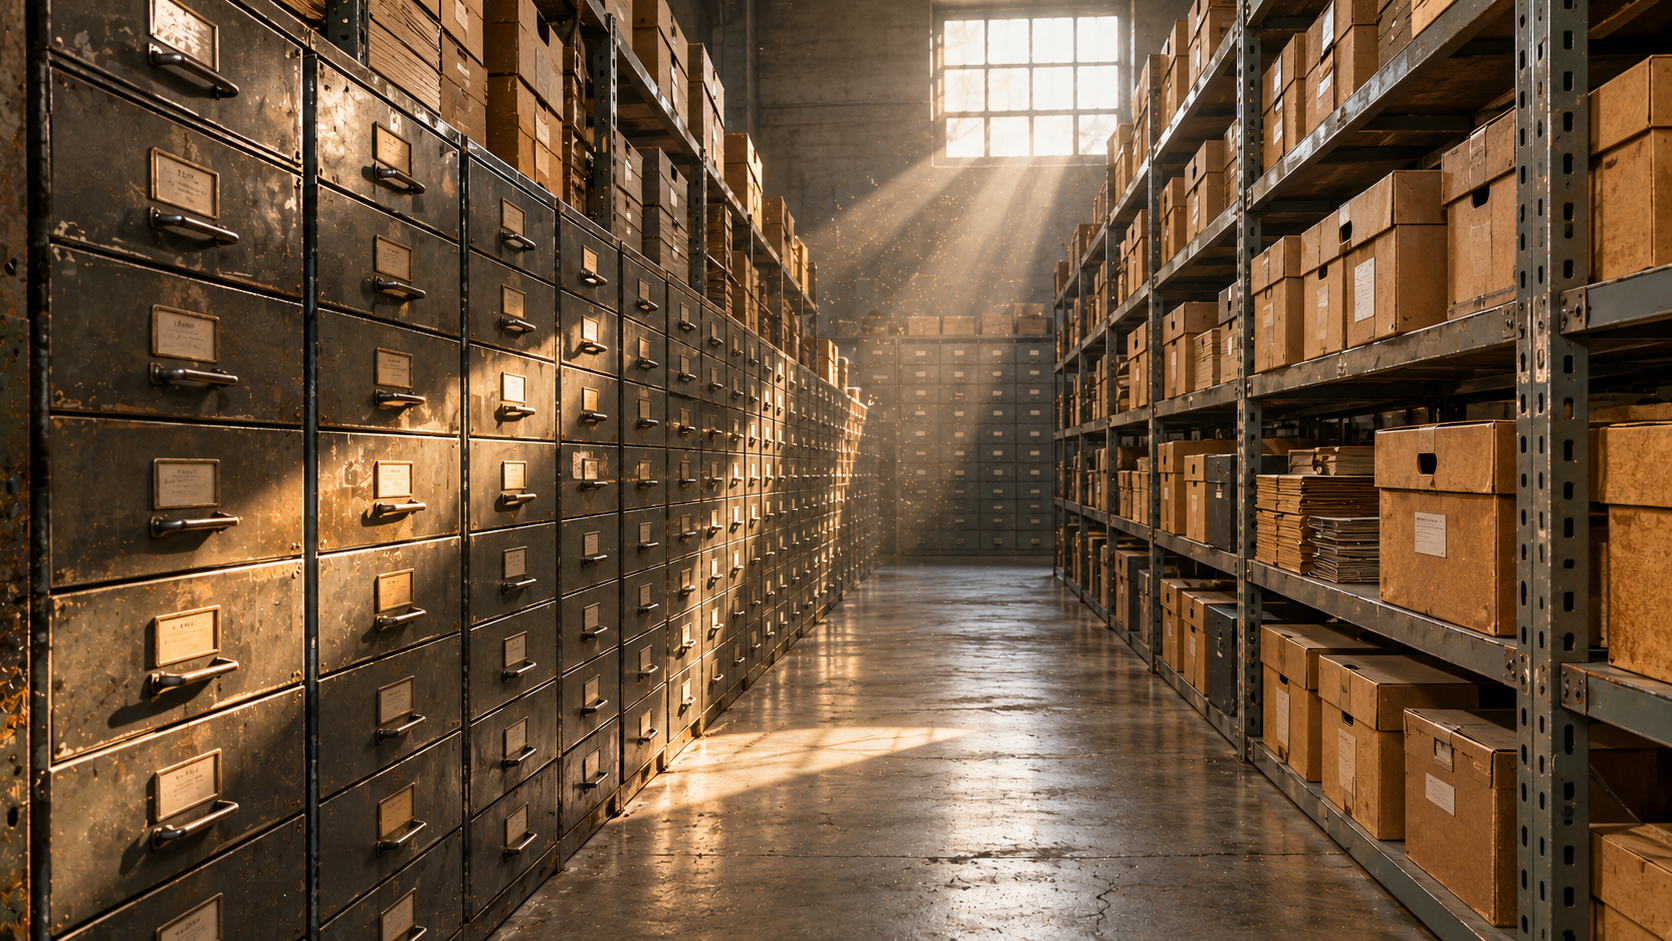
Sete mil e noventa e cinco. Não "milhões de imagens", nem "vastas extensões da internet" — exatamente 7.095 fotografias. É um número preciso o suficiente para soar como a contagem de um inventário, porque é exatamente isso que ele representa.
A agência de fotografia automotiva EVOX Productions processou a ByteDance no Tribunal do Distrito Central da Califórnia, alegando que a empresa controladora do TikTok copiou sem autorização essas 7.095 imagens para usá-las como dados de treinamento de IA (AI training data) em seu gerador de imagens, o Seedream. O caso, EVOX Productions LLC v. Bytedance Inc. et al (processo 5:26-cv-06428), foi noticiado esta semana pelos portais Music Business Worldwide e Digital Music News.
A acusação de uso indevido de material como dados de treinamento de IA já não é novidade; quase todos os processos de direitos autorais contra modelos de IA nos últimos dois anos partem dessa premissa. O que torna este caso um potencial divisor de águas para a indústria é a matemática implacável que sustenta a denúncia.
O que a denúncia alega exatamente
É fundamental manter a precisão jurídica: trata-se de alegações contidas em uma petição inicial que ainda não foi julgada. A ByteDance não foi condenada por nenhuma infração até o momento.
A acusação central: As fotografias automotivas de propriedade da EVOX foram raspadas da web (scraped) e utilizadas como dados de treinamento de IA para o Seedream, o modelo de geração visual da ByteDance.
A escala reivindicada: 7.095 imagens. Uma quantidade minúscula nos padrões da internet, e essa é uma escolha jurídica deliberada: trata-se de um conjunto de arquivos contável e rigorosamente catalogado, em vez de uma massa de dados indeterminada.
A jurisdição: Um tribunal federal da Califórnia. O autor é uma LLC de Delaware, o réu é uma empresa de Delaware, e o foro escolhido é o distrito onde precedentes desse tipo de litígio têm se acumulado.
O estado da jurisprudência: Até o momento, não existe nenhuma decisão definitiva nos Estados Unidos sobre dados de treinamento de IA com essas características específicas. O caso está no início, e o desfecho dependerá da fase de apresentação de provas (discovery), de como o tribunal classificará a natureza das obras e das defesas que a ByteDance ainda apresentará.
Por que uma agência de fotografia de carros é o autor mais perigoso
Este é o ponto crucial para compreender por que a EVOX representa uma ameaça legal muito maior para um laboratório de IA do que um grande jornal ou um banco de imagens genérico.
A fotografia automotiva é, por definição, um catálogo estruturado. E catálogos organizados são o material dos sonhos para a construção de dados de treinamento de IA. Diferentes ângulos de câmera padronizados, anos dos modelos, paletas de cores, detalhes do interior, designs de rodas — o trabalho é sistemático e, acima de tudo, enumerável. Uma empresa como a EVOX sabe com exatidão milimétrica quais ativos possui e consegue apontar a autoria de cada arquivo individual.
Cada imagem é identificável separadamente. Marcas d'água físicas, metadados incorporados (EXIF) e uma consistência absoluta no estilo de iluminação tornam a procedência da imagem facilmente verificável. A comprovação de procedência é justamente o elo mais fraco na maioria das acusações sobre dados de treinamento de IA. O maior obstáculo nesses litígios costuma ser provar de forma conclusiva quais obras específicas foram ingeridas pelo modelo. Uma biblioteca catalogada com marcações visuais consistentes derruba essa barreira técnica.
A padronização permite escalar o pedido de indenização. Milhares de imagens tecnicamente semelhantes, cada uma com seu próprio registro de direitos autorais independente, permitem articular um processo massivo, mas muito fácil de detalhar e auditar — exatamente o oposto de uma editora tentando quantificar o dano sobre um arquivo histórico de textos heterogêneos.
O negócio da EVOX é a venda de licenças. Uma empresa cujo faturamento depende de vender licenças individuais de imagens a concessionárias e plataformas de venda tem um argumento impecável sobre "dano ao mercado" (market harm): seu modelo de receita inteiro é precisamente o que supostamente foi usurpado.
Essa combinação — enumerável, identificável e licenciável — explica por que o autor mais temível em um caso de dados de treinamento de IA se parece menos com um conglomerado de mídia e muito mais com um arquivo fotográfico comercial.
O número que ditará a sentença
Aqui reside o mecanismo jurídico que a maioria da imprensa generalista ignora, e que constitui o verdadeiro campo de batalha.
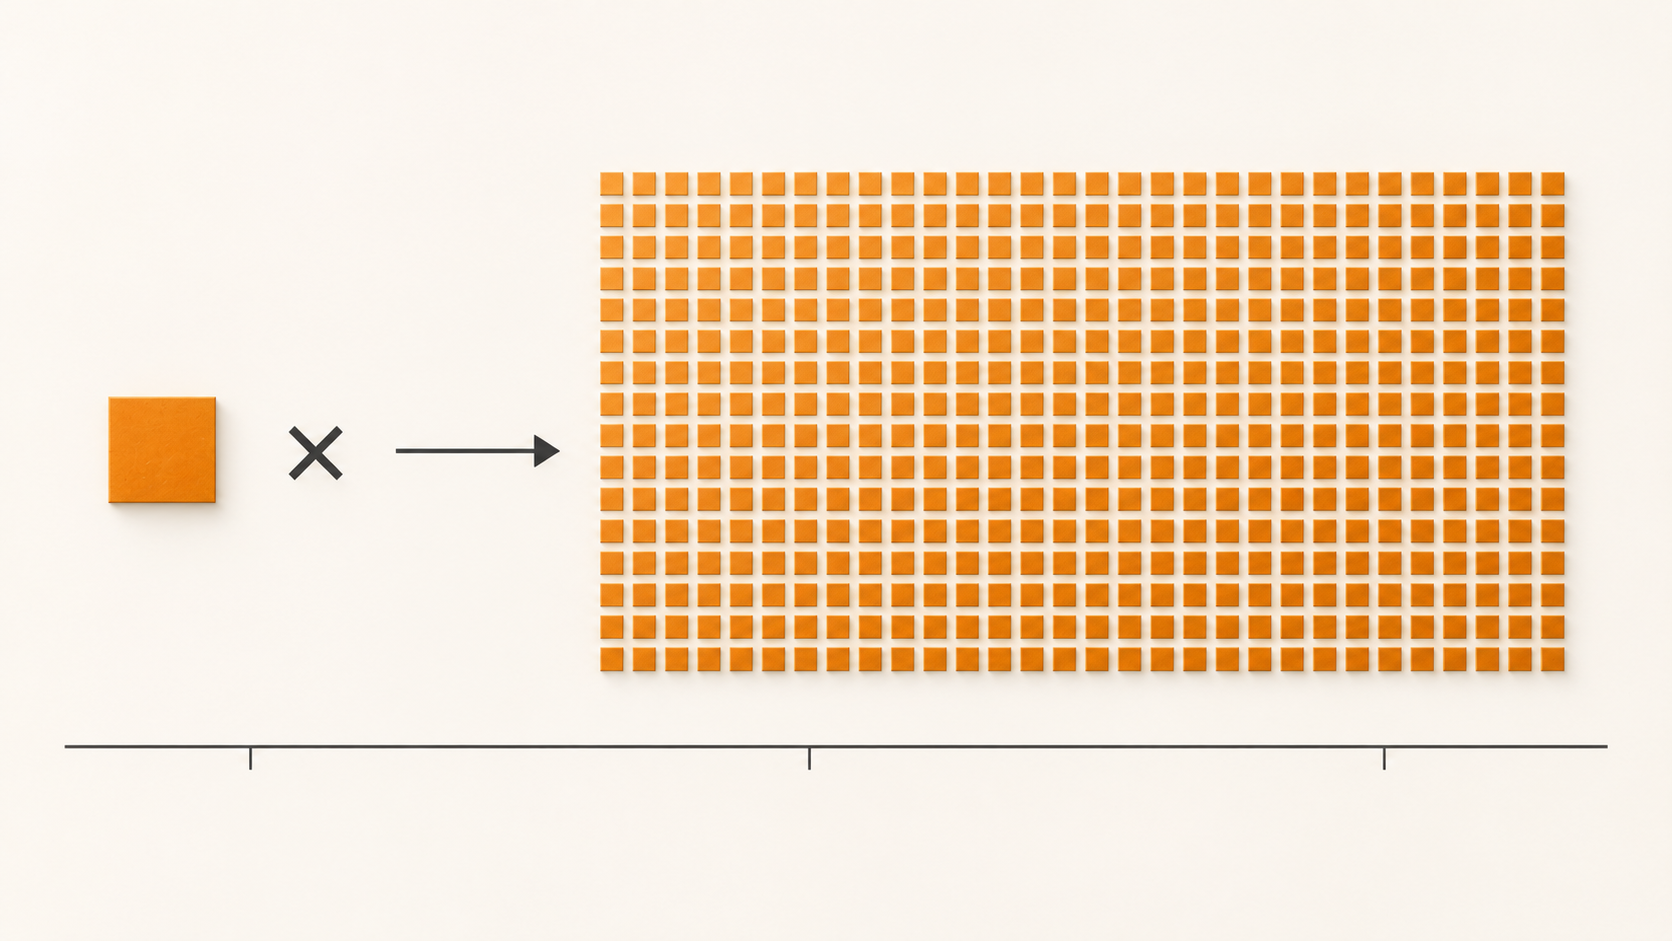
Em litígios de direitos autorais nos Estados Unidos, é extremamente difícil comprovar os "danos reais" (actual damages) econômicos que um modelo de IA causou ao autor. Por isso, os advogados recorrem à figura das indenizações estatutárias (statutory damages). O ponto-chave das indenizações estatutárias é que elas são concedidas por cada obra infringida, e não como um valor global fechado para todo o lote. Portanto, o risco financeiro para o réu não é "quanto dano causei?", mas sim "quantas obras multiplicadas pela faixa legal de indenização?". Em um caso de dados de treinamento de IA, esse multiplicador é tudo.
Isso significa que a questão legal decisiva neste caso sobre dados de treinamento de IA não é se a cópia ocorreu de fato. A pergunta é: cada fotografia conta como uma obra independente e separada?
As petições apresentadas pela EVOX em outros litígios paralelos deixam clara a sua estratégia: argumentam que cada imagem individual é uma obra distinta, com direito à sua própria indenização estatutária. Em um desses casos paralelos, a quantidade de imagens em disputa chega às centenas de milhares. Aplicando essa mesma lógica a este caso de dados de treinamento de IA, mesmo em menor escala (7.095 imagens), se cada uma for considerada uma obra independente, ao multiplicá-las até mesmo por uma indenização modesta por obra, a cifra final ganha proporções punitivas e dissuasórias.
É previsível que a defesa da ByteDance argumente exatamente o oposto: que um catálogo comercial é, na prática, uma única "obra de compilação", ou que o conjunto de imagens deve ser tratado legalmente como uma única "obra coletiva" (collective work), o que limitaria drasticamente a indenização a um pagamento único. É essa disputa sobre a aritmética, e não o ato técnico de raspar dados (scraping), que determinará o valor da condenação.
Para qualquer empresa que baseie seu negócio em compilar dados de treinamento de IA, esta é a frente judicial a ser vigiada de perto. Uma sentença que determine que cada imagem de um dataset massivo é uma obra independente exigindo compensação separada reavaliaria o risco financeiro do scraping de dados de treinamento de IA para toda a indústria de tecnologia da noite para o dia.
A EVOX não é um atirador solitário
Um detalhe fundamental: a EVOX também mantém um litígio ativo contra a Midjourney pelo uso de suas imagens em outro caso paralelo sobre dados de treinamento de IA. Esse fato muda radicalmente a forma de interpretar a presente ação judicial.
Um fotógrafo indignado que processa uma vez levanta uma queixa. O mesmo autor movendo processos idênticos contra múltiplos gigantes da geração de imagens executa uma estratégia corporativa: busca estabelecer um marco teórico, criar precedentes judiciais e forçar acordos extrajudiciais milionários (settlements) ou litigar em bloco contra todo o setor. Os litígios sobre dados de treinamento de IA estão se consolidando exatamente sob esse padrão, com um grupo reduzido de "autores recorrentes" assumindo o peso da ofensiva legal.
A consequência prática é que o caso da ByteDance não será resolvido em um vácuo. As petições e sentenças dos casos paralelos o influenciarão diretamente, e qualquer decisão judicial que valide a tese de indenizar "por obra individual (per work)" será exportada rapidamente para os demais tribunais.
O que isso altera para os modelos generativos de imagem
Se a teoria do autor prosperar nos tribunais, provocará três movimentos tectônicos na indústria:
Os dados de treinamento de IA se tornarão um passivo financeiro quantificável. Uma vez que o multiplicador "por obra" receba respaldo judicial, o tamanho do dataset de um modelo deixará de ser uma vantagem competitiva gratuita para virar um risco econômico que deverá ser contabilizado nos balanços. Isso alterará a forma como os laboratórios de IA encaram a obtenção de dados de treinamento de IA muito mais rápido do que qualquer debate ético faria.
O mercado de licenças de dados de treinamento de IA se tornará real. Se os catálogos extraídos sem permissão carregarem um risco financeiro insuportável, os catálogos legalmente licenciados adquirirão um valor comercial imenso. O mercado transacional de dados de treinamento de IA, que tem sido pura teoria há três anos, receberá finalmente uma sinalização de preços sólida.
A rastreabilidade dos dados de treinamento de IA passará de luxo a escudo defensivo. A capacidade de comprovar de qual fornecedor legal provém cada imagem de treinamento será a diferença entre assumir um custo operacional calculável e enfrentar um risco de falência ilimitado.
O que este processo NÃO muda
É importante ter clareza sobre os limites do litígio, pois a imprensa tenderá a exagerar as consequências.
Este caso sobre dados de treinamento de IA não torna o uso de geradores de imagens ilegal ou inseguro para você como usuário. Trata-se de uma disputa comercial entre o desenvolvedor que treina o modelo e o proprietário dos direitos autorais sobre como os dados de treinamento de IA são obtidos. Nada nesta ação judicial afeta a legalidade de usar um modelo que outra pessoa treinou, e ela não traz implicações legais para quem se limita a escrever prompts.
Também não resolve o espinhoso debate sobre o "uso justo" (fair use). A discussão jurídica sobre se a análise algorítmica de dados de treinamento de IA se enquadra na doutrina do fair use se arrasta há anos sem uma resposta definitiva, e a mera abertura de um processo em um tribunal distrital não encerrará a questão por si só.
Leia as notícias sobre processos com cautela
Quatro ressalvas indispensáveis antes de tirar conclusões precipitadas:
Uma acusação não é uma sentença comprovada. Nenhuma responsabilidade legal foi estabelecida até o momento, e a cifra de 7.095 é um cálculo fornecido exclusivamente pelo autor do processo.
A contagem dos dados de treinamento de IA responde a uma metodologia técnica própria. O número "7.095" reflete o método de software empregado pela EVOX para identificar e corresponder as imagens. O juiz aceitar a validade técnica dessa contagem é uma batalha jurídica à parte.
A teoria de indenizar "por obra individual" é fortemente contestada. É a tese máxima do autor para inflar a sanção, não jurisprudência consolidada.
Casos em fase inicial mudam constantemente. Nesse campo tecnológico, é muito comum que as petições sejam modificadas, acusações sejam retiradas ou as partes firmem acordos extrajudiciais confidenciais (settlements) muito antes do julgamento.
O que isso significa para você como criador visual
Se você se dedica a treinar modelos (Trainers): a rastreabilidade da origem das imagens é agora a linha de frente da sua gestão de riscos. Os dados de treinamento de IA que você introduz no seu sistema são uma rubrica do balanço financeiro, não apenas uma variável técnica.
Se você é proprietário de um banco de imagens (Licensors): seu arquivo acaba de se valorizar. As bibliotecas visuais estruturadas, contabilizáveis e facilmente identificáveis são exatamente a tábua de salvação legal que o mercado de dados de treinamento de IA precisa comprar desesperadamente para provar que sua tecnologia é idônea.
Se você se limita a gerar imagens (Generators): esta guerra não é sua. Continue utilizando os modelos, aprimorando seus prompts e observe de longe como se resolve a questão do pagamento "por obra individual", porque essa conta chegará até você na forma de um aumento no preço da assinatura mensal da sua ferramenta de IA.
Um prompt para ilustrar o contexto do caso
Se deseja criar imagens que capturem o espírito desta notícia, o sujeito honesto da composição não é um robô ou um martelo de juiz, mas o próprio arquivo: a imensa biblioteca física que dá sentido ao negócio dos catálogos de imagens e, em última instância, ao conflito.
Copie e cole no Fanch AI (Modelo: gpt_image_2):
A wide documentary photograph down the aisle of a vast photographic archive: long rows of steel filing drawers receding into dim depth on both sides, cardboard slide boxes stacked on open metal shelves, a single shaft of daylight falling from a high window and catching dust in the air. Fine detail in the brushed steel drawer fronts, worn paper labels and the fibre of the cardboard boxes, cool grey and warm sepia palette, deep perspective, slight vignetting at the frame edges, 16:9 framing, 8K detail, no people, no legible text.
Na indústria de IA atual, um "arquivo fotográfico" é a única imagem cujo valor em milhões de dólares depende exclusivamente da capacidade de comprovar, com exatidão matemática, o que está armazenado lá dentro.
Por que o Fanch AI te protege neste cenário
A batalha legal em torno dos dados de treinamento de IA gira sobre como as grandes corporações de IA extraem e armazenam as bibliotecas de imagens alheias, não sobre se as pessoas devem ou não usar ferramentas criativas. Essa distinção é vital: a exposição legal recai sobre o engenheiro que raspa a web (scraper) para treinar a rede, não sobre o criador que digita um prompt em seu computador.
O Fanch AI coloca à sua disposição modelos de geração de imagem avançados aos quais você comanda com prompts de alta precisão, permitindo gerar o material visual de que necessita diretamente da sua descrição criativa e não depender de garimpar em catálogos de stock de terceiros. Isso assegura que sua obra, suas ideias e seus direitos de uso se mantenham limpos e claramente definidos sob a sua própria autoria.