
Geração Local de Imagens por IA: O que a sua GPU Realmente Custa | Fanch AI
O apelo da geração local de imagens por IA (local AI image generation) é quase irresistível: como a placa de vídeo já está instalada no seu computador, o custo marginal de gerar uma imagem adicional parece ser zero. Um artigo muito compartilhado do XDA abordou o tema exatamente por esse ângulo — pesquisa, programação e geração visual rodando em uma única GPU doméstica já amortizada, sem qualquer assinatura mensal associada.
Essa leitura é tão verdadeira quanto incompleta. A geração local de imagens por IA de fato oferece um custo marginal por imagem próximo de zero. Contudo, ela cobra uma fatura em três moedas que nunca aparecem nas manchetes: consumo de energia elétrica, horas de manutenção técnica e perda de fidelidade no resultado final.
Abaixo, detalhamos como essa infraestrutura local realmente opera, quanto custa na prática e quais são as tarefas específicas nas quais a geração local de imagens por IA vence com folga.
Como funciona uma estrutura auto-hospedada
A configuração descrita naquele artigo não é uma simples pasta de scripts desconexos. Trata-se de uma aplicação integrada baseada no Pixeltable, conectando modelos dedicados para finalidades distintas: um modelo visual aberto para a criação de imagens, um modelo especializado em código e um modelo MoE (mistura de especialistas) encarregado de pesquisas estruturadas.
A configuração de hardware que se tornou padrão de referência para a geração local de imagens por IA é uma RTX 4070 Ti Super de 16GB, executando FLUX para geração visual e Qwen para desenvolvimento de software. Estamos falando de uma placa de vídeo intermediária para jogos, e não de uma estação de trabalho para data centers. A barreira de entrada para a geração local de imagens por IA caiu para o nível de "uma placa de vídeo que você talvez já tenha no gabinete".
O ponto forte dessa montagem está na integração. A maioria das pessoas que tenta rodar IA localmente acaba isolada em três programas diferentes sem comunicação de dados. Reunir geração de imagens, assistência de código e busca contextual em um único fluxo é um avanço de produtividade operacional, e não um mérito isolado do hardware.
Por que dizer que a GPU já paga torna tudo gratuito é uma meia-verdade
A lógica financeira da geração local de imagens por IA baseia-se em um princípio clássico: custos irrecuperáveis (sunk costs) pertencem ao passado. Se a GPU já está instalada na sua máquina para rodar jogos pesados ou renderizar vídeos profissionais, o custo adicional de usá-la para gerar imagens resume-se estritamente à eletricidade consumida.
Faça as contas com o seu equipamento: consulte o consumo em watts da placa sob estresse máximo (cerca de 300W para esse patamar). Uma hora de trabalho ininterrupto consome 0,3 kWh. A um custo médio de R$ 0,80 a R$ 1,20 por kWh, o gasto fica em torno de alguns centavos por hora. Dependendo da resolução e do número de passos configurados, uma hora de geração local de imagens por IA consegue produzir mais arquivos visuais do que um mês inteiro de consumo moderado em APIs pagas.
Esse é um benefício financeiro legítimo e explica por que tanta gente decide montar seu próprio ambiente. No entanto, é apenas uma das linhas do balanço operacional.
Os três custos ocultos que ninguém menciona
Seu tempo de trabalho. Operar uma infraestrutura de geração local de imagens por IA exige manutenção contínua. Checkpoints recebem atualizações que quebram fluxos anteriores, nós customizados do ComfyUI entram em conflito, drivers de vídeo sofrem regressões e bibliotecas do Python param de inicializar sem motivo aparente. Se você encara resolver incompatibilidades como hobby, o aprendizado compensa; se você precisa entregar imagens com prazos comerciais apertados, isso se transforma em um plantão técnico não remunerado.
A perda de qualidade visual. Esta é a constatação mais honesta sobre a geração local de imagens por IA. Os modelos proprietários de ponta em nuvem continuam entregando resultados nitidamente superiores em microtexturas, renderização de tipografia pequena e coerência anatômica complexa. Rodar modelos localmente em uma placa de 16GB exige versões quantizadas (quantized), e a quantização reduz exatamente esses detalhes mais refinados.
Ausência de garantias de estabilidade (SLA). Quando um serviço em nuvem sai do ar, equipes especializadas cuidam da restauração. A sua instalação local para no momento em que a placa sofre sobreaquecimento ou uma atualização acidental do sistema quebra as dependências do ambiente virtual.
Dificuldade de uso compartilhado. No instante em que uma segunda pessoa da equipe precisa gerar imagens, sua máquina precisa virar um servidor compartilhado, o que traz todas as dores de cabeça de gerenciamento de rede e suporte — com você assumindo todo o suporte.
Quando a geração local de imagens por IA vence com folga
Em quatro situações práticas, assumir o trabalho de rodar tudo em casa vale muito a pena:
Grandes volumes de experimentação. Com o computador ligado, a geração local de imagens por IA é limitada apenas pela sua paciência, não pela fatura do cartão. É possível deixar o sistema gerando centenas de variações durante a madrugada com custo previsível.
Sigilo absoluto de dados. Imagens, rascunhos e prompts que não podem trafegar na internet sob hipótese alguma. Em projetos corporativos protegidos por acordos de confidencialidade (NDA), a geração local de imagens por IA elimina de imediato qualquer questionamento de conformidade.
Fixação de identidade visual própria. Realizar o ajuste fino (fine-tuning / LoRA) de um modelo aberto a partir do seu próprio portfólio cria uma consistência estilística que nenhum comando de texto consegue alcançar em modelos generalistas. Esse é o argumento técnico mais sólido a favor do ambiente local.
Liberdade em relação a bloqueios automáticos. Se seus prompts de trabalho legítimos são frequentemente bloqueados pelos filtros de conteúdo de plataformas comerciais, rodar um modelo próprio resolve o problema. A geração local de imagens por IA não impõe moderação prévia — o que garante liberdade artística total e exige, consequentemente, responsabilidade jurídica integral de quem opera.
Quando o ambiente local não compensa
Seja igualmente realista em relação às limitações:
Se o seu trabalho exige a melhor textura de pele possível, palavras em corpos pequenos perfeitamente legíveis ou anatomia impecável sem retrabalho manual, os modelos de fronteira hospedados em nuvem continuam superiores. Se você precisa que vários membros de uma equipe acessem a ferramenta pelo navegador sem qualquer atrito técnico, você precisa de uma solução SaaS. E se você gera imagens apenas esporadicamente, a economia de luz nunca compensará as horas gastas instalando pacotes e configurando drivers.
O enquadramento correto é direto: a geração local de imagens por IA serve para volume, sigilo e customização extrema; as ferramentas em nuvem servem para praticidade imediata, acabamento no estado da arte e operação sem manutenção.
A barreira real dos 16GB de VRAM
Dezesseis gigabytes de memória de vídeo representam uma trava física que delimita rigorosamente o que o seu computador de geração local de imagens por IA consegue entregar.
Esse volume de VRAM comporta perfeitamente um modelo visual aberto com quantização moderada. No entanto, não comporta modelos de linguagem avançados (como os MoE) em precisão cheia: você será forçado a utilizar versões comprimidas cujas falhas analíticas são perceptíveis. Além disso, a geração de vídeos com IA em 16GB continua sendo um processo lento e experimental, distante de um fluxo profissional contínuo.
Portanto, uma GPU de 16GB é uma excelente máquina para geração local de imagens por IA, mas um equipamento severamente limitado para as demais vertentes pesadas de IA generativa. Se a criação de imagens representa 80% do seu trabalho, o investimento faz sentido; se representa apenas 20%, você estará abrindo mão de desempenho na maior parte das suas demandas.
Roteiro prático para começar sem desperdício
1. Comece exclusivamente com geração de imagens. Não tente integrar fluxos multifuncionais até que o motor de imagens esteja gerando arquivos com total estabilidade. Um modelo, uma interface limpa e uma pasta de saída.
2. Teste níveis de quantização com atenção. Processe o mesmo comando em dois níveis de precisão distintos. A comparação visual indicará o teto de qualidade que a sua placa consegue entregar para fins comerciais.
3. Monitore as horas de instalação. Não meça apenas o tempo que a placa leva para renderizar, mas registre as horas que você passa resolvendo incompatibilidades de código. Esse tempo compõe o seu verdadeiro investimento inicial.
4. Mantenha uma ferramenta em nuvem de retaguarda. Use a geração local de imagens por IA para rascunhar em grande escala e recorra a um modelo comercial hospedado quando o cliente exigir um arquivo final com acabamento impecável. Esse modelo híbrido é o que melhor funciona no mercado.
5. Reavalie suas opções a cada semestre. O ecossistema de código aberto avança a passos largos e a diferença de acabamento para os modelos comerciais diminui rapidamente. O cálculo de custo que você fizer hoje não será o mesmo daqui a seis meses.
Um prompt para testar o seu computador
Antes de comprometer o seu tempo configurando ambientes locais, avalie se o modelo pretendido domina os temas que você realmente comercializa. Cenas de natureza-morta colocam a física da luz e a qualidade das superfícies à prova de imediato:
Copie e cole no Fanch AI (Modelo: gpt_image_2):
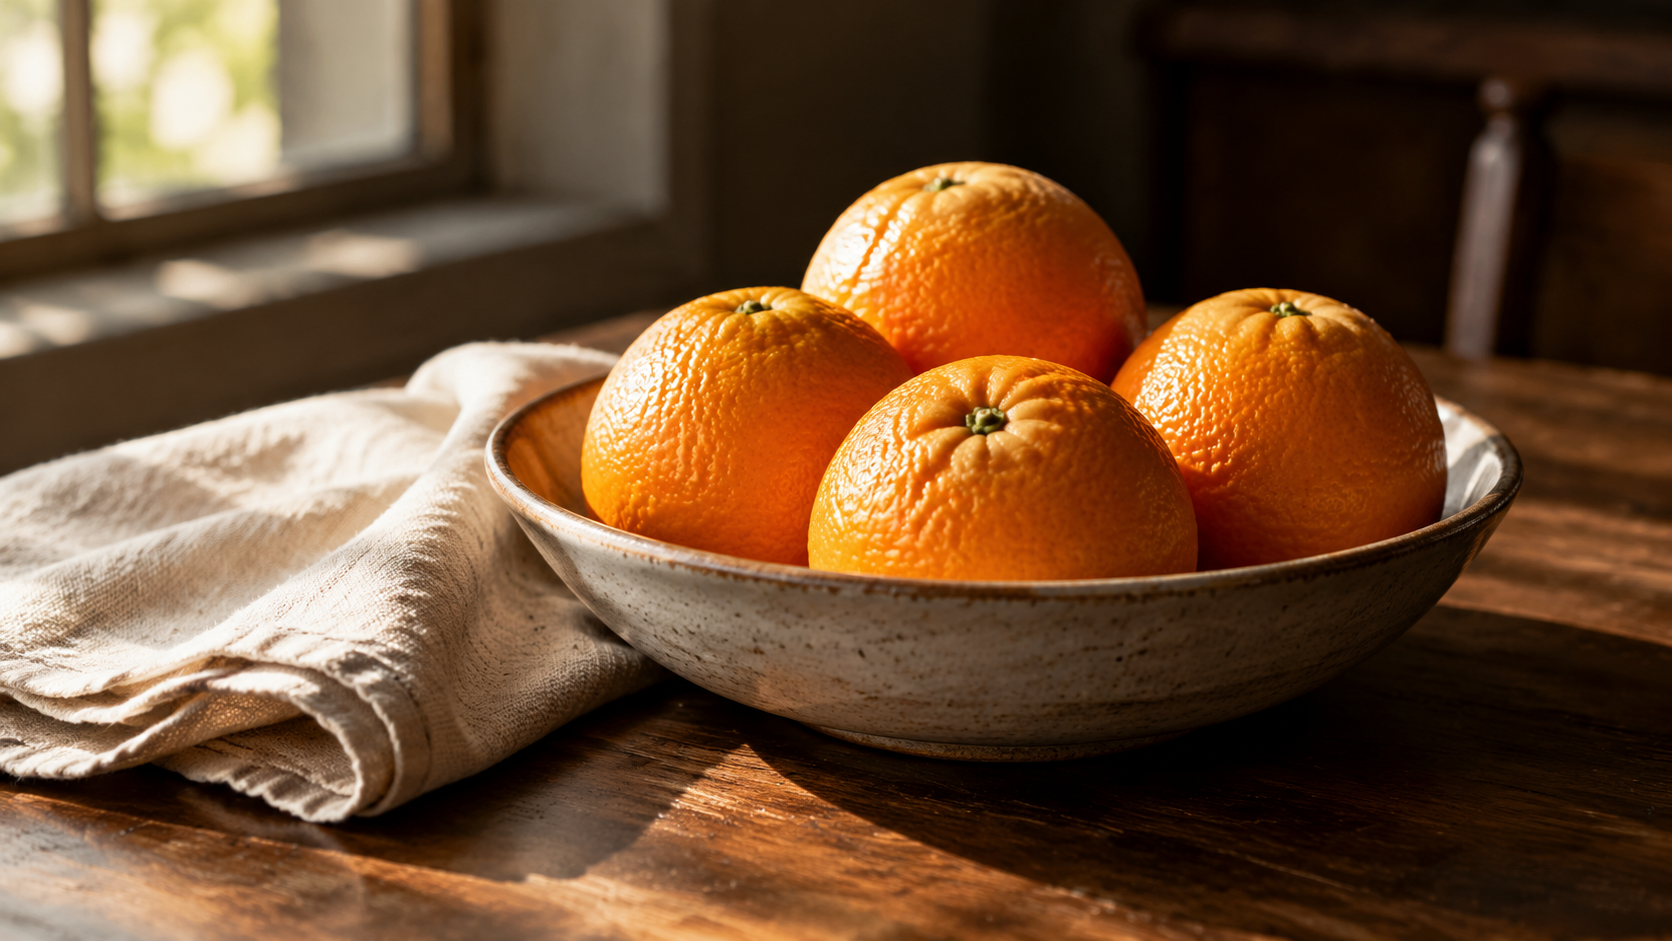
A moody editorial still life on a dark walnut table: a shallow ceramic bowl holding four ripe oranges, a folded linen napkin beside it, soft window light from the left falling across the fruit, deep shadows in the background. Visible texture in the orange peel and the ceramic glaze, muted warm palette, shallow depth of field, fine film grain, 16:9 framing, 8K detail, no text overlay.
Execute este mesmo prompt na sua máquina com geração local de imagens por IA. Essa comparação lado a lado é o único teste prático que realmente importa para decidir o seu fluxo de trabalho.
Como o Fanch AI se integra a esse fluxo
A geração local de imagens por IA é fantástica para volume de testes, proteção de dados e modelos customizados, mas não é a via mais rápida quando você precisa entregar um resultado impecável sem perda de tempo. A maioria dos profissionais opta por um fluxo misto: definir o enquadramento e a direção de arte em um ambiente ágil e acessível antes de escalar o trabalho.
O Fanch AI disponibiliza um modelo de imagem dedicado e de alta precisão via prompt, permitindo travar iluminação, enquadramento e paleta de cores para que você possa, depois, reproduzir as ideias aprovadas com segurança no seu próprio computador.