
首尾帧控制:彻底终结 AI 视频崩坏漂移的核心设置 | Fanch AI
首尾帧(first and last frame) 控制是 AI 视频领域中最被低估、也最少被充分利用的核心设置。绝大多数人写下一段极其优美的提示词,生成了 8 秒视频,却发现画面随着运镜悄然崩坏漂移——人脸逐渐变形、房间摆设擅自重构、光影无缘无故地跳动。
出现这种情况是因为视频生成模型本质上没有长期记忆。它渲染的每一帧,都只是基于上一帧进行的一场全新猜想。微小的误差不断复合累加,到了第 8 秒,呈现在你眼前的已经完全是另一个场景。
首尾帧 控制从底层根治了这一顽疾。你明确指定镜头的起始画面与最终落脚点,模型的任务便从无中生有的“虚构猜想”转变成了严丝合缝的“运动插值(Interpolation)”。这是一份教你正确使用首尾帧的实战指南——涵盖设置参数、构图法则、五套即用配方,以及常见翻车误区。
为什么 AI 视频总会崩坏漂移
在解决问题之前,必须先看透崩坏的本质机理。
画面帧是猜出来的,不是记出来的。 文生视频模型并不会在大脑中持久维持一个三维场景。它生成每一帧的唯一约束,仅仅是“这一帧应当接续上一帧”。这种约束极其松散;而在长镜头中,松散的约束必然导致画面漂移。
身份特征衰减最快。 人脸与微观纹理是漂移最先暴露的地方,因为它们承载着每个像素最高密度的信息量——这正是高质量首尾帧成对出现时价值最大的地方。墙壁纹理损失 20% 的保真度通常难以察觉;但同样程度的衰减出现在人脸上,就会立刻引发强烈的恐怖谷效应。
运镜速度既能掩盖也能放大缺陷。 缓慢的推拉运镜给了模型累加误差的时间;过快的运镜则会牺牲画面细节。无论哪种情况,缺乏首尾帧控制,画面漂移都无可避免。
你无法单靠优化提示词来彻底消除这种漂移,因为提示词是一成不变的常量,而误差却是随时间指数级累加的变量。但你可以强制约束画面的两个端点,这正是首尾帧的真正价值,也是该功能被研发出来的根本意义。
首尾帧控制究竟在做什么
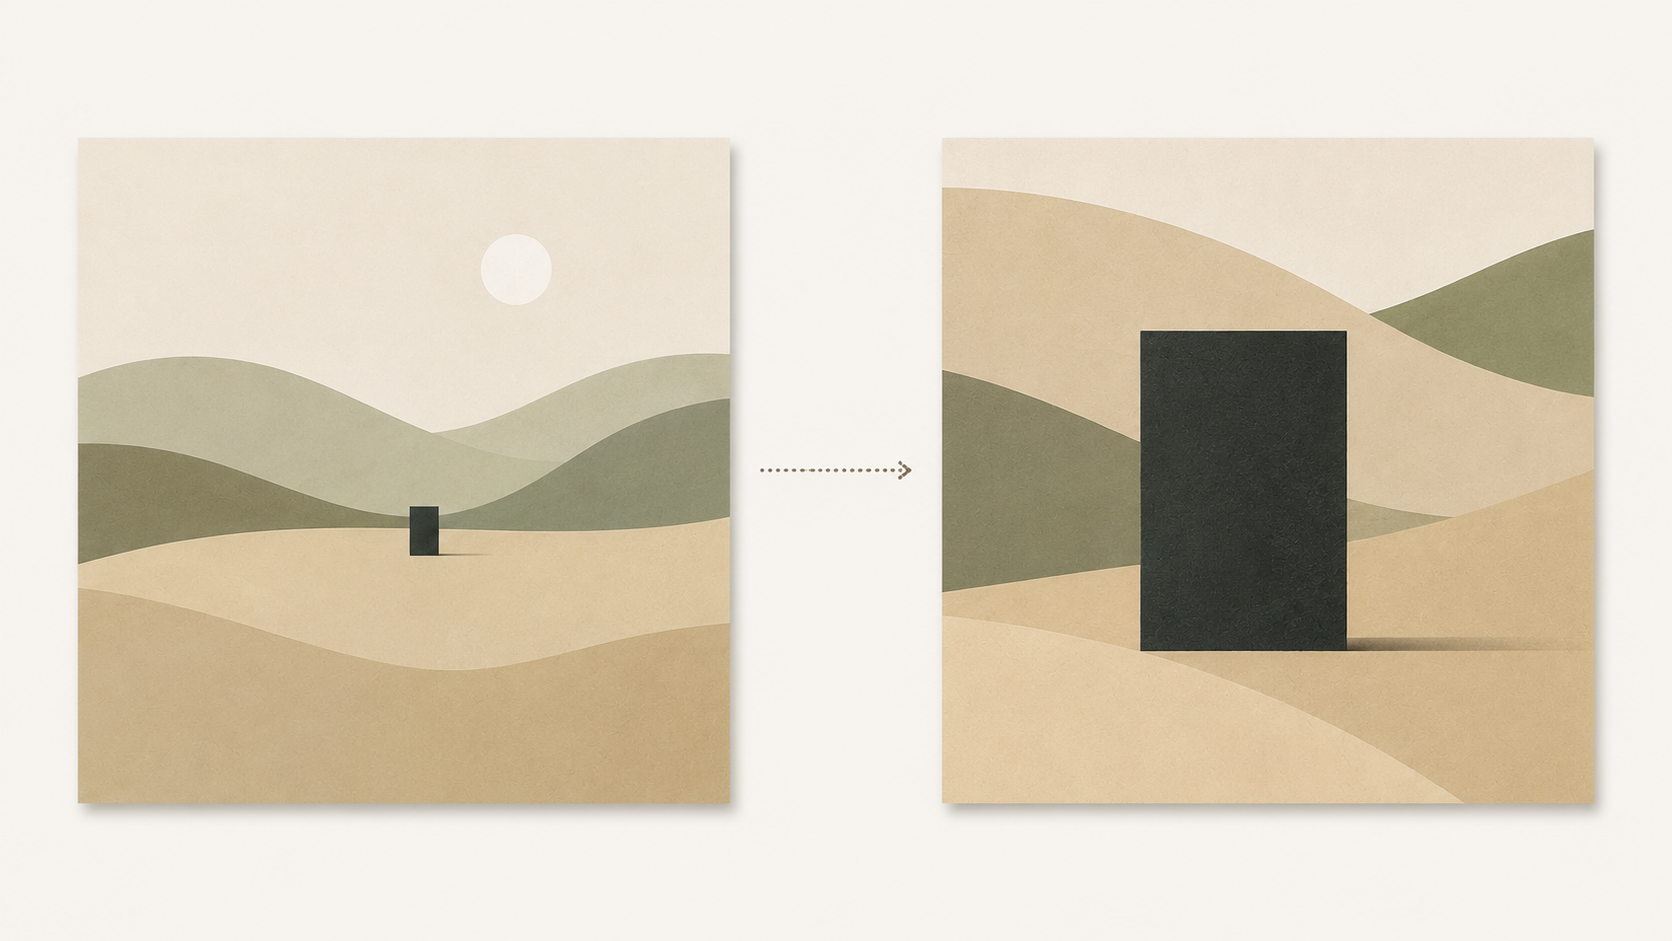
首尾帧 控制接收两张图像——开篇起始帧与收尾结束帧——并在它们之间计算生成连贯的动态轨迹。
这带来了三重根本性的质变,也是彻底改变出片质量的原因所在:
将“凭空猜想”转变为“定向插值”。 没有首尾帧时,模型思考的是“接下来会发生什么?”;有了首尾帧,模型思考的则是“我如何从起点平滑过渡到终点?”后者的解题空间拥有明确的物理边界,这正是首尾帧视频能够稳定维持结构的原因。
赋予画面双重锚点,而非单点依赖。 单纯依托一张起始图片,误差依然会随着时间无限发散。加入结束帧则强制模型在结尾处收敛收拢,因此中途出现的任何微小漂移都会在最终画面前被强行纠正。
确保商业镜头具备交付确定性。 客户往往要求在特定的时间节点展现特定的产品形态。首尾帧 是确保这一关键画面百分之百如期呈现的唯一手段。
首尾帧 无法做到的事:它并不能无条件保证中间过渡段的完美。它只负责约束首尾端点,而两点之间的运动路径依然由模型自行决定。
哪些主流模型支持该设置
各家工具的支持情况各异,且每个版本都在迭代更新,因此请以你正在使用的工具实际功能为准:
Kling 4.0 支持多关键帧插入而不仅限于首尾两帧,其图生视频接口允许显式指定关键帧。这在需要多段节奏变奏的复杂镜头中极为有用。
Veo 3.1 在 Gemini API 中直接开放了首帧与尾帧的控制参数。
Seedance 2.5 在支持海量参考图的同时,深度整合了首尾帧控制能力。
Wan 以及阿里的 Model Studio 视频套件完整支持图生视频与首尾帧条件控制。
版本号会不断向前演进,但底层原则恒定不变:只要一款工具允许你同时输入两张基准图片,它就具备执行首尾帧插值的能力。
保证出片成功的五大构图法则
绝大多数首尾帧生成的失败,早在点击生成前就注定了——问题出在图片准备阶段。
1. 保持完全相同的光影与时段。 如果起始帧是阴天漫射光,而结束帧是黄昏逆光,模型就会在镜头正中间生硬地叠化出一场黄昏日落。请务必统一光线逻辑。
2. 保持相同的镜头焦段与构图语系。 大全景起始、极特写结束是一对合法的首尾帧组合,但前提是你必须在提示词中明确要求“向前推镜”。如果你在没有运镜指示的情况下强行组合全景与特写,模型只会生成一段怪异的人体形变融合(Morph)。
3. 运动物理位移必须符合常理。 在 8 秒钟的时长内,人物可以穿过一间客厅,但绝不可能横跨一座城市。位移跨度过大的首尾帧只会产生严重的画面抽搐与加速撕裂。
4. 为运动留出合理的差异空间。 选用两张几乎完全相同的图片是新手最常犯的错误——模型找不到任何需要插值的运动量,最终只会输出一段僵硬甚至静止的死帧。首尾帧 之间需要存在肉眼可辨的明确变化。
5. 亲自生成高质量的高清底图。 你的首尾帧图片必须是构图完整的高清静止大片。使用低分辨率截图作为输入,得到的必然也是满屏噪点的劣质视频。
5 套高成功率首尾帧实战配方
每套配方均由一组首尾基准图加上中间的运镜提示词构成。提示词应当专门描述“运动本身”,而不是复述“场景内容”——因为场景信息早已蕴含在你的图片中了。
1. 时间流逝转场 (Time passing)
基准图:同一处自然风光在正午时分与蓝调时刻的对比图。
Slow, steady time-lapse transition: the light across the valley shifts from warm midday to cool blue dusk, shadows lengthening and stretching as the sun drops, thin clouds drifting slowly overhead. Camera locked off, no subject movement, gentle exposure change.
2. 无缝换装变身 (Wardrobe change)
基准图:同一位成年人、完全相同的站姿、身着两套不同服装。
A seamless in-camera transition: the subject stands still as warm light sweeps across the frame from left to right, and the clothing resolves into the second outfit without any cut. Camera locked, only the light and the fabric change.
3. 焦点推进特写 (The push in)
基准图:房间的全景大图,紧接着是该房间内某个特定摆件的微距特写。
A slow, smooth dolly push from the wide position toward the detail, maintaining the same focal length, moving in a single continuous take. No zoom, no reframing, no cuts.
4. 商业产品开箱 (Product reveal)
基准图:一个紧闭的包装礼盒,紧接着是该礼盒开启并展示内部产品的状态。
A continuous product shot: the lid lifts and swings back on its hinge in one smooth motion, warm key light following the opening, soft shadow shifting across the surface. Camera slowly orbits a few degrees.
5. 街头人影浮现 (The empty-then-occupied street)
基准图:一条空无一人的街道,紧接着是同一条街道远方出现了一位孤单人影。
A locked-off shot: a lone figure in a long coat walks slowly in from the far end of the street, growing from a small silhouetted shape into a clear figure, mist drifting across the frame throughout. No camera movement.
为什么首尾帧有时依然会翻车
首尾帧 出现失误通常对应以下四种诱因,每一种都有明确的对策:
图片过于相似 → 画面静止不前。 如果两张图的差异极小,输出结果会退化为带有微弱震动的静止幻灯片。对策:适度拉开动作或空间位移的跨度。
图片差异过大 → 画面异化叠化。 如果两张图完全缺乏视觉连贯性,模型无法找到运动轨迹,只能退而求其次执行渐变交叉溶解(Crossfade)——特征就是画面中所有元素同时融化崩解。对策:拉近构图景别与光影基调。
提示词节外生枝描述了第三个场景。 这是最普遍的误区。切勿在动态提示词中喋喋不休地重新描述主体和环境细节;模型早就从你的首尾图中读懂了这些。对策:只描述两张图之间“正在发生的变化”。
视频时长无法匹配位移距离。 试图在 4 秒的超短时间内跨越巨大的物理空间,画面必然产生跳帧感。对策:给复杂的运动留出足够的时间。
穿透两帧之间的提示词公式
一句话总结法则:多描述动词,少描述名词。
当你启用了首尾帧控制,你的两张图片已经给出了“谁、是什么、在哪里、处于何时”的全部答案。此时中间的提示词只需专注回答“如何发生”:相机的移动轨迹、画面变化的朝向与速率、哪些物体必须坚决保持静止。
这正是为什么上述实战配方的字数只有常规文生视频提示词的一半。首尾帧 已经替你承担了绝大部分结构定义,在提示词中过度堆砌名词反而会与你的参考图片打架。
值得亲测的基准提示词
准备合格的基准图片是关键,而一张光影均匀、构图考究的参考图能够成倍提升首尾帧的成功率。建议在能够精准响应提示词的图像大模型上打造它们:
复制并粘贴至 Fanch AI(模型选择:gpt_image_2):
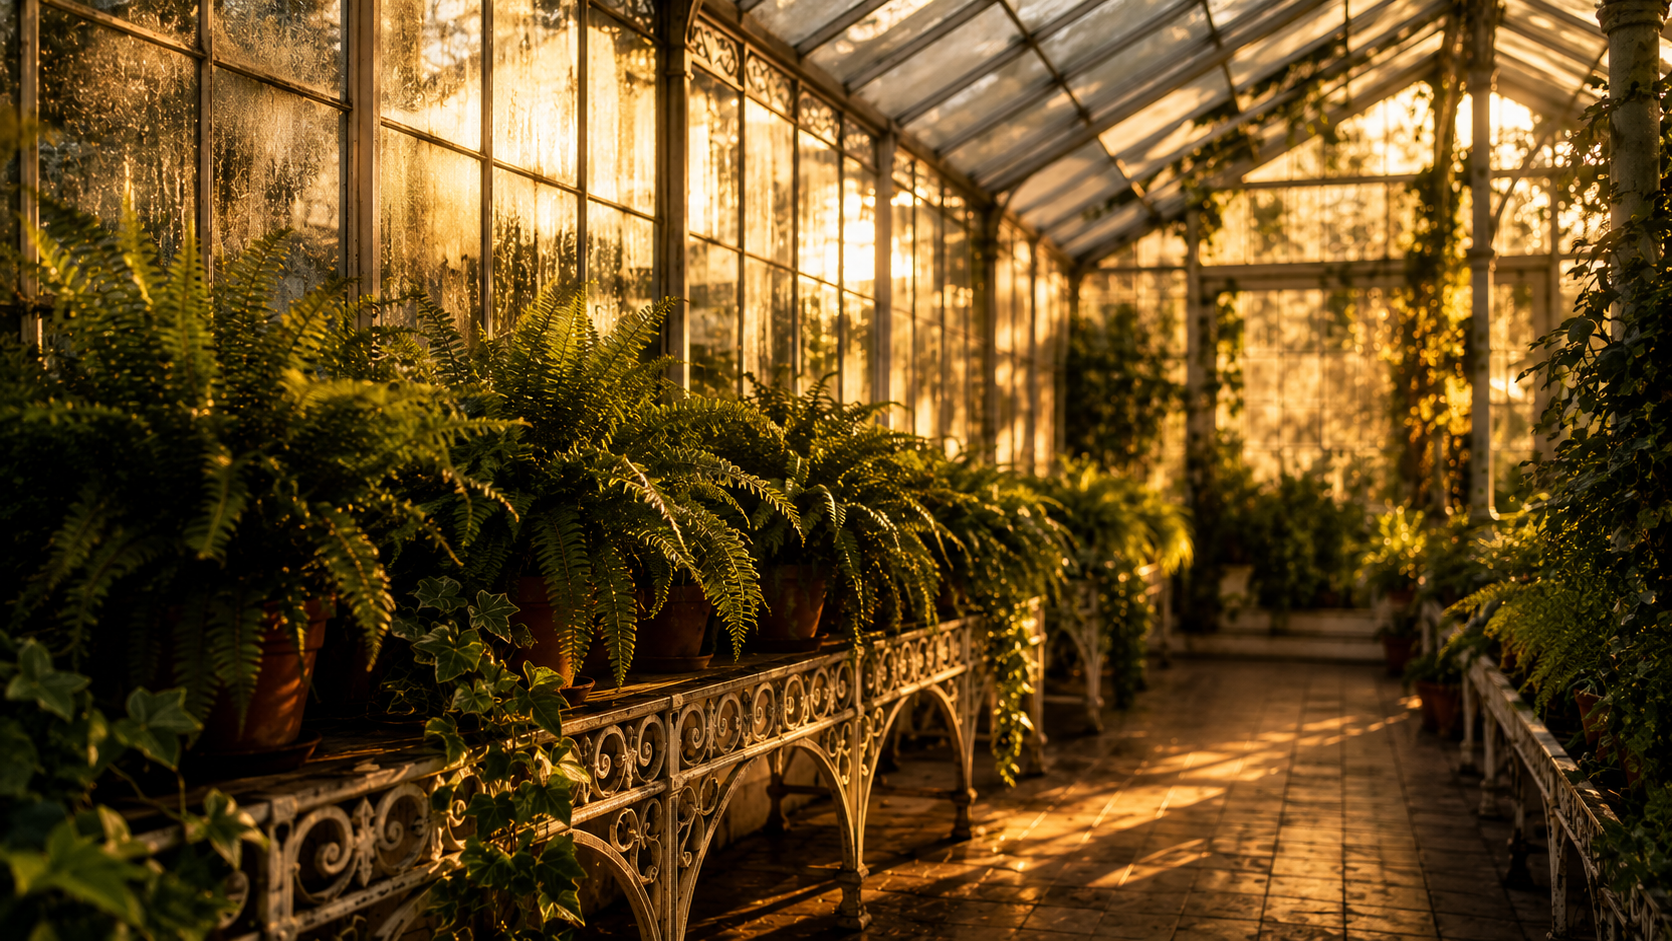
A cinematic still of a glass greenhouse interior at golden hour: long rows of potted ferns and trailing ivy on white iron benches, warm sunlight streaming through dusty glass panes and casting long diagonal shadows across a tiled floor, faint condensation on the windows. Rich green foliage against warm amber light, fine texture in the leaves and glass, shallow depth of field, 16:9 framing, 8K detail, no people, no text overlay.
将此提示词生成两次——一次设定在“黄金时刻(golden hour)”,另一次微调为“黄昏时刻(dusk)”——你就瞬间拥有了配方一所需的完美首尾帧素材。
为什么选择 Fanch AI 进行创作
首尾帧 控制的最终成片上限,直接取决于你喂给它的那两张起始底图有多扎实,而图片正是你在全流程中完全拥有绝对控制权的环节。Fanch AI 拥有专门优化的图像大模型,支持精准的提示词控制,帮助你轻松生成完全成套匹配的起始帧与结束帧——相同的焦段、统一的光影、仅改变单一的核心变量——随后将这组干净的首尾帧无缝对接给你所青睐的视频大模型。